Головна
» Базові знання
»
Як виправити помилку CrashLoopBackOff у Kubernetes у локальному Minikube
Як виправити помилку CrashLoopBackOff у Kubernetes у локальному Minikube
Мета полягає не просто в тому, щоб змусити CrashLoopBackOff зникнути на кілька секунд. Гарне виправлення залишає контейнер працюючим, підтримує стан Ready для пода, коли він повинен обслуговувати трафік, зупиняє зростання лічильника перезапусків і генерує логи, що демонструють нормальний запуск додатка. У локальному Minikube також слід переконатися, що сам кластер Minikube є справним, перш ніж перебудовувати його.
Поточна документація Kubernetes описує CrashLoopBackOff як умову відступу (backoff), яка виникає, коли контейнер повторювано запускається, зазнає збоїв і перезапускається. Kubernetes поступово збільшує затримку перед додатковими перезапусками, щоб уникнути тісного циклу збоїв. Тому цей статус є симптомом повторюваних збоїв контейнера, а не самою кореневою причиною. Див. документацію щодо життєвого циклу Pod у Kubernetes.
Цей посібник використовує чотири діагностичні фази. Виконуйте їх послідовно та зупиняйтеся, коли ідентифікуєте та виправите справжню причину. Minikube призначений для локального навчання та розробки, тому та сама діагностика на рівні додатка переноситься на інші кластери Kubernetes, тоді як кроки відновлення, специфічні для Minikube, не обов’язково застосовні в продакшн-середовищі. Див. поточну документацію щодо запуску Minikube.
Як виглядає успішне виправлення?
Використовуйте спостережувані ознаки, а не лише один зелений рядок статусу:
Задіяний контейнер залишається у стані запуску достатньо довго, щоб завершити нормальний старт.
Pod переходить у стан Ready, якщо від нього очікується обслуговування трафіку.
Лічильник перезапусків перестає зростати протягом періоду спостереження.
kubectl logs показує нормальний шлях запуску, а не повторення тієї ж фатальної помилки.
Проби на живучість (liveness) та запуск (startup), якщо вони налаштовані, перестають падати.
Додаток може отримати доступ до сервісів або залежностей, які йому дійсно потрібні.
minikube status показує справний локальний кластер, якщо стан кластера викликав сумніви.
Не вимагайте, щоб лічильник перезапусків існуючого Pod повернувся до нуля. Kubernetes фіксує, скільки разів контейнер перезапускався в цьому Pod; успішний ремонт може залишити ненульове історичне значення. Важливо те, що лічильник перестає зростати. Якщо розгортання Deployment створює новий Pod, цей новий Pod зазвичай починає з власного свіжого лічильника перезапусків.
Фаза 1: Визначте, який саме контейнер падає
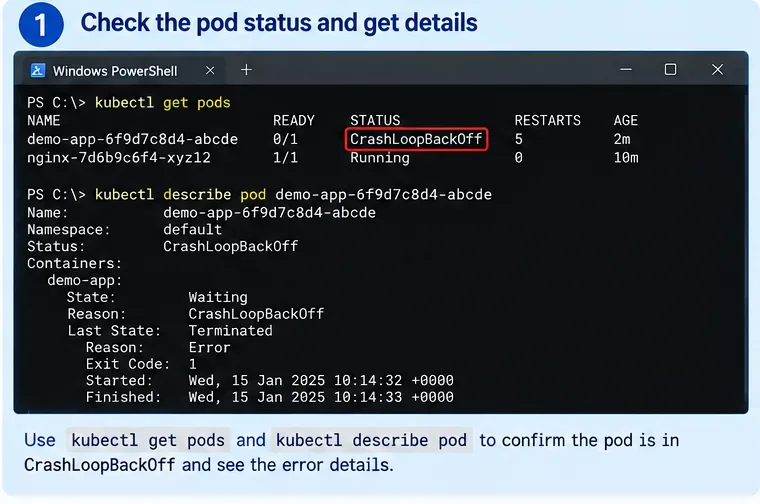
Ілюстрація терміналу для усунення несправностей Kubernetes, згенерована ШІ. Назви, дати та вивід є прикладами, а не скріншотом із реального кластера Minikube.
Почніть зі списку Pod:
kubectl get pods -A
Якщо ви вже знаєте простір імен (namespace), звузьте команду:
kubectl get pods -n my-namespace
Потім опишіть задіяний Pod:
kubectl describe pod <pod-name> -n <namespace>
Зверніть увагу на чотири поля в розділі контейнера:
State — контейнер може зараз перебувати у стані Waiting з причиною CrashLoopBackOff.
Last State — часто Terminated, що вказує на те, що сталося під час попереднього запуску.
Reason and Exit Code — корисні підказки, такі як Error або OOMKilled.
Restart Count та Events — докази того, що збій повторюється, і чи залучені проби або дії kubelet.
Тонка, але корисна відмінність: загальна фаза Pod може все ще бути Running, тоді як один із його контейнерів очікує у стані CrashLoopBackOff. Колонка STATUS, виведена командою kubectl get pods, є зручним людським резюме, а не повною діагностикою стану життєвого циклу Pod.
Перевірка якості: наприкінці цієї фази ви повинні знати точний Pod, простір імен та контейнер, який перезапускається. Якщо Pod має кілька контейнерів, визначте, який саме з них падає, перш ніж читати логи.
Якщо збій насправді не є CrashLoopBackOff
Не намагайтеся підігнати кожну проблему запуску під цей посібник. Стани ImagePullBackOff, ErrImagePull, Pending та ContainerCreating вказують на різні етапи збоїв. Наприклад, проблема з завантаженням образу виникає до того, як запуститься процес вашого додатка, тому логи додатка можуть ще не існувати.
Змініть підхід, коли: розділ Events вказує на завантаження образу, монтування томів, планування або помилки прийняття (admission), а не на контейнер, який запускається та завершує роботу.
Фаза 2: Прочитайте поточні та попередні логи контейнера, що впав
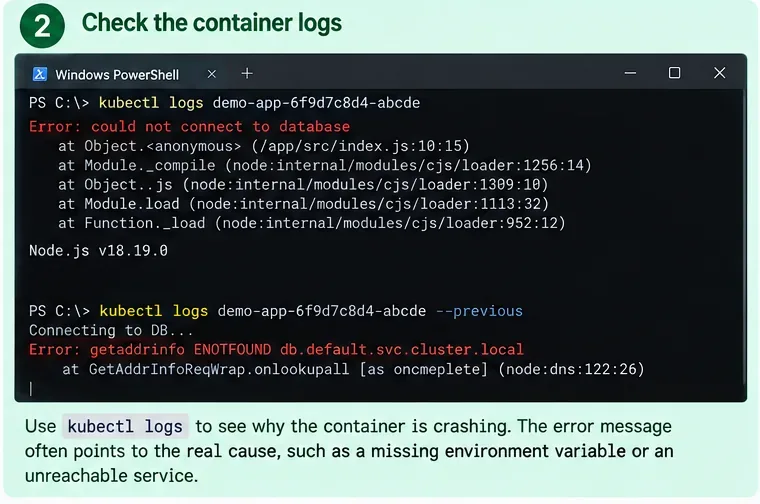
Ілюстрація поточних та попередніх логів контейнера, згенерована ШІ. Повідомлення про помилки є прикладами для демонстрації діагностичного робочого процесу.
Для Pod з одним контейнером почніть з:
kubectl logs <pod-name> -n <namespace>
Коли контейнер швидко перезапускається, найкориснішою командою часто є:
kubectl logs <pod-name> -n <namespace> --previous
Kubernetes документує --previous як опцію, яка виводить логи з попереднього екземпляра контейнера в Pod. Якщо Pod містить більше одного контейнера, вкажіть той, що падає:
Класифікуйте першу значущу фатальну помилку, а не зосереджуйтесь на останньому рядку «process exited». Типові шаблони включають:
Доказ
Ймовірний напрямок
Що перевірити далі
Стек трасування та код завершення 1
Помилка додатка або конфігурації запуску
Перевірте команду, аргументи, середовище, файли та адреси залежностей
Reason: OOMKilled
Контейнер перевищив ліміт пам’яті або був убитий через тиск на пам’ять
Перевірте ліміти, використання пам’яті додатком та потужність Minikube/вузла
Збої проб liveness або startup у Events
Перевірка стану (health check) падає до або після запуску
Перевірте шлях проби, порт, таймінги та тривалість запуску
Помилка DNS або з’єднання з іншим сервісом
Неправильна назва сервісу, простір імен, порт або готовність залежності
Перевірте об’єкти Service та DNS у кластері
Відсутній файл, ключ або змінна середовища
Невідповідність ConfigMap, Secret, монтування або маніфесту
Порівняйте Deployment із посиланнями на об’єкти
Перевірка якості: ви повинні вміти сформулювати фальсифіковану гіпотезу, наприклад, «додаток завершує роботу, тому що DATABASE_HOST вказує на неіснуючий Service», а не просто «Kubernetes зламаний».
Не сприймайте лише код завершення 137 як доказ OOM
Код завершення 137 часто з’являється, коли процес отримує сигнал SIGKILL, але сильнішим специфічним для Kubernetes сигналом є Last State: Terminated з Reason: OOMKilled. Документація Kubernetes щодо управління ресурсами показує цю комбінацію, коли контейнер перевищує свій ліміт пам’яті. Див. документацію Kubernetes щодо управління ресурсами.
Корисна дія: базуйте діагноз на причині завершення роботи та навколишніх подіях (Events), а не лише на числі 137.
Фаза 3: Виправте кореневу причину, а не таймер відступу
Ілюстрація YAML, згенерована ШІ, що показує приклад виправлення конфігурації. Значення полів є ілюстративними та повинні бути адаптовані до реального навантаження.
Коли ви знаєте, чому контейнер завершує роботу, змініть найменшу річ, яка усуняє цю причину. Повторні перезапуски Pod не виправлять погану команду, відсутню конфігурацію, збій перевірки стану або недостатню пам’ять.
Випадок A: додаток намагається отримати доступ до іншого сервісу через localhost
Усередині звичайного Pod Kubernetes контейнери в тому самому Pod спільно використовують мережевий простір імен і можуть спілкуватися один з одним через localhost. База даних, що працює в іншому Pod, не досягається через localhost вашого додатка. Kubernetes створює DNS-імена для сервісів, щоб робочі навантаження могли їх знаходити за назвою сервісу. Див. концепції мережі Kubernetes та DNS для сервісів і Pod.
Якщо ваш сервіс називається postgres у тому самому просторі імен, ваш додаток може використовувати:
DATABASE_HOST=postgres
Між просторами імен використовуйте ім’я з кваліфікацією простору імен, наприклад postgres.data, або повністю кваліфіковане ім’я сервісу, відповідне до домену вашого кластера.
Перевірте сервіс перед редагуванням додатка:
kubectl get svc -A
kubectl get endpointslices -n <namespace>
Змініть підхід, коли: сервіс існує, але не має придатних кінцевих точок (endpoints). У цьому випадку виправлення імені хоста клієнта недостатньо; діагностуйте Deployment сервера або селектор сервісу.
Випадок B: значення ConfigMap або Secret неправильні
Перевірте посилання в маніфесті робочого навантаження:
kubectl get deployment <name> -n <namespace> -o yaml
kubectl get configmap -n <namespace>
kubectl get secret -n <namespace>
Kubernetes підтримує змінні середовища з env, ConfigMap та Secret. Корисна деталь полягає в тому, що значення ConfigMap, спожиті як змінні середовища, не оновлюються в уже запущеному процесі, коли змінюється ConfigMap; Pod повинен бути замінений. Те саме стосується значень Secret, спожитих як змінні середовища. Див. документацію Kubernetes щодо ConfigMap та документацію Kubernetes щодо ін’єкції Secret.
Для Deployment після виправлення конфігурації перезапуск розгортання (rollout restart) є одним зі способів створення нових Pod:
Перевірка якості: переконайтеся, що новий Pod дійсно використовує задумане значення. Не припускайте, що редагування ConfigMap миттєво змінює змінну середовища всередині існуючого контейнера.
Випадок C: проба liveness або startup вбиває повільний додаток
Kubernetes визначає три типи проб з різними цілями:
Проба запуску (Startup probe): визначає, чи завершився запуск додатка. Поки вона активна, проби живучості та готовості чекають.
Проба живучості (Liveness probe): визначає, коли Kubernetes повинен перезапустити завислий або нездоровий контейнер.
Проба готовності (Readiness probe): визначає, чи повинен Pod отримувати трафік через сервіси.
Поширене непорозуміння полягає в тому, що збій проби готовності спричиняє перезапуск. Це не так. Збій готовності робить Pod неготовим; повторювані збої проб живучості або запуску можуть спричинити перезапуски контейнера. Див. концепції проб Kubernetes та офіційний посібник з налаштування проб.
Якщо додатку легітимно потрібен тривалий запуск, розгляньте пробу запуску з достатнім часом failureThreshold × periodSeconds, щоб покрити реалістичний запуск. Не просто вимикайте всі проби, щоб статус виглядав зеленим; це позбавляє корисного захисту стану здоров’я.
Перевірка якості: проба повинна перевіряти умову, яка відображає її призначення, і додаток повинен переживати нормальний запуск, не будучи передчасно вбитим.
Випадок D: контейнер був убитий через OOM (OOMKilled)
Спочатку порівняйте ліміт пам’яті контейнера з його фактичними потребами при запуску. Невеликий приклад:
Якщо з’являється Reason: OOMKilled і додаток легітимно потребує більше, ніж налаштований ліміт, обережно підвищте ліміт або зменшіть використання пам’яті додатком. Якщо самому Minikube бракує пам’яті, збільшення лише ліміту контейнера може просто перенести проблему на вузол.
Поточна документація Minikube стверджує, що стандартна локальна конфігурація очікує щонайменше 2 процесори, 2 ГБ вільної пам’яті та 20 ГБ вільного дискового простору. Minikube також підтримує зміну налаштованої пам’яті кластера, що вимагає перезапуску. Див. поточні вимоги до запуску Minikube.
Змініть підхід, коли: кілька несуміжних Pod падають або виселяються, або сам Minikube є нездоровим. Це вказує на проблему, виходячи за межі ліміту пам’яті одного Deployment.
Фаза 4: Перевірте стабільність і визначте, чи проблема на рівні кластера
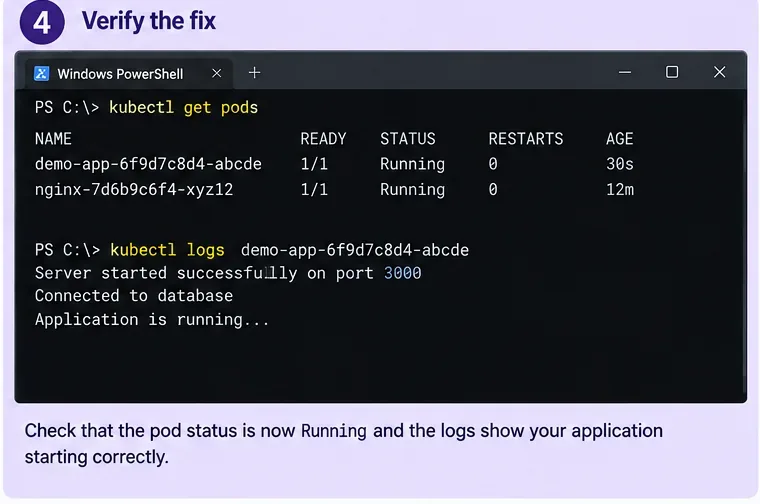
Приклад верифікації, згенерований ШІ. Реальне виправлення слід підтверджувати на основі стану вашого власного Pod, лічильника перезапусків, проб, логів та поведінки додатка.
Після застосування виправлення спостерігайте за робочим навантаженням, а не перевіряйте його лише один раз:
kubectl get pods -n <namespace> -w
Для Deployment:
kubectl rollout status deployment/<name> -n <namespace>
Потім прочитайте нові логи:
kubectl logs <new-pod-name> -n <namespace>
Сильним сигналом успіху є не просто STATUS=Running. Підтвердіть усі наступні пункти, де це доречно:
READY досягає очікуваного значення, наприклад 1/1.
Лічильник перезапусків залишається незмінним, поки ви спостерігаєте нормальний запуск і трафік.
Не з’являються нові події BackOff, збоїв проб або OOM.
Логи додатка показують успішну ініціалізацію.
Сервіс або локальний шлях доступу дійсно досягає додатка.
Якщо додаток все ще падає, перевірте, чи сам Minikube є здоровим
Виконайте:
minikube status
kubectl get pods -A
Команда status Minikube повідомляє стан локального кластера, включаючи стан хоста, kubelet, API-сервера та kubeconfig. Див. офіційну довідку minikube status.
Якщо контрольна площина або основні системні Pod є нездоровими, зберіть діагностику кластера:
minikube logs --problems
minikube logs
Документація Minikube чітко зазначає, що minikube logs призначена для налагодження локального кластера Kubernetes, а не коду вашого додатка. Використовуйте kubectl logs для контейнера додатка та minikube logs, коли підозрюєте кластер або вузол. Див. поточну довідку minikube logs та інструкції з усунення несправностей Minikube.
Змініть підхід, коли: основні компоненти Kubernetes падають, API-сервер недоступний, стан Minikube є нездоровим або багато несуміжних робочих навантажень падають одночасно. У цей момент продовження редагування одного Deployment навряд чи вирішить кореневу проблему.
Чи варто видаляти та створювати кластер Minikube заново?
Лише після того, як ви відокремили проблему додатка від проблеми кластера. Відтворення локального кластера розробки може бути розумним, коли кластер є одноразовим, ваші маніфести відтворювані, а сам Minikube пошкоджений або неправильно налаштований. Це погана перша реакція на додаток, який завершує роботу з чітким трасуванням стека.
Команди, такі як minikube delete, видаляють локальний кластер. Це також може видалити локальний стан Kubernetes та дані, які ви очікували зберегти. Не використовуйте видалення як діагностичний ярлик, коли постійний том, локальна база даних або створений вручну ресурс містять єдину копію чогось важливого.
Поріг якості для переходу до відтворення кластера: ви підтвердили, що збій не пояснюється командою, конфігурацією, залежністю, пробами або лімітами ресурсів робочого навантаження; стан здоров’я Minikube є аномальним; і локальний стан або резервно копіюється, або безпечно відтворюється.
Компактне дерево рішень
Знахідка
Наступна дія
Що ще не робити
Трасування стека додатка в логах --previous
Виправте додаток/конфігурацію, на які вказує помилка
Видаляти кластер Minikube
Reason: OOMKilled
Перевірте ліміти контейнера та пам’ять вузла/Minikube
Вважати всі випадки коду 137 однаковими
Повторювані збої проб liveness/startup
Виправте кінцеву точку, порт, таймінги або дизайн проби запуску
Назавжди вимикати кожну перевірку стану
Проба готовності падає, але контейнер продовжує працювати
Виправте готовність або доступність залежності
Діагностувати це як причину перезапуску без інших доказів
ConfigMap/Secret змінилися, але старе значення середовища залишається
Замініть/перезапустіть Pod після валідації нової конфігурації
Очікувати гарячого перезавантаження змінних середовища процесу
Стан Minikube/основні Pod нездорові
Використовуйте діагностику Minikube та перевірте ресурси кластера
Безкінечно продовжувати редагувати один Deployment додатка
Чого цей робочий процес не може гарантувати
Локальний CrashLoopBackOff може виявити помилку додатка, збій залежності, помилку проби, ліміт ресурсів, невідповідність архітектури, відсутній файл, проблему з дозволами або багато інших збоїв запуску. Жодна фіксована послідовність команд не може ідентифікувати кожну причину без читання фактичної причини завершення роботи, подій (Events) та логів.
Крім того, виправлення, яке працює в Minikube, автоматично не доводить готовність до продакшну. Продакшн-кластери можуть використовувати різні класи сховища, політики безпеки, контролери ingress, архітектури вузлів, мережеві політики, квоти ресурсів, системи секретів або зовнішні сервіси. Minikube цінний для відтворення та розуміння збою на рівні контейнера, але поведінка, специфічна для середовища, все ще повинна тестуватися там, де додаток дійсно працюватиме.
Фінальний чек-лист
Ідентифікуйте точний контейнер, що падає, та простір імен.
Прочитайте Last State, причину завершення, код завершення, лічильник перезапусків та події (Events).
Використовуйте kubectl logs --previous для контейнерів, що швидко перезапускаються.
Перетворіть докази на одну конкретну гіпотезу кореневої причини.
Виправте конфігурацію, адресування залежностей, проби або ресурси на основі цих доказів.
Перезапустіть або розгорніть нові Pod, коли змінюються значення ConfigMap або Secret, засновані на середовищі.
Перевірте стан Ready і підтвердіть, що лічильник перезапусків перестає зростати.
Використовуйте minikube status та minikube logs лише коли стан здоров’я кластера також викликає підозри.
Відтворюйте Minikube лише коли сам кластер є ймовірною проблемою, а одноразовий стан захищено.
Найнадійніший спосіб виправити CrashLoopBackOff — ставитися до нього як до сигналу для розслідування, а не як до діагнозу. У здоровому процесі усунення несправностей кожна команда звужує причину: стан Pod каже вам, що перезапускається, попередні логи кажуть, чому останній запуск завершився невдало, маніфест і події (Events) показують, що Kubernetes просив контейнер зробити, а діагностика Minikube каже, чи залучений сам локальний кластер. Коли ці шари узгоджуються, виправлення зазвичай набагато менше — і набагато легше перевіряється — ніж видалення та перебудова всього.