Domov
» Osnovno znanje
»
Kako odpraviti napako CrashLoopBackOff v Kubernetesu v lokalnem okolju Minikube
Kako odpraviti napako CrashLoopBackOff v Kubernetesu v lokalnem okolju Minikube
Cilj ni le začasno odstraniti napako CrashLoopBackOff za nekaj sekund. Dobra rešitev pusti kontejner v tekočem stanju, ohrani Pod v stanju Ready, ko naj bi prejemal promet, ustavi naraščanje števila ponovnih zagonov in ustvari dnevnike, ki kažejo na normalni zagon aplikacije. V lokalnem okolju Minikube morate pred ponovno vzpostavitvijo potrditi tudi, da je sam klaster Minikube zdrav.
Trenutna dokumentacija Kubernetes opisuje CrashLoopBackOff kot stanje z zamikom, ki se pojavi, ko se kontejner ponavljajoče zaganja, odpove in ponovno zažene. Kubernetes postopoma zamuja dodatne ponovne zagoni, da se izogne tesni zanki napak. Oznaka je zato simptom ponavljajoče se napake kontejnerja, ne pa sama po sebi koren vzroka. Glejte dokumentacijo o življenjskem ciklu Podov v Kubernetesu.
Ta vodnik uporablja štiri diagnostične faze. Sledite jim v navedenem vrstnem redu in ustavite, ko ste identificirali in odpravili dejanski vzrok. Minikube je namenjen lokalnemu učenju in razvoju, zato se enaka diagnostika na ravni aplikacije prenese na druge Kubernetes klastre, medtem ko se koraki za obnovitev, specifični za Minikube, nujno ne nanašajo na produkcijsko okolje. Glejte trenutno dokumentacijo za zagon Minikube.
Kako izgleda uspešna odprava napake?
Uporabite opazljive znake, ne pa zgolj eno samo zeleno vrstico statusa:
Zadevni kontejner ostane v tekočem stanju dovolj dolgo, da zaključi normalni zagon.
Pod postane Ready, če naj bi strežni promet.
Število ponovnih zagonov se v vašem opazovalnem obdobju neha povečevati.
kubectl logs prikazuje normalno pot zagona, namesto ponavljanja iste usodne napake.
Sonde za živost (liveness) in zagon (startup), če so konfigurirane, nehajo spodleteti.
Aplikacija lahko doseže storitve ali odvisnosti, ki jih dejansko potrebuje.
minikube status prikaže zdrav lokalni klaster, kadar je bilo zdravje klastra vprašljivo.
Ne zahtevajte, da se števec ponovnih zagonov obstoječega Poda vrne na nič. Kubernetes beleži, kolikokrat se je kontejner v tem Podu ponovno zagnal; uspešna popravila lahko pustijo neničelno zgodovinsko število. Pomembno je, da se število neha povečevati. Če posodobitev (rollout) Deploymenta ustvari nov Pod, se ta nov Pod običajno začne s svojim svežim števcem ponovnih zagonov.
Faza 1: Dokazati, kateri kontejner se seseda
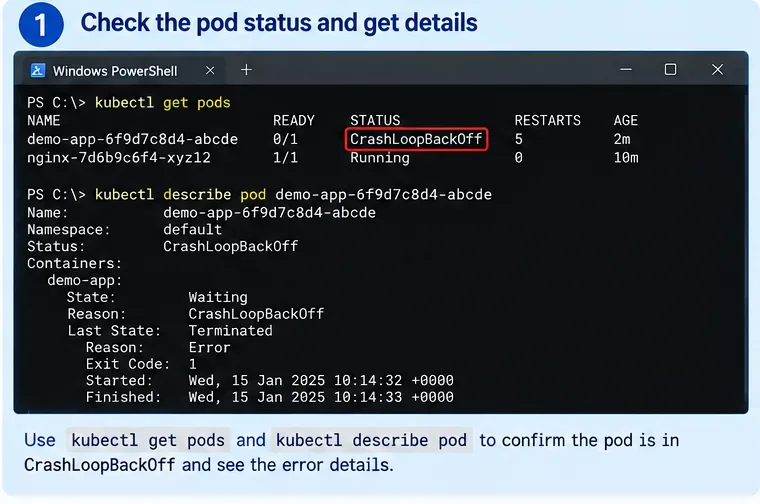
AI-generirana ilustracija terminala za odpravljanje težav v Kubernetesu. Imena, datumi in izpisi so primeri, ne pa posnetek zaslona iz resničnega klastra Minikube.
Začnite s seznamom Podov:
kubectl get pods -A
Če že poznate imenski prostor, zožite ukaz:
kubectl get pods -n my-namespace
Nato opišite zadevni Pod:
kubectl describe pod <pod-name> -n <namespace>
Poglejte štiri polja v razdelku kontejnerja:
State — kontejner je morda trenutno v stanju Waiting z razlogom CrashLoopBackOff.
Last State — pogosto Terminated, kar vam pove, kaj se je zgodilo v prejšnjem zagonu.
Reason and Exit Code — uporabni namigi, kot sta Error ali OOMKilled.
Restart Count in Events — dokazila, da se napaka ponavlja, in ali so vpletena sonda ali dejanja kubeleta.
Subtilna, a uporabna razlika: celotna faza Poda je lahko še vedno Running, medtem ko eden od njegovih kontejnerjev čaka v stanju CrashLoopBackOff. Stolpec STATUS, ki ga izpiše kubectl get pods, je priročen povzetek za človeško branje, ne pa popolna diagnoza stanja življenjskega cikla Poda.
Preverjanje kakovosti: do konca te faze morate poznati točen Pod, imenski prostor in kontejner, ki se ponovno zaganja. Če ima Pod več kontejnerjev, identificirajte, kateri spodleti, preden začnete brati dnevnike.
Če napaka ni dejansko CrashLoopBackOff
Ne poskušajte vsake težave pri zagonu uvrstiti v ta vodnik. ImagePullBackOff, ErrImagePull, Pending in ContainerCreating kažejo na različne faze napake. Na primer, težava pri vlečenju slike se pojavi, preden se začne proces vaše aplikacije, zato aplikacijski dnevniki morda še ne obstajajo.
Spremenite pristop, ko: razdelek Events kaže na vlečenje slik, priklop volumenov, razporejanje (scheduling) ali napake pri sprejemu (admission), namesto na kontejner, ki se zažene in izstopi.
Faza 2: Preberite trenutne in prejšnje dnevnike sesedlega kontejnerja
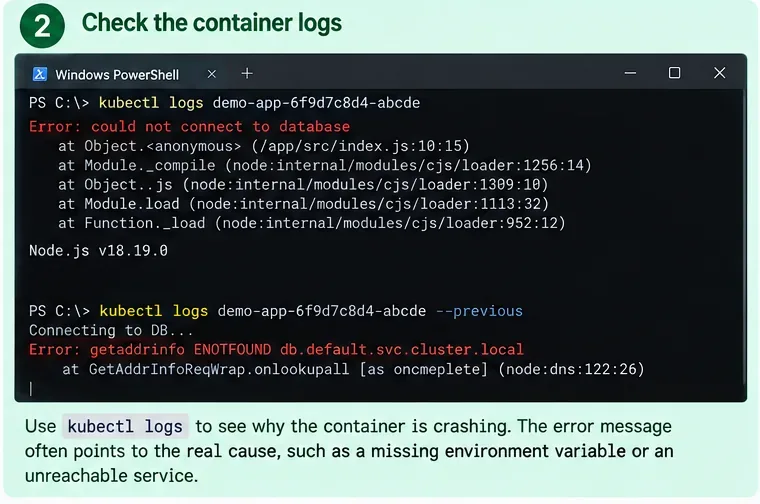
AI-generirana ilustracija trenutnih in prejšnjih dnevnikov kontejnerja. Sporočila o napakah so primeri, uporabljeni za prikaz diagnostičnega poteka dela.
Za Pod z enim kontejnerjem začnite z:
kubectl logs <pod-name> -n <namespace>
Ko se kontejner hitro ponovno zažene, je najbolj uporaben ukaz pogosto:
kubectl logs <pod-name> -n <namespace> --previous
Kubernetes dokumentira --previous kot opcijo, ki izpiše dnevnike iz prejšnje instance kontejnerja v Podu. Če Pod vsebuje več kot en kontejner, navedite tistega, ki spodleti:
Klasificirajte prvo smiselno usodno napako, namesto da bi se osredotočili na končno vrstico “process exited”. Tipični vzorci vključujejo:
Dokazilo
Verjetna smer
Kaj testirati naprej
Skladovna sled (stack trace) in izhodna koda 1
Napaka aplikacije ali konfiguracije zagona
Preverite ukaz, argumente, okolje, datoteke in naslove odvisnosti
Reason: OOMKilled
Kontejner je prekoračil svojo omejitev pomnilnika ali bil ubit zaradi pritiska na pomnilnik
Preglejte omejitve, uporabo pomnilnika aplikacije in zmogljivost vozlišča/Minikube
Napake sond za živost ali zagon v Events
Preverjanje zdravja spodleti pred ali po zagonu
Testirajte pot sonde, vrata, časovnike in trajanje zagona
DNS ali napaka povezave do druge storitve
Napačno ime storitve, imenski prostor, vrata ali pripravljenost odvisnosti
Preglejte objekte Service in DNS znotraj klastra
Manjkajoča datoteka, ključ ali spremenljivka okolja
Neskladje med ConfigMap, Secret, priklopom ali manifestom
Primerjajte Deployment z referenciranimi objekti
Preverjanje kakovosti: morate biti sposobni navesti ponaredljivo hipotezo, kot je “aplikacija izstopi, ker DATABASE_HOST kaže na neobstojočo storitev”, ne zgolj “Kubernetes je pokvarjen”.
Ne obravnavajte izhodne kode 137 same kot dokaz za OOM
Izhodna koda 137 se pogosto pojavi, ko proces prejme SIGKILL, a močnejši signal, specifičen za Kubernetes, je Last State: Terminated z Reason: OOMKilled. Dokumentacija Kubernetes o upravljanju virov prikazuje to kombinacijo, ko kontejner prekorači svojo omejitev pomnilnika. Glejte dokumentacijo Kubernetes o upravljanju virov.
Uporabno dejanje: temeljite diagnozo na razlogu za prekinitev in okoliških dogodkih (Events), ne na številki 137 sami po sebi.
Faza 3: Odpravite koren vzroka, ne časovnika za zamik
AI-generirana ilustracija YAML, ki prikazuje primer popravka konfiguracije. Vrednosti polj so ilustrativne in jih je treba prilagoditi dejanskemu delovnemu bremenu.
Ko veste, zakaj kontejner izstopi, spremenite najmanjšo stvar, ki naslovi ta vzrok. Ponavljajoči se ponovni zagon Poda ne popravi slabega ukaza, manjkajoče konfiguracije, spodletelega preverjanja zdravja ali nezadostnega pomnilnika.
Primer A: Aplikacija poskuša doseči drugo storitev na localhost
Znotraj normalnega Poda v Kubernetesu si kontejnerji v istem Podu delijo omrežni imenski prostor in lahko med seboj komunicirajo prek localhost. Baze podatkov, ki teče v drugem Podu, ne dosežete prek localhost vaše aplikacije. Kubernetes ustvari DNS imena za Storitve, da lahko delovna bremena odkrijejo storitve po imenu. Glejte koncepte omrežja v Kubernetesu in DNS za Storitve in Pode.
Če je vaša storitev poimenovana postgres v istem imenskem prostoru, lahko vaša aplikacija uporabi:
DATABASE_HOST=postgres
Med imenskimi prostori uporabite ime, kvalificirano z imenskim prostorom, kot je postgres.data, ali polno kvalificirano ime storitve, primerno za domeno vašega klastra.
Preverite storitev pred urejanjem aplikacije:
kubectl get svc -A
kubectl get endpointslices -n <namespace>
Spremenite pristop, ko: storitev obstaja, a nima uporabnih zalednih končnih točk. V tem primeru popravek gostiteljskega imena odjemalca ni dovolj; diagnosticirajte strežni Deployment ali selektor storitve.
Primer B: Vrednosti ConfigMap ali Secret so napačne
Preglejte reference v manifestu delovnega bremena:
kubectl get deployment <name> -n <namespace> -o yaml
kubectl get configmap -n <namespace>
kubectl get secret -n <namespace>
Kubernetes podpira spremenljivke okolja iz env, ConfigMap in Secret. Uporaben podatek je, da se vrednosti ConfigMap, porabljene kot spremenljivke okolja, ne posodobijo v že tekočem procesu, ko se ConfigMap spremeni; Pod je treba zamenjati. Enako velja za vrednosti Secret, porabljene kot spremenljivke okolja. Glejte dokumentacijo Kubernetes ConfigMap in dokumentacijo Kubernetes o vbrizgavanju Secret.
Za Deployment je po popravku konfiguracije ponovni zagon (rollout restart) en način za ustvarjanje novih Podov:
Preverjanje kakovosti: potrdite, da novi Pod dejansko uporablja namenjeno vrednost. Ne predpostavljajte, da urejanje ConfigMap takoj spremeni spremenljivko okolja znotraj obstoječega kontejnerja.
Primer C: Sonda za živost ali zagon ubija počasno aplikacijo
Kubernetes definira tri vrste sond z različnimi nameni:
Sonda za zagon (Startup probe): določa, ali je zagon aplikacije zaključen. Medtem ko je aktivna, sonde za živost in pripravljenost čakajo.
Sonda za živost (Liveness probe): določa, kdaj naj Kubernetes ponovno zažene zataknjen ali nezdrav kontejner.
Sonda za pripravljenost (Readiness probe): določa, ali naj Pod prejema promet prek Storitev.
Pogosto napačno razumevanje je, da spodletela sonda za pripravljenost povzroči ponovni zagon. Ne povzroči. Napaka pri pripravljenosti naredi Pod nepripravljen; ponavljajoče se napake sond za živost ali zagon lahko povzročijo ponovne zagon kontejnerjev. Glejte koncepte sond v Kubernetesu in uradni vodnik za konfiguracijo sond.
Če aplikacija upravičeno potrebuje dolg zagon, razmislite o sondi za zagon z dovolj časa (failureThreshold × periodSeconds), da pokrije realističen zagon. Ne onemogočite preprosto vseh sond, da bi status izgledal zelen; to odstrani uporabno zaščito zdravja.
Preverjanje kakovosti: sonda mora testirati pogoj, ki odraža njen namen, aplikacija pa mora preživeti normalni zagon, ne da bi bila prezgodaj ubita.
Primer D: Kontejner je bil OOMKilled
Najprej primerjajte omejitev pomnilnika kontejnerja z njegovimi dejanskimi potrebami pri zagonu. Majhen primer:
Če se pojavi Reason: OOMKilled in aplikacija upravičeno zahteva več kot konfigurirana omejitev, previdno povečajte omejitev ali zmanjšajte uporabo pomnilnika aplikacije. Če Minikube sam trpi zaradi pomanjkanja pomnilnika, lahko povečanje omejitve kontejnerja zgolj prenese težavo na vozlišče.
Trenutna dokumentacija Minikube pravi, da standardna lokalna namestitev pričakuje vsaj 2 CPU, 2 GB prostega pomnilnika in 20 GB prostega prostora na disku. Minikube podpira tudi spreminjanje konfiguriranega pomnilnika klastra, kar zahteva ponovni zagon. Glejte trenutne zahteve za zagon Minikube.
Spremenite pristop, ko: več nepovezanih Podov spodleti ali je izgnanih (evicted), ali pa je Minikube sam nezdrav. To kaže na težavo, ki presega omejitev pomnilnika enega samega Deploymenta.
Faza 4: Preverite stabilnost in se odločite, ali je težava na ravni klastra
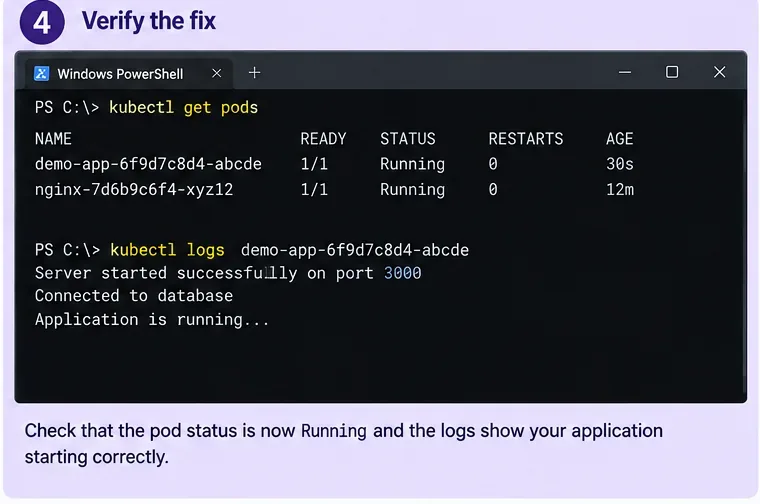
AI-generiran primer preverjanja. Dejanski popravek je treba potrditi iz stanja vašega Poda, števca ponovnih zagonov, sond, dnevnikov in obnašanja aplikacije.
Po uporabi popravka spremljajte delovno breme, namesto da bi ga preverili samo enkrat:
kubectl get pods -n <namespace> -w
Za Deployment:
kubectl rollout status deployment/<name> -n <namespace>
Nato preberite nove dnevnike:
kubectl logs <new-pod-name> -n <namespace>
Močan signal uspeha ni zgolj STATUS=Running. Potrdite vse naslednje, kjer je primerno:
READY doseže pričakovano vrednost, kot je 1/1.
Števec ponovnih zagonov ostane nespremenjen, medtem ko opazujete normalni zagon in promet.
Ne pojavijo se novi dogodki BackOff, napake sond ali OOM.
Dnevniki aplikacije kažejo uspešno inicializacijo.
Storitev ali lokalna pot dostopa dejansko doseže aplikacijo.
Če aplikacija še vedno spodleti, preverite, ali je Minikube sam zdrav
Zaženite:
minikube status
kubectl get pods -A
Ukaz status v Minikube poroča o stanju lokalnega klastra, vključno s stanjem gostitelja, kubeleta, API strežnika in kubeconfig. Glejte uradno referenco za minikube status.
Če so nadzorna ravnina (control plane) ali osnovni sistemski Podi nezdravi, zberite diagnostiko klastra:
minikube logs --problems
minikube logs
Dokumentacija Minikube je eksplicitna, da je minikube logs namenjen odpravljanju težav lokalnega Kubernetes klastra, ne kode vaše uporabniške aplikacije. Uporabite kubectl logs za aplikacijski kontejner in minikube logs, kadar je sumljiv klaster ali vozlišče samo. Glejte trenutno referenco za minikube logs in smernice za odpravljanje težav v Minikube.
Spremenite pristop, ko: osnovne komponente Kubernetes spodletijo, API strežnik ni na voljo, status Minikube je nezdrav ali pa več nepovezanih delovnih bremen spodleti hkrati. V tem trenutku nadaljnje urejanje enega samega Deploymenta verjetno ne bo rešilo osnovne težave.
Ali bi morali izbrisati in ponovno ustvariti klaster Minikube?
Šele potem, ko ste ločili težavo aplikacije od težave klastra. Ponovna vzpostavitev lokalnega razvojnega klastra je lahko smiselna, kadar je klaster za enkratno uporabo, vaši manifesti so ponovljivi in je Minikube sam pokvarjen ali napačno konfiguriran. To je slabo prvo odzivanje na aplikacijo, ki izstopi z jasno skladovno sledjo.
Ukazi, kot je minikube delete, odstranijo lokalni klaster. To lahko odstrani tudi lokalno stanje Kubernetes in podatke, za katere ste pričakovali, da jih boste obdržali. Ne uporabljajte brisanja kot bližnjice za diagnostiko, kadar trajni volumen, lokalna baza podatkov ali ročno ustvarjen vir vsebuje edino kopijo nečesa pomembnega.
Prag kakovosti za prehod na ponovno vzpostavitev klastra: potrdili ste, da napake ne pojasnjuje ukaz delovnega bremena, konfiguracija, odvisnost, sonde ali omejitve virov; zdravje Minikube je nenormalno; in lokalno stanje je bodisi varnostno kopirano bodisi varno ponovljivo.
Kompaktno drevo odločitev
Ugotovitev
Naslednji korak
Česa še ne storite
Skladovna sled aplikacije v dnevnikih --previous
Popravite aplikacijo/konfiguracijo, ki jo kaže napaka
Izbrišite klaster Minikube
Reason: OOMKilled
Preverite omejitve kontejnerja in pomnilnik vozlišča/Minikube
Predpostavite, da so vsi primeri izhoda 137 identični
Ponavljajoče se napake sond za živost/zagon
Popravite končno točko, vrata, časovnike ali zasnovo sonde za zagon
Trajno onemogočite vsako preverjanje zdravja
Sonda za pripravljenost spodleti, a kontejner teče naprej
Popravite pripravljenost ali razpoložljivost odvisnosti
Diagnostificirajte kot vzrok za ponovni zagon brez drugih dokazil
ConfigMap/Secret se je spremenil, a stara vrednost okolja ostaja
Zamenjajte/ponovno zaženite Pod po validaciji nove konfiguracije
Pričakujte, da se spremenljivke okolja procesa vroče naložijo
Status Minikube/osnovni Podi so nezdravi
Uporabite diagnostiko Minikube in preglejte vire klastra
Neskončno nadaljujte z urejanjem enega samega Deploymenta aplikacije
Kaj ta potek dela ne more zagotoviti
Lokalni CrashLoopBackOff lahko razkrije hrošč aplikacije, napako odvisnosti, napako sonde, omejitev virov, neskladje arhitekture, manjkajočo datoteko, težavo z dovoljenji ali mnoge druge napake pri zagonu. Nobeno fiksno zaporedje ukazov ne more identificirati vsakega vzroka brez branja dejanskega razloga za prekinitev, dogodkov (Events) in dnevnikov.
Poleg tega popravek, ki deluje v Minikube, samodejno ne dokazuje pripravljenosti za produkcijo. Produkcijski klasterji lahko uporabljajo različne razrede shrambe, varnostne politike, kontrolerje vhoda (ingress), arhitekture vozlišč, omrežne politike, kvote virov, sisteme za skrivnosti ali zunanje storitve. Minikube je dragocen za ponovno ustvarjanje in razumevanje napake na ravni kontejnerja, a obnašanje, specifično za okolje, je treba še vedno testirati tam, kjer bo aplikacija dejansko tekel.
Končni kontrolni seznam
Identificirajte točen spodleteli kontejner in imenski prostor.
Preberite Last State, razlog za prekinitev, izhodno kodo, število ponovnih zagonov in dogodke (Events).
Uporabite kubectl logs --previous za kontejnerje, ki se hitro ponovno zaganjajo.
Pretvorite dokazila v eno specifično hipotezo o korenovem vzroku.
Popravite konfiguracijo, naslavljanje odvisnosti, sonde ali vire na podlagi teh dokazil.
Ponovno zaženite ali razširite nove Pode, ko se spremenijo vrednosti ConfigMap ali Secret, temelječe na okolju.
Preverite stanje Ready in potrdite, da se število ponovnih zagonov neha povečevati.
Uporabite minikube status in minikube logs le, kadar je tudi zdravje klastra sumljivo.
Ponovno vzpostavite Minikube le, kadar je klaster sam verjeten vzrok težave in je za enkratno uporabno stanje zaščiteno.
Najbolj zanesljiv način za odpravo CrashLoopBackOff je, da ga obravnavate kot signal za preiskavo, ne kot diagnozo. V zdravem procesu odpravljanja težav vsak ukaz zoži vzrok: stanje Poda vam pove, kaj se ponovno zaganja, prejšnji dnevniki vam povedo, zakaj je zadnji zagon spodletel, manifest in dogodki (Events) pokažejo, kaj je Kubernetes zahteval od kontejnerja, diagnostika Minikube pa vam pove, ali je vpleten sam lokalni klaster. Ko se ti sloji strinjajo, je popravek običajno veliko manjši – in veliko lažje preverljiv – kot brisanje in ponovna gradnja vsega.