Kaip išspręsti Kubernetes CrashLoopBackOff klaidą vietiniame Minikube
Tikslas nėra tik padaryti, kad CrashLoopBackOff dingtų kelioms sekundėms. Geras sprendimas palieka konteinerį veikiantį, išlaiko Pod būseną „Ready“, kai jis turėtų priimti srautą, sustabdo perkrovimų skaičiaus didėjimą ir sukuria žurnalus, rodančius normalų programos paleidimą. Vietiniame Minikube taip pat turėtumėte įsitikinti, kad pats Minikube klasteris yra sveikas, prieš jį perkonfigūruodami.
Dabartinė Kubernetes dokumentacija apibūdina CrashLoopBackOff kaip atidėjimo būseną, kuri atsiranda, kai konteineris kartojasi paleidžiamas, sugenda ir yra perkraunamas. Kubernetes palaipsniui atideda papildomus perkrovimus, kad išvengtų glaudaus gedimo ciklo. Todėl šis žymėjimas yra kartotinio konteinerio gedimo simptomas, o ne pati pagrindinė priežastis. Žr. Kubernetes Pod gyvavimo ciklo dokumentaciją.
Šiame vadove naudojami keturi diagnostikos etapai. Vykdykite juos iš eilės ir sustokite, kai nustatysite ir ištaisysite tikrąją priežastį. Minikube skirtas vietiniam mokymuisi ir kūrimui, todėl tas pats programos lygmens diagnostikos metodas tinka ir kitiems Kubernetes klasteriams, tačiau Minikube specifiniai atkūrimo veiksmai nebūtinai taikomi gamybos aplinkoje. Žr. dabartinę Minikube paleidimo dokumentaciją.
Kaip atrodo sėkmingas sutvarkymas?
Naudokite stebimus požymius, o ne vieną žalią būsenos eilutę:
Pažeistas konteineris lieka veikimo būsenoje pakankamai ilgai, kad užbaigtų normalų paleidimą.
Pod tampa Ready, jei jis turi aptarnauti srautą.
Perkrovimų skaičius nustoja didėti stebėjimo laikotarpiu.
kubectl logs rodo normalų paleidimo kelią, o ne tą pačią mirtiną klaidą kartojant.
Gyvavimo ir paleidimo zondai, jei sukonfigūruoti, nustoja klupti.
Programa gali pasiekti paslaugas ar priklausomybes, kurių jai iš tikrųjų reikia.
minikube status rodo sveiką vietinį klasterį, kai buvo abejojama klasterio sveikata.
Nereikalaukite, kad esamo Pod perkrovimų skaitiklis grįžtų į nulį. Kubernetes fiksuoja, kiek kartų konteineris buvo perkrautas tame Pod; sėkmingas remontas gali palikti nulinį ne istorinį skaičių. Svarbu, kad skaičius nustoja didėti. Jei Deployment diegimas sukuria naują Pod, tas naujas Pod paprastai prasideda su savo nauju perkrovimų skaičiumi.
1 etapas: Įrodykite, kuris konteineris žūva
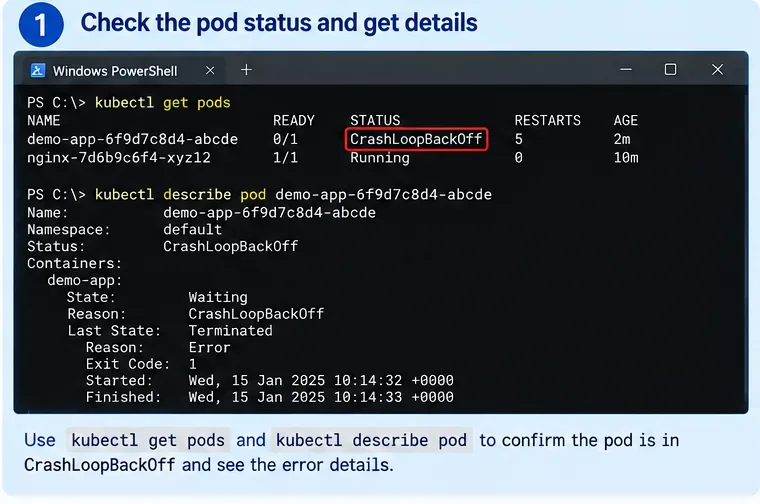
AI sugeneruota Kubernetes trikčių šalinimo terminalo iliustracija. Pavadinimai, datos ir išvestis yra pavyzdžiai, o ne tikro Minikube klasterio ekrano kopija.
Pradėkite nuo Pod sąrašo:
kubectl get pods -A
Jei jau žinote vardų erdvę (namespace), susiaurinkite komandą:
kubectl get pods -n my-namespace
Tada aprašykite pažeistą Pod:
kubectl describe pod <pod-name> -n <namespace>
Pažiūrėkite į keturis laukus konteinerio sekcijoje:
State — konteineris gali šiuo metu būti Waiting būsenoje su priežastimi CrashLoopBackOff.
Last State — dažnai Terminated, kas parodo, kas įvyko ankstesnio paleidimo metu.
Reason and Exit Code — naudingos užuominos, tokios kaip Error ar OOMKilled.
Restart Count ir Events — įrodymai, kad gedimas kartojasi, ir ar dalyvauja zondai, ar kubelet veiksmai.
Subtilus, bet naudingas skirtumas: bendra Pod fazė gali vis dar būti Running, nors vienas iš jos konteinerių laukia CrashLoopBackOff būsenoje. kubectl get pods atspausdintas STATUS stulpelis yra patogus žmogui skirtas santrauka, o ne pilna Pod gyvavimo būsenos diagnostika.
Kokybės patikra: iki šio etapo pabaigos turėtumėte žinoti tikslų Pod, vardų erdvę ir konteinerį, kuris yra perkraunamas. Jei Pod turi kelis konteinerius, nustatykite, kuris iš jų sugenda, prieš skaitydami žurnalus.
Jei gedimas iš tikrųjų nėra CrashLoopBackOff
Nebandykite visų paleidimo problemų pritempti prie šio vadovo. ImagePullBackOff, ErrImagePull, Pending ir ContainerCreating rodo skirtingus gedimo etapus. Pavyzdžiui, atvaizdo atsisiuntimo problema įvyksta prieš pradedant jūsų programos procesą, todėl programos žurnalų gali dar neegzistuoti.
Pakeiskite metodą, kai: Events sekcija rodo į atvaizdų traukimą, tomų montavimą, planavimą ar priėmimo klaidas, o ne į konteinerį, kuris paleidžiamas ir išeina.
2 etapas: Perskaitykite sugedusio konteinerio dabartinius ir ankstesnius žurnalus
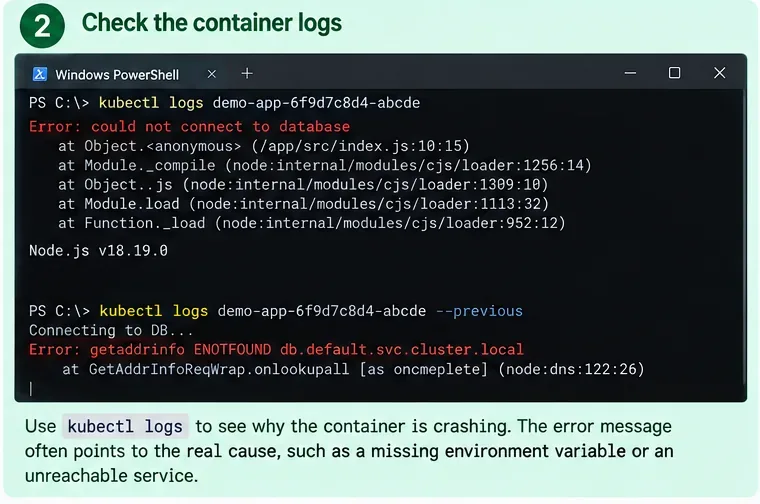
AI sugeneruota dabartinių ir ankstesnių konteinerio žurnalų iliustracija. Klaidų pranešimai yra pavyzdžiai, naudojami diagnostikos darbo eigai demonstruoti.
Vieno konteinerio Pod pradėkite nuo:
kubectl logs <pod-name> -n <namespace>
Kai konteineris greitai perkraunasi, dažniausiai naudingiausia komanda yra:
kubectl logs <pod-name> -n <namespace> --previous
Kubernetes dokumentuoja --previous kaip opciją, kuri atspausdina žurnalus iš ankstesnio konteinerio instancijos Pod. Jei Pod turi daugiau nei vieną konteinerį, nurodykite sugedusįjį:
Klasifikuokite pirmąją reikšmingą mirtiną klaidą, o ne fokusuokitės į galutinę „process exited“ eilutę. Tipiniai modeliai apima:
Įrodymai
Tikėtina kryptis
Ką testuoti toliau
Stack trace kartu su išėjimo kodu 1
Programos ar paleidimo konfigūracijos klaida
Patikrinkite komandą, argumentus, aplinką, failus ir priklausomybių adresus
Reason: OOMKilled
Konteineris viršijo savo atminties limitą arba buvo nužudytas dėl atminties spaudimo
Tikrinkite limitus, programos atminties naudojimą ir Minikube/mazgo talpą
Gyvavimo ar paleidimo zondų nesėkmės Events
Būsenos tikrinimas nepavyksta prieš arba po paleidimo
Testuokite zondo kelią, prievadą, laikinimą ir paleidimo trukmę
DNS arba ryšio klaida su kita paslauga
Neteisingas paslaugos pavadinimas, vardų erdvė, prievadas ar priklausomybės paruoštumas
Tikrinkite Service objektus ir klasterio viduje esantį DNS
Trūkstamas failas, raktas ar aplinkos kintamasis
ConfigMap, Secret, montavimo ar manifestų neatitikimas
Palyginkite Deployment su nurodytais objektais
Kokybės patikra: turėtumėte galėti suformuluoti paneigiamą hipotezę, pvz., „programa išeina, nes DATABASE_HOST nukreipta į neegzistuojančią Service“, o ne vien „Kubernetes yra sugedęs“.
Nelaikykite vien išėjimo kodo 137 įrodymu apie OOM
Išėjimo kodas 137 dažnai pasitaiko, kai procesas gauna SIGKILL, tačiau stipresnis Kubernetes specifinis signalas yra Last State: Terminated su Reason: OOMKilled. Kubernetes išteklių valdymo dokumentacija rodo šią kombinaciją, kai konteineris viršija savo atminties limitą. Žr. Kubernetes išteklių valdymo dokumentaciją.
Naudingas veiksmas: pagrįskite diagnozę nutraukimo priežastimi ir aplinkiniais Events, o ne pačiu skaičiumi 137.
3 etapas: Taisykite pagrindinę priežastį, o ne atidėjimo laikmatį
AI sugeneruota YAML iliustracija, rodanti pavyzdinį konfigūracijos taisymą. Laukų reikšmės yra iliustracinės ir turi būti pritaikytos tikrajam darbui.
Kai žinote, kodėl konteineris išeina, pakeiskite mažiausią dalyką, kuris šalina tą priežastį. Pod kartotinis perkrovimas nepataiso blogos komandos, trūkstamos konfigūracijos, nepavykusio būsenos tikrinimo ar nepakankamos atminties.
Atvejis A: programa bando pasiekti kitą paslaugą per localhost
Įprastame Kubernetes Pod, tame pačiame Pod esantys konteineriai dalijasi tinklo vardų erdve ir gali bendrauti tarpusavyje per localhost. Duomenų bazė, veikianti kitame Pod, nepasiekiama per jūsų programos localhost. Kubernetes sukuria DNS pavadinimus Service objektams, kad dariniai galėtų juos atrasti pagal paslaugos pavadinimą. Žr. Kubernetes tinklo koncepcijas ir DNS Service ir Pod.
Jei jūsų Service pavadinimas yra postgres toje pačioje vardų erdvėje, jūsų programa gali naudoti:
DATABASE_HOST=postgres
Per skirtingas vardų erdves naudokite vardų erdvę nurodantį pavadinimą, pvz., postgres.data, arba pilną paslaugos pavadinimą, tinkamą jūsų klasterio domenui.
Patikrinkite Service prieš redaguodami programą:
kubectl get svc -A
kubectl get endpointslices -n <namespace>
Pakeiskite metodą, kai: Service egzistuoja, bet neturi naudojamų galinių taškų (backend endpoints). Tokiu atveju kliento hostname taisymas nepakanka; diagnozuokite serverio Deployment arba Service selector.
Atvejis B: ConfigMap arba Secret reikšmės yra neteisingos
Tikrinkite nuorodas darbo krūvio manifeste:
kubectl get deployment <name> -n <namespace> -o yaml
kubectl get configmap -n <namespace>
kubectl get secret -n <namespace>
Kubernetes palaiko aplinkos kintamuosius iš env, ConfigMaps ir Secrets. Naudinga detalė yra ta, kad ConfigMap reikšmės, naudojamos kaip aplinkos kintamieji, ne yra atnaujinamos jau veikiančiame procese, kai ConfigMap pasikeičia; Pod turi būti pakeistas. Tas pats taikoma Secret reikšmėms, naudojamoms kaip aplinkos kintamieji. Žr. Kubernetes ConfigMap dokumentaciją ir Kubernetes Secret įterpimo dokumentaciją.
Deployment atveju, po konfigūracijos koregavimo, rollout restart yra vienas būdas sukurti naujus Pod:
Kokybės patikra: patikrinkite, ar naujas Pod iš tikrųjų naudoja numatytąją reikšmę. Nelaikykite savaime suprantamu, kad ConfigMap redagavimas akimirksniu pakeičia aplinkos kintamąjį esamo konteinerio viduje.
Atvejis C: gyvavimo arba paleidimo zondas žudo lėtą programą
Kubernetes apibrėžia trijų tipų zondus su skirtinga paskirtimi:
Paleidimo zondas (Startup probe): nustato, ar programos paleidimas yra užbaigtas. Kol jis aktyvus, gyvavimo ir paruoštumo zondai laukia.
Gyvavimo zondas (Liveness probe): nustato, kada Kubernetes turėtų perkrauti užstrigusį ar nesveiką konteinerį.
Paruoštumo zondas (Readiness probe): nustato, ar Pod turėtų gauti srautą per Services.
Dažnas nesusipratimas yra tas, kad nepavykęs paruoštumo zondas sukelia perkrovimą. Taip nėra. Paruoštumo nesėkmė padaro Pod neparengtą; kartotinės gyvavimo ar paleidimo zondų nesėkmės gali sukelti konteinerio perkrovimus. Žr. Kubernetes zondų koncepcijas ir oficialų zondų konfigūravimo vadovą.
Jei programai teisėtai reikia ilgo paleidimo, apsvarstykite paleidimo zondą su pakankamu failureThreshold × periodSeconds laiku, kad apimtų realų paleidimą. Tiesiog neišjunkite visų zondų, kad būsena atrodytų žalia; tai pašalina naudingą sveikatos apsaugą.
Kokybės patikra: zondas turėtų tikrinti sąlygą, atitinkančią jo paskirtį, o programa turėtų išgyventi normalų paleidimą nebūdama per anksti nužudyta.
Atvejis D: konteineris yra OOMKilled
Pirmiausia palyginkite konteinerio atminties limitą su jo faktiniais paleidimo poreikiais. Mažas pavyzdys:
Jei pasirodo Reason: OOMKilled ir programa teisėtai reikalauja daugiau nei sukonfigūruotas limitas, atsargiai padidinkite limitą arba sumažinkite programos atminties naudojimą. Jei pačiam Minikube trūksta atminties, tik konteinerio limito didinimas gali tiesiog perkelti problemą į mazgą.
Dabartinė Minikube dokumentacija teigia, kad standartinė vietinė sąranka tikisi bent 2 CPU, 2 GB laisvos atminties ir 20 GB laisvos disko vietos. Minikube taip pat palaiko sukonfigūruoto klasterio atminties keitimą, tam reikia perkrovimo. Žr. Minikube dabartinius paleidimo reikalavimus.
Pakeiskite metodą, kai: keli nepriklausomi Pod žūva arba yra išstumiami, arba pats Minikube yra nesveikas. Tai rodo problemą, viršijančią vieno Deployment atminties limitą.
4 etapas: Patvirtinkite stabilumą ir nuspręskite, ar problema yra klasterio lygmens
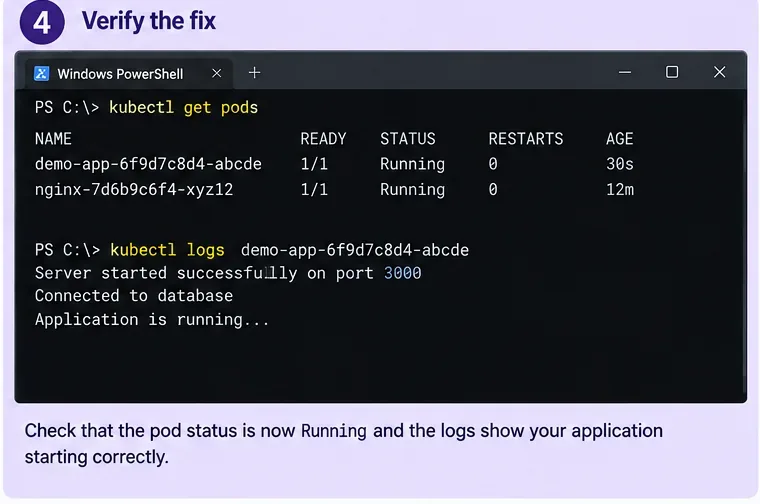
AI sugeneruotas patvirtinimo pavyzdys. Tikras taisymas turėtų būti patvirtintas iš jūsų pačių Pod būsenos, perkrovimų skaičiaus, zondų, žurnalų ir programos elgsenos.
Pritaikę taisymą, stebėkite darbo krūvį, o ne tikrinkite jį tik vieną kartą:
kubectl get pods -n <namespace> -w
Deployment:
kubectl rollout status deployment/<name> -n <namespace>
Tada perskaitykite naujus žurnalus:
kubectl logs <new-pod-name> -n <namespace>
Stiprus sėkmės signalas nėra vien STATUS=Running. Patvirtinkite visus šiuos dalykus, jei taikoma:
READY pasiekia tikėtiną reikšmę, pvz., 1/1.
Perkrovimų skaičius lieka nepakitęs, kol stebite normalų paleidimą ir srautą.
Nepasirodo naujų BackOff, zondo nesėkmės ar OOM įvykių.
Programos žurnalai rodo sėkmingą inicializaciją.
Service arba vietinė prieigos priemonė iš tikrųjų pasiekia programą.
Jei programa vis tiek žūva, patikrinkite, ar pats Minikube yra sveikas
Vykdykite:
minikube status
kubectl get pods -A
Minikube status komanda praneša apie vietinio klasterio būseną, įskaitant host, kubelet, API serverį ir kubeconfig būseną. Žr. oficialią minikube status nuorodą.
Jei valdymo plokštė arba pagrindiniai sistemos Pod yra nesveiki, surinkite klasterio diagnostikos duomenis:
minikube logs --problems
minikube logs
Minikube dokumentacija aiškiai nurodo, kad minikube logs skirtas vietiniam Kubernetes klasteriui derinti, o ne jūsų vartotojo programos kodui. Naudokite kubectl logs programos konteineriui ir minikube logs, kai įtariamas klasteris arba pats mazgas. Žr. dabartinę minikube logs nuorodą ir Minikube trikčių šalinimo gaires.
Pakeiskite metodą, kai: pagrindiniai Kubernetes komponentai žūva, API serveris neprieinamas, Minikube būsena nesveika arba daug nepriklausomų darbo krūvių žūva vienu metu. Tuo metu tolesnis vieno Deployment redagavimas greičiausiai neišspręs pagrindinės problemos.
Ar turėtumėte ištrinti ir iš naujo sukurti Minikube klasterį?
Tik tada, kai atskirėte programos problemą nuo klasterio problemos. Vietinio kūrimo klasterio perkonfigūravimas gali būti pagrįstas, kai klasteris yra vienkartinis, jūsų manifestai yra atkartojami, o pats Minikube yra sugadintas arba neteisingai sukonfigūruotas. Tai yra blogas pirmasis atsakas į programą, kuri išeina su aiškiu stack trace.
Tokios komandos kaip minikube delete pašalina vietinį klasterį. Tai taip pat gali pašalinti vietinę Kubernetes būseną ir duomenis, kuriuos tikėjotės išsaugoti. Nenaudokite trynimo kaip diagnostinio trumpkelio, kai nuolatinis tomas, vietinė duomenų bazė arba rankiniu būdu sukurtas išteklius turi vienintelę svarbių dalykų kopiją.
Kokybės slenkstis pereinant prie klasterio perkonfigūravimo: patvirtinote, kad gedimo nepaaiškina darbo krūvio komanda, konfigūracija, priklausomybė, zondai ar išteklių limitai; Minikube sveikata yra nenormali; ir vietinė būsena yra arba atsarguota, arba saugiai atkartojama.
Tikrinkite konteinerio limitus ir mazgo/Minikube atmintį
Daryti prielaidą, kad visi 137 išėjimo atvejai yra identiški
Kartojamos gyvavimo/paleidimo zondų nesėkmės
Taisykite galinį tašką, prievadą, laikinimą arba paleidimo zondo dizainą
Išjungti visus sveikatos tikrinimus visam laikui
Paruoštumo zondas žūva, bet konteineris toliau veikia
Taisykite paruoštumą arba priklausomybės prieinamumą
Diagnozuoti tai kaip perkrovimo priežastį be kitų įrodymų
ConfigMap/Secret pasikeitė, bet sena env reikšmė lieka
Pakeiskite/perkraukite Pod po naujos konfigūracijos patvirtinimo
Tikėtis, kad proceso aplinkos kintamieji bus perkrauti „karštuoju būdu“
Minikube status/pagrindiniai Pod nesveiki
Naudokite Minikube diagnostiką ir tikrinkite klasterio išteklius
Toliau neribotai redaguoti vieno programos Deployment
Ko šis darbo eigos negali garantuoti
Vietinis CrashLoopBackOff gali atskleisti programos klaidą, priklausomybės gedimą, zondo klaidą, išteklių limitą, architektūros neatitikimą, trūkstamą failą, leidimų problemą ar daugelį kitų paleidimo gedimų. Jokia fiksuota komandų seka negali nustatyti kiekvienos priežasties neperskaičius faktinės nutraukimo priežasties, Events ir žurnalų.
Taip pat, taisymas, kuris veikia Minikube, automatiškai neprodukcijos paruoštumo. Gamybos klasteriai gali naudoti skirtingas saugyklos klases, saugumo politikas, ingress valdiklius, mazgų architektūras, tinklo politikas, išteklių kvotas, slaptažodžių sistemas ar išorines paslaugas. Minikube yra vertingas konteinerio lygmens gedimo atkūrimui ir supratimui, tačiau aplinkai specifinis elgesys vis tiek turi būti testuojamas ten, kur programa iš tikrųjų veiks.
Galutinis sąrašas
Nustatykite tikslų sugedusį konteinerį ir vardų erdvę.
Perskaitykite Last State, nutraukimo priežastį, išėjimo kodą, perkrovimų skaičių ir Events.
Naudokite kubectl logs --previous greitai besikraunantiems konteineriams.
Paverskite įrodymus viena konkrečia pagrindinės priežasties hipoteze.
Taisykite konfigūraciją, priklausomybių adresavimą, zondus arba išteklius remiantis tais įrodymais.
Perkraukite arba išleiskite naujus Pod, kai pasikeičia aplinkos pagrindu paremtos ConfigMap arba Secret reikšmės.
Patvirtinkite Ready būseną ir įsitikinkite, kad perkrovimų skaičius nustoja didėti.
Naudokite minikube status ir minikube logs tik tada, kai taip pat įtariama klasterio sveikata.
Perkonfigūruokite Minikube tik tada, kai pats klasteris yra tikėtina problema ir vienkartinė būsena yra apsaugota.
Patikimiausias būdas išspręsti CrashLoopBackOff yra laikyti jį signalu tyrimui, o ne diagnoze. Sveikame trikčių šalinimo procese kiekviena komanda susiaurina priežastį: Pod būsena parodo, kas yra perkraunama, ankstesni žurnalai parodo, kodėl paskutinis paleidimas nepavyko, manifestas ir Events parodo, ką Kubernetes prašė konteinerio daryti, o Minikube diagnostika parodo, ar pats vietinis klasteris yra įtrauktas. Kai tie sluoksniai sutampa, taisymas paprastai yra daug mažesnis – ir daug lengviau patikrinamas – nei visko trynimas ir perkonfigūravimas.