Heim
» Grundvallarþekking
»
Hvernig á að laga Kubernetes CrashLoopBackOff í staðbundnu Minikube
Hvernig á að laga Kubernetes CrashLoopBackOff í staðbundnu Minikube
Markmiðið er ekki aðeins að láta CrashLoopBackOff hverfa í nokkrar sekúndur. Góð lausn heldur ílátinu keyrandi, tryggir að Podurinn sé Ready þegar hann á að taka við umferð, stöðvar endurræsingu og skilar atvikaskrá sem sýnir eðlilega uppstart forrits. Í staðbundnu Minikube ættir þú einnig að staðfesta að Minikube-klasterið sjálft sé heilbrigt áður en þú endurbyggir það.
Núverandi skjölun Kubernetes lýsir CrashLoopBackOff sem bakfærsluaðstæðu (backoff condition) sem kemur fram þegar ílát byrjar, mistekst og er endurræst ítrekað. Kubernetes seinkar smám saman frekari endurræsingu til að forðast þröngt mistekistlykkju. Merkið er því einkenni endurtekins ílátavillu, ekki rót vandamálsins í sjálfu sér. Sjá skjölun Kubernetes um lífsferil poods.
Þessi leiðbeining notar fjögur greiningarstig. Fylgdu þeim í röð og stöðvaðu þegar þú hefur fundið og leiðrétt raunverulega orsökina. Minikube er ætlað fyrir staðbundna lærdóms- og þróunaraðstæður, svo sama forritsgræðsla flyst yfir á önnur Kubernetes-klöstr, en Minikube-sértækar endurheimtaraðgerðir gilda ekki endilega í framleiðsluumhverfi. Sjá núverandi Minikube upphafsskjölun.
Hvernig lítur góð lausn út?
Notið athuganleg einkenni frekar en eina græna stöðulínu:
Viðkomandi ílát helst í keyrandi ástandi nógu lengi til að ljúka eðlilegu uppstarti.
Podurinn verður Ready ef áætlað er að hann þjóni umferð.
Endurræsingatalningin hættir að aukast á athugunartímanum.
kubectl logs sýnir eðlilega uppstartarleið frekar en sama banvæna villumelding endurtekur sig.
Lifun- og uppstartsprófanir, ef stilltar eru, hætta að mistakast.
Forritið getur náð í þjónustur eða háðarþætti sem það þarf raunverulega.
minikube status sýnir heilbrigt staðbundið klaster þegar heilsufar klusters var í vafa.
Krafist ekki þess að endurræsingatalning núverandi poods fari aftur í núll. Kubernetes skráir hversu oft ílátið hefur verið endurræst í þeim Pod; góð viðgerð getur skilið eftir ónúll sögulega tölu. Mikilvægt er að talningin hætti að aukast. Ef Deployment útgáfa býr til nýjan Pod, byrjar sá nýi Pod venjulega með sína eigin ferska endurræsingatölu.
Stig 1: Sannaðu hvaða ílát er að hrynja
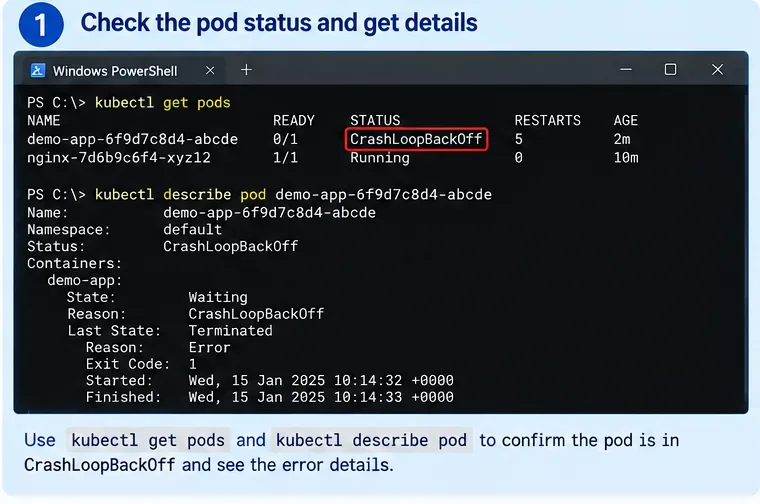
AI-búin myndskreyting af Kubernetes villuleitarterminali. Nöfn, dagsetningar og úttak eru dæmi, ekki skjámynd af raunverulegu Minikube klasteri.
Byrjaðu með Pod-listann:
kubectl get pods -A
Ef þú þekkir nú þegar nafnrýmið (namespace), takmarkaðu skipunina:
kubectl get pods -n my-namespace
Lýstu síðan viðkomandi Pod:
kubectl describe pod <pod-name> -n <namespace>
Skoðaðu fjögur svið í ílátshlutanum:
State — ílátið gæti verið Waiting með ástæðuna CrashLoopBackOff.
Last State — oftast Terminated, sem segir þér hvað gerðist í síðasta keyrslu.
Reason and Exit Code — gagnlegar vísbendingar eins og Error eða OOMKilled.
Restart Count og Events — sönnunargögn um að bilunin endurtaki sig og hvort prófanir eða kubelet aðgerðir séu innifaldar.
Subtil en gagnlegur munur: Heildarfasi poodsins getur enn verið Running á meðan eitt af ílátum hans er að bíða í CrashLoopBackOff. STATUS dálkurinn sem kubectl get pods prentar er þægileg mannvænleg samantekt, ekki fullkomin greining á lífsferilsástandi poods.
Gæðaeftirlit: Í lok þessa stigs ættir þú að vita nákvæman Pod, nafnrými og ílát sem er að endurræsa. Ef Podurinn hefur mörg ílát, auðkenndu hvaða ílát er að mistakast áður en þú lest atvikaskrár.
Ef bilunin er ekki í raun CrashLoopBackOff
Neið ekki fyrir að þvinga öll uppstartsvandamál inn í þessa leiðbeiningu. ImagePullBackOff, ErrImagePull, Pending og ContainerCreating benda á aðra bilunarstiga. Til dæmis gerist mynddráttarvandamál (image-pull) áður en forritsferlið þitt byrjar, svo forritsatvikaskrár gætu ekki enn verið til.
Breyttu nálgun þegar: Events hlutinn bendir á mynddrátt, rúntengingu (volume mounting), tímasetningu (scheduling) eða innritunarvillur frekar en ílát sem byrjar og hættir.
Stig 2: Lestu núverandi og fyrri atvikaskrár mistekins íláts
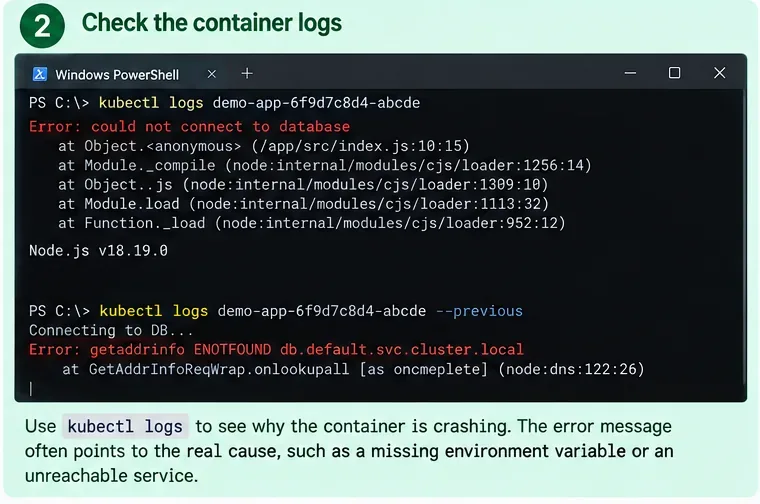
AI-búin myndskreyting af núverandi og fyrri ílátatvikaskrám. Villumeldingar eru dæmi sem notaðar eru til að sýna greiningarvinnufloðið.
Fyrir Pod með einu íláti, byrjaðu með:
kubectl logs <pod-name> -n <namespace>
Þegar ílátið endurræsist hratt er gagnlegasta skipunin oft:
kubectl logs <pod-name> -n <namespace> --previous
Kubernetes skjalfestir --previous sem valkostinn sem prentar atvikaskrár frá fyrri tilviki ílátsins í Podinum. Ef Podurinn inniheldur fleiri en eitt ílát, tilgreindu það sem mistekst:
Flokkaðu fyrstu merkingarbæru banvænu villuna frekar en að einbeita þér að síðustu „process exited“ línu. Dæmigerð mynstur eru:
Sönnunargögn
Líkleg átt
Hvað á að prófa næst
Stack trace ásamt exit code 1
Forrits- eða uppstillingsvilla
Athuga skipun, viðföng, umhverfi, skrár og háðarþátta netföng
Reason: OOMKilled
Ílátið fór yfir minnisþak sitt eða var drepinn vegna minnisþrýstings
Skoða þök, minnisnotkun forrits og Minikube/nóða afköst
Lifunar- eða uppstartsprófunarbilanir í Events
Heilsufarsprófun mistekst fyrir eða eftir uppstart
Prófa prófunarleið, port, tímasetningu og uppstartartíma
DNS eða tengingarvilla við aðra þjónustu
Rangt þjónustuheiti, nafnrými, port eða háðarþáttur ekki tilbúinn
Skoða Service hluti og DNS inni í klasterinu
Vantar skrá, lykil eða umhverfisbreytu
ConfigMap, Secret, tenging eða manifest ósamræmi
Bera Deployment saman við tilvísuða hluti
Gæðaeftirlit: Þú ættir að geta sett fram falsanlega tilgátu eins og „forritið hættir vegna þess að DATABASE_HOST vísar á tilvistarlausan Service,“ ekki aðeins „Kubernetes er bilað.“
Ekki líta á exit code 137 eitt og sér sem sönnun fyrir OOM
Exit code 137 kemur oft fram þegar ferli tekur við SIGKILL, en sterkari Kubernetes-sértæk vísbending er Last State: Terminated með Reason: OOMKilled. Kubernetes auðlindastjórnunarskjöl sýna þessa samsetningu þegar ílát fer yfir minnisþak sitt. Sjá Kubernetes auðlindastjórnunarskjöl.
Gagnleg aðgerð: Byggðu greininguna á útgáfurökunum og umlykjandi Events, ekki tölunni 137 einni saman.
Stig 3: Lagaðu rótina, ekki bakfærslutímarann
AI-búin YAML myndskreyting sem sýnir dæmi um stillingaleiðréttingu. Sviðsgildin eru dæmi og verða að vera aðlöguð að raunverulegu vinnuálagi.
Þegar þú veist af hverju ílátið hættir, breyttu minnstu hlutnum sem takast á við þá orsök. Endurræsing poods ítrekað lagar ekki slæma skipun, vantar stillingar, misteknar heilsufarsprófanir eða ónægt minni.
Tilfelli A: Forritið reynir að ná í aðra þjónustu á localhost
Inni í venjulegum Kubernetes Podi deila ílát í sama Podi netnafnrými og geta tengst hvor öðrum yfir localhost. Gagnagrunnur sem keyrir í öðrum Podi er ekki náð í gegnum localhost forritsins þíns. Kubernetes býr til DNS nöfn fyrir Services svo vinnuálag geti fundið þau eftir þjónustuheiti. Sjá Kubernetes netkerfis hugtök og DNS fyrir Services og Pods.
Ef Service þinn heitir postgres í sama nafnrými, gæti forritið þitt getað notað:
DATABASE_HOST=postgres
Yfir nafnrými, notaðu nafnrýmis-skilgreint heiti eins og postgres.data eða fullt þjónustuheiti sem hentar klaster-dómæninu þínu.
Staðfesta Service áður en þú breytir forritinu:
kubectl get svc -A
kubectl get endpointslices -n <namespace>
Breyttu nálgun þegar: Service er til en hefur engin nothæf bakenda (backend endpoints). Í því tilfelli er ekki nóg að laga viðskiptavininn (client hostname); greindu server Deployment eða Service selector.
Tilfelli B: ConfigMap eða Secret gildi eru röng
Skoðaðu tilvísanirnar í vinnuálags manifest:
kubectl get deployment <name> -n <namespace> -o yaml
kubectl get configmap -n <namespace>
kubectl get secret -n <namespace>
Kubernetes styður umhverfisbreytur frá env, ConfigMaps og Secrets. Gagnleg smáatriði er að ConfigMap gildi sem neytt eru sem umhverfisbreytur eru ekki uppfærð í núþegar keyrandi ferli þegar ConfigMap breytist; Podurinn verður að vera skiptur út. Sama gildir um Secret gildi sem neytt eru sem umhverfisbreytur. Sjá Kubernetes ConfigMap skjölun og Kubernetes Secret innsetningarskjölun.
Fyrir Deployment, eftir leiðréttingu stillinga, er rollout endurræsing ein leið til að búa til nýja Pods:
Gæðaeftirlit: Staðfesta að nýi Podurinn sé í raun að nota æskilegt gildi. Gerðu ekki ráð fyrir að breyting á ConfigMap breyti umhverfisbreytu inni í núverandi íláti strax.
Tilfelli C: Lifunar- eða uppstartsprófun er að drepa hægt forrit
Kubernetes skilgreinir þrjár prófunartegundir með ólíkum tilgangi:
Uppstartsprófun (Startup probe): Ákveður hvort forritsuppstartur sé lokið. Á meðan hún er virk, bíða lifunar- og tilbúinsprófanir.
Lifunarprófun (Liveness probe): Ákveður hvenær Kubernetes ætti að endurræsa fast eða óheilbrigð ílát.
Tilbúinsprófun (Readiness probe): Ákveður hvort Podur ætti að taka við umferð í gegnum Services.
Algeng misskilningur er að misteknar tilbúinsprófanir valdi endurræsingu. Það gera þær ekki. Misteknar tilbúinsprófanir gera Podinn ótilbúinn; endurteknar lifunar- eða uppstartsprófunarbilanir geta valdið ílátendurræsingu. Sjá Kubernetes prófunarhugtök og opinbera prófunarstillingarleiðbeiningar.
Ef forritið þarf raunverulega langan uppstart, íhugaðu uppstartsprófun með nægu failureThreshold × periodSeconds tíma til að ná yfir raunhæfan uppstart. Ekki einfaldlega slökkva á öllum prófunum til að láta stöðuna líta græna út; það fjarlægir gagnlega heilsufarsvörn.
Gæðaeftirlit: Prófunin ætti að prófa skilyrði sem endurspeglar tilgang sinn, og forritið ætti að lifa af eðlilegan uppstart án þess að vera drepna of snemma.
Tilfelli D: Ílátið er OOMKilled
Fyrst, berðu saman minnisþak ílátsins við raunverulegar uppstartarþarfir. Lítið dæmi:
Ef Reason: OOMKilled kemur fram og forritið þarf raunverulega meira en stillt þak, hækkaðu þakið varlega eða minnkaðu minnisnotkun forritsins. Ef Minikube sjálft er minnisfátækt, getur aukning á ílátstakinu einfaldlega flutt vandamálið yfir á nóðann.
Núverandi Minikube skjölun segir að staðlað staðbundið uppsetningu geri ráð fyrir að minnsta kosti 2 CPU, 2 GB af frjálsu minni og 20 GB af frjálsu diskplássi. Minikube styður einnig breytingu á stilltu klasterminni, sem krefst endurræsingar. Sjá núverandi Minikube upphafskröfur.
Breyttu nálgun þegar: Óháðir Pods eru að mistakast eða vera rekla út (evicted), eða Minikube sjálft er óheilbrigð. Það bendir út fyrir minnisþak eins Deployment.
Stig 4: Staðfesta stöðugleika og ákvarða hvort vandamálið sé á klasterstigi
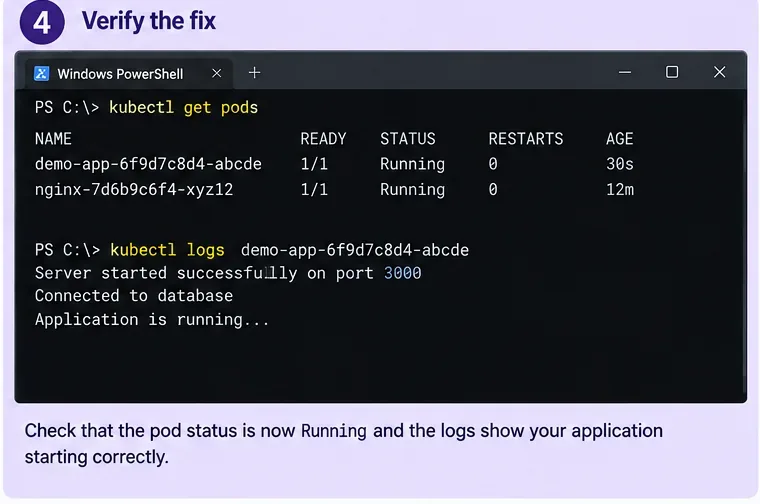
AI-búin staðfestingardæmi. Raunveruleg viðgerð ætti að vera staðfest út frá þínum eigin Pod ástandi, endurræsingatölu, prófunum, atvikaskrám og forritshegðun.
Eftir að viðgerð er beitt, fylgstu með vinnuálaginu frekar en að athuga það einu sinni:
kubectl get pods -n <namespace> -w
Fyrir Deployment:
kubectl rollout status deployment/<name> -n <namespace>
Lestu síðan nýju atvikaskrárnar:
kubectl logs <new-pod-name> -n <namespace>
Öflugur árangursvísir er ekki einfaldlega STATUS=Running. Staðfesta allt eftirfarandi eftir því sem við á:
READY nær væntanlegu gildi, eins og 1/1.
Endurræsingatalningin helst óbreytt á meðan þú fylgist með eðlilegu uppstarti og umferð.
Engin ný BackOff, prófunarbilanir eða OOM atvik koma fram.
Forritsatvikaskrár sýna successful frumstillingu.
Service eða staðbundinn aðgangur nær raunverulega í forritið.
Ef forritið mistekst enn, athugaðu hvort Minikube sjálft sé heilbrigt
Keyrðu:
minikube status
kubectl get pods -A
Minikube status skipunin skýrir ástand staðbundins klusters, þar á meðal host, kubelet, API server og kubeconfig stöðu. Sjá opinbera minikube status tilvísun.
Ef stjórnsléttan (control plane) eða kjarnakerfis Pods eru óheilbrigð, safnaðu klastergreiningargögnum:
minikube logs --problems
minikube logs
Minikube skjölunin er skýr um að minikube logs sé fyrir villuleit á staðbundnu Kubernetes klasterinu, ekki notandaforritskóða þínum. Notaðu kubectl logs fyrir forritsílatið og minikube logs þegar klasterið eða nóðinn sjálfur er í vafa. Sjá núverandi minikube logs tilvísun og Minikube villuleitarleiðbeiningar.
Breyttu nálgun þegar: Kjarna Kubernetes íhlutir eru að mistakast, API server er ekki tiltækur, Minikube status er óheilbrigð, eða mörg óháð vinnuálag mistakast samtímis. Á því tímapunkti er ólíklegt að áframhaldandi breytingar á einu Deployment leysi undirliggjandi vandamálið.
Ættir þú að eyða og endurskapa Minikube klasterið?
Aðeins eftir að þú hefur aðskilið forritsvandamál frá klastervandamáli. Endursköpun staðbundins þróunarklusters getur verið skynsamlegt þegar klasterið er úrskurðarhæft (disposable), manifestin þín eru endurtekjanleg og Minikube sjálft er skemmt eða rangt stillt. Það er slæmt fyrsta svar við forriti sem hættir með skýra stack trace.
Skipanir eins og minikube delete fjarlægja staðbundna klasterið. Það getur einnig fjarlægt staðbundið Kubernetes ástand og gögn sem þú bjóst við að halda. Ekki nota eyðingu sem greiningarstytta þegar varanlegur rúntur (persistent volume), staðbundinn gagnagrunnur eða handvirkt búinn til auðlind inniheldur eina afrit af mikilvægu efni.
Gæðamörk fyrir skipti yfir í klasterendursköpun: Þú hefur staðfest að bilunin er ekki útskýrð af skipun vinnuálagsins, stillingum, háðarþáttum, prófunum eða auðlindarþökum; Minikube heilsufar er óeðlilegt; og staðbundið ástand er annaðhvort öryggisafritað eða örugglega endurtekjanlegt.
Þétt ákvörðunartré
Uppgötvun
Næsta aðgerð
Ekki gera ennþá
Forrits stack trace í --previous atvikaskrám
Laga forrit/stillingar sem villan bendir á
Eyeða Minikube klasterinu
Reason: OOMKilled
Athuga ílátstök og nóða/Minikube minni
Gerðu ráð fyrir að öll exit 137 tilfelli séu eins
Endurteknar lifunar/uppstartsprófunarbilanir
Laga endapunkt, port, tímasetningu eða uppstartsprófunarhönnun
Slökkva á öllum heilsufarsprófunum varanlega
Tilbúinsprófun mistekst en ílátið heldur áfram að keyra
Laga tilbúinsprófun eða háðarþátt tiltækileika
Greina það sem endurræsingarorsök án annarra gagna
ConfigMap/Secret breytt en gamalt env gildi helst
Skipta/endurræsa Pod eftir staðfestingu á nýjum stillingum
Búa við að umhverfisbreytur ferlis endurhleðist heitt (hot-reload)
Minikube status/kjarna Pods óheilbrigð
Nota Minikube greiningu og skoða klasterauðlindir
Halda áfram að breyta einu app Deployment endalaust
Hvað þessi vinnufloður getur ekki tryggt
Staðbundið CrashLoopBackOff getur afhjúpað forritsvillu, háðarþáttavillu, prófunarvillu, auðlindarþak, arkitektúrmismun, vantar skrá, leyfisvandamál eða mörg önnur uppstartsvandamál. Engin föst skipunaröð getur auðkennt alla orsakir án þess að lesa raunverulega útgáfurök, Events og atvikaskrár.
Einnig, viðgerð sem virkar í Minikube sanna ekki sjálfkrafa framleiðsluready. Framleiðsluklöstr geta notað ólíka geymsluklasa, öryggisstefnur, ingress stjórnendur, nóðaarkitektúr, netstefnur, auðlindakvóta, leynilykla kerfi eða ytri þjónustur. Minikube er verðmætt fyrir að endurskapa og skilja ílátastigs bilun, en umhverfissértæk hegðun verður enn að vera prófuð þar sem forritið mun raunverulega keyra.
Loka athugunarlisti
Auðkenna nákvæmlega mistekins ílát og nafnrými.
Lesa Last State, útgáfurök, exit code, endurræsingatölu og Events.
Nota kubectl logs --previous fyrir hratt endurræsandi ílát.
Breyta sönnunargögnum í eina sértæka rótartilgátu.
Laga stillingar, háðarþátta netföng, prófanir eða auðlindir út frá þeim gögnum.
Endurræsa eða rúlla út nýja Pods þegar umhverfisbyggð ConfigMap eða Secret gildi breytast.
Staðfesta Ready ástand og staðfesta að endurræsingatalningin hætti að aukast.
Nota minikube status og minikube logs aðeins þegar klasterheilsufar er einnig í vafa.
Endurskapa Minikube aðeins þegar klasterið sjálft er líklegasta vandamálið og úrskurðarhæft ástand er varið.
Áreiðanlegasta leiðin til að laga CrashLoopBackOff er að líta á það sem merki um að rannsaka, ekki sem greininguna. Í heilbrigðri villuleitarferli, þrengir hver skipun orsökina: Pod ástand segir þér hvað er að endurræsa, fyrri atvikaskrár segja þér af hverju síðasta keyrsla mistókst, manifest og Events sýna hvað Kubernetes bað ílátið að gera, og Minikube greining segir þér hvort staðbundna klasterið sjálft sé innifalið. Þegar þessi lög eru sammála, er viðgerðin oft mun minni—og mun auðveldari að staðfesta—en að eyða og endurbyggja allt.