Hjem
» Basis viden
»
Sådan løser du Kubernetes CrashLoopBackOff i lokal Minikube
Sådan løser du Kubernetes CrashLoopBackOff i lokal Minikube
Målet er ikke blot at få CrashLoopBackOff til at forsvinde i et par sekunder. En god løsning får containeren til at køre, holder Pod'en klar, når den skal modtage trafik, stopper genstartstælleren fra at stige og producerer logs, der viser en normal applikationsopstart. I lokal Minikube bør du også bekræfte, at Minikube-klyngen selv er sund, før du genopbygger den.
Kubernetes' nuværende dokumentation beskriver CrashLoopBackOff som en backoff-tilstand, der opstår, når en container gentagne gange starter, fejler og genstartes. Kubernetes forlænger gradvist forsinkelsen af yderligere genstarter for at undgå en stram fejlsløjfe. Mærkaten er derfor et symptom på gentagen containerfejl, ikke den underliggende årsag i sig selv. Se Kubernetes Pod-livscyklus dokumentation.
Denne guide bruger fire diagnostiske faser. Følg dem i rækkefølge og stop, når du har identificeret og korrigeret den faktiske årsag. Minikube er beregnet til lokal læring og udvikling, så den samme applikationsniveau-diagnose overføres til andre Kubernetes-klynger, mens de Minikube-specifikke genopretningstrin ikke nødvendigvis gælder for produktion. Se den nuværende Minikube start-dokumentation.
Hvordan ser en vellykket løsning ud?
Brug observerbare tegn frem for en enkelt grøn statuslinje:
Den berørte container forbliver i en kørende tilstand længe nok til at fuldføre normal opstart.
Pod'en bliver Ready, hvis den forventes at tjene trafik.
Genstartstælleren stopper med at stige i din observationsperiode.
kubectl logs viser en normal opstartssti frem for den samme fatale fejl, der gentages.
Liveness- og startup-probes, hvis de er konfigureret, stopper med at fejle.
Applikationen kan nå de tjenester eller afhængigheder, den faktisk har brug for.
minikube status viser en sund lokal klynge, når klyngesundheden var i tvivl.
Kræv ikke, at en eksisterende Pod's genstartstæller vender tilbage til nul. Kubernetes registrerer, hvor mange gange containeren er genstartet i den Pod; en vellykket reparation kan efterlade en ikke-nul historisk tælling. Det vigtige er, at tælleren stopper med at stige. Hvis en Deployment-rulning opretter en ny Pod, starter den nye Pod normalt med sin egen friske genstartstæller.
Fase 1: Bevis hvilken container der crasher
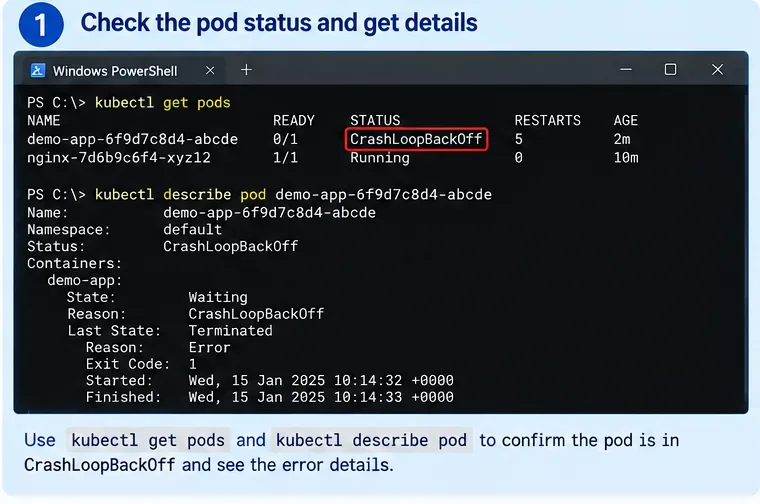
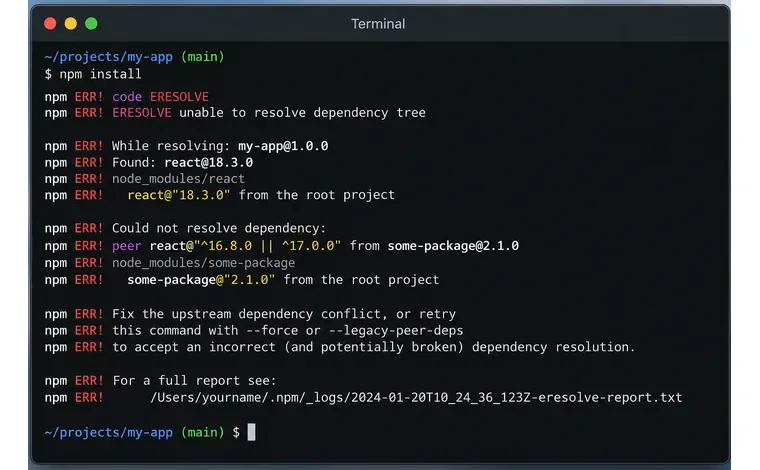
AI-genereret illustration af en Kubernetes-fejlfindingsterminal. Navne, datoer og output er eksempler, ikke et skærmbillede fra en rigtig Minikube-klynge.
Start med Pod-listen:
kubectl get pods -A
Hvis du allerede kender navnerummet, indsnævr kommandoen:
kubectl get pods -n my-namespace
Beskriv derefter den berørte Pod:
kubectl describe pod <pod-name> -n <namespace>
Se på fire felter i container-sektionen:
State — containeren kan i øjeblikket være Waiting med årsagen CrashLoopBackOff.
Last State — ofte Terminated, hvilket fortæller dig, hvad der skete i det foregående kørsel.
Reason and Exit Code — nyttige spor som Error eller OOMKilled.
Restart Count og Events — bevis for at fejlen gentages, og om probes eller kubelet-handlinger er involveret.
En subtil men nyttig distinktion: Pod'ens overordnede fase kan stadig være Running, mens en af dens container venter i CrashLoopBackOff. STATUS-kolonnen udskrevet af kubectl get pods er en bekvem menneskelæsbar opsummering, ikke en komplet diagnose af Pod-livscyklus tilstand.
Kvalitetstjek: ved slutningen af denne fase bør du kende den præcise Pod, navnerum og container, der genstartes. Hvis Pod'en har flere containere, skal du identificere hvilken der fejler, før du læser logs.
Hvis fejlen faktisk ikke er CrashLoopBackOff
Tving ikke alle opstartsproblemer ind i denne guide. ImagePullBackOff, ErrImagePull, Pending og ContainerCreating peger på forskellige fejltrin. For eksempel sker et image-pull-problem, før din applikationsproces starter, så applikationslogs eksisterer måske ikke endnu.
Skift tilgang når: Events-sektionen peger på image-pulling, volume-mounting, planlægning eller admission-fejl frem for en container, der starter og afsluttes.
Fase 2: Læs den fejlede containers nuværende og tidligere logs
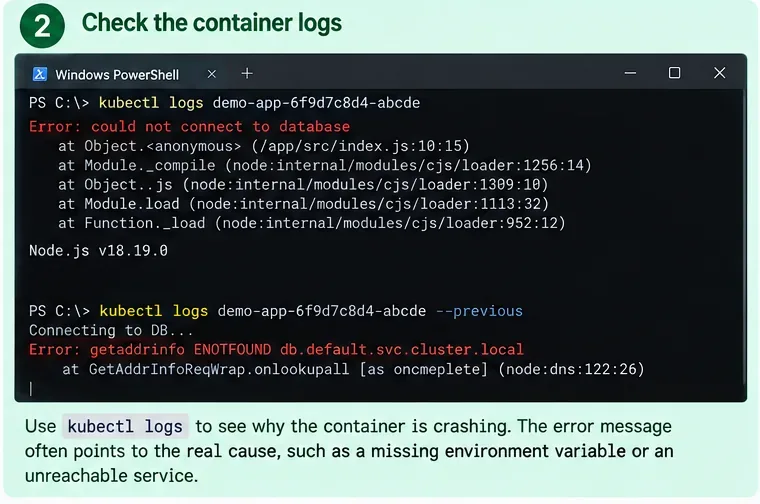
AI-genereret illustration af nuværende og tidligere containerlogs. Fejlbeskeder er eksempler brugt til at demonstrere den diagnostiske arbejdsgang.
For en Pod med én container, start med:
kubectl logs <pod-name> -n <namespace>
Når containeren genstartes hurtigt, er den mest nyttige kommando ofte:
kubectl logs <pod-name> -n <namespace> --previous
Kubernetes dokumenterer --previous som den mulighed, der udskriver logs fra den foregående instans af containeren i Pod'en. Hvis Pod'en indeholder mere end én container, skal du angive den fejlede:
Klassificér den første meningsfulde fatale fejl frem for at fokusere på den sidste "process exited" linje. Typiske mønstre inkluderer:
Bevis
Sandsynlig retning
Hvad der skal testes næste
Stack trace plus exit code 1
Applikations- eller opstartskonfigurationsfejl
Tjek kommando, argumenter, miljø, filer og afhængighedsadresser
Reason: OOMKilled
Containeren overskred sin hukommelsesgrænse eller blev dræbt pga. hukommelsestryk
Inspektér grænser, applikationshukommelsesforbrug og Minikube/node-kapacitet
Liveness- eller startup-probe-fejl i Events
Sundhedstjek fejler før eller efter opstart
Test probe-sti, port, timing og opstartstid
DNS- eller forbindelsesfejl til en anden tjeneste
Forkert tjenestenavn, navnerum, port eller afhængighedsberedskab
Inspektér Service-objekter og in-cluster DNS
Manglende fil, nøgle eller miljøvariabel
ConfigMap, Secret, mount eller manifest-mismatch
Sammenlign Deployment med de refererede objekter
Kvalitetstjek: du bør kunne formulere en falsificerbar hypotese som "applikationen afsluttes fordi DATABASE_HOST peger på en ikke-eksisterende Service", ikke blot "Kubernetes er ødelagt".
Behandl ikke exit code 137 alene som bevis for OOM
En exit code på 137 optræder ofte, når en proces modtager SIGKILL, men det stærkere Kubernetes-specifikke signal er Last State: Terminated med Reason: OOMKilled. Kubernetes' dokumentation om ressourcehåndtering viser denne kombination, når en container overskrider sin hukommelsesgrænse. Se Kubernetes ressourcehåndteringsdokumentation.
Nyttig handling: basér diagnosen på afslutningsårsagen og de omkringliggende Events, ikke tallet 137 alene.
Fase 3: Ret den underliggende årsag, ikke backoff-timeren
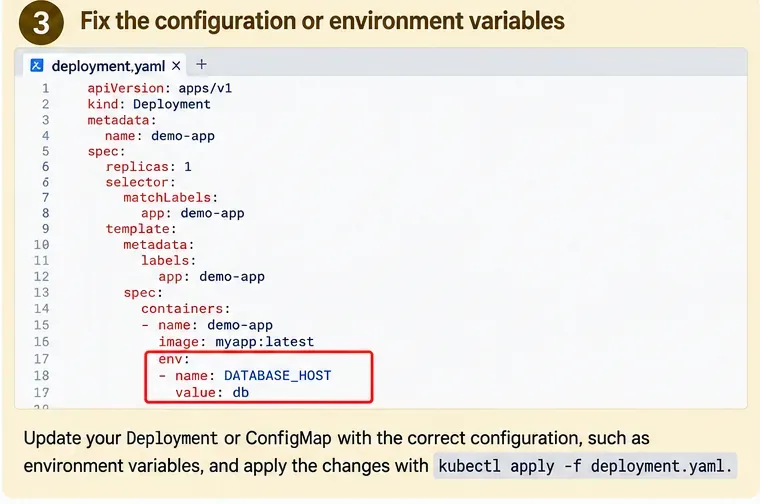
AI-genereret YAML-illustration der viser et eksempel på konfigurationsrettelse. Feltværdierne er illustrative og skal tilpasses den faktiske arbejdsbyrde.
Når du ved hvorfor containeren afsluttes, skal du ændre den mindste ting, der adresserer den årsag. Gentagen genstart af Pod'en reparerer ikke en dårlig kommando, manglende konfiguration, fejlede sundhedstjek eller utilstrækkelig hukommelse.
Tilfælde A: applikationen forsøger at nå en anden tjeneste på localhost
I en normal Kubernetes Pod deler containere i samme Pod et netværksnavnerum og kan kommunikere med hinanden over localhost. En database, der kører i en anden Pod, nås ikke via din applikations localhost. Kubernetes opretter DNS-navne for Services, så arbejdsbyrder kan opdage dem via tjenestenavn. Se Kubernetes netværkskoncepter og DNS for Services og Pods.
Hvis din Service hedder postgres i samme navnerum, kan din applikation måske bruge:
DATABASE_HOST=postgres
På tværs af navnerum, brug et navnerum-kvalificeret navn som postgres.data eller det fuldt kvalificerede tjenestenavn, der passer til dit klyngedomæne.
Verificér Service før du redigerer applikationen:
kubectl get svc -A
kubectl get endpointslices -n <namespace>
Skift tilgang når: Service'en eksisterer, men har ingen brugbare backend-endpoints. I det tilfælde er det ikke nok at rette klientens værtsnavn; diagnosticér serverens Deployment eller Service-selector.
Tilfælde B: ConfigMap eller Secret-værdier er forkerte
Inspektér referencerne i arbejdsbyrdens manifest:
kubectl get deployment <name> -n <namespace> -o yaml
kubectl get configmap -n <namespace>
kubectl get secret -n <namespace>
Kubernetes understøtter miljøvariabler fra env, ConfigMaps og Secrets. En nyttig detalje er, at ConfigMap-værdier, der forbruges som miljøvariabler, ikke opdateres i en allerede kørende proces, når ConfigMap'en ændres; Pod'en skal erstattes. Det samme gælder for Secret-værdier, der forbruges som miljøvariabler. Se Kubernetes ConfigMap dokumentation og Kubernetes Secret injektionsdokumentation.
For et Deployment, efter korrektion af konfigurationen, er en rulning-genstart en måde at oprette nye Pods på:
Kvalitetstjek: verificér at den nye Pod faktisk bruger den tilsigtede værdi. Antag ikke, at redigering af en ConfigMap øjeblikkeligt ændrer en miljøvariabel inde i en eksisterende container.
Tilfælde C: en liveness- eller startup-probe dræber en langsom applikation
Kubernetes definerer tre probetyper med forskellige formål:
Startup probe: bestemmer om applikationsopstarten er fuldført. Mens den er aktiv, venter liveness- og readiness-probes.
Liveness probe: bestemmer hvornår Kubernetes skal genstarte en fastlåst eller usund container.
Readiness probe: bestemmer om en Pod skal modtage trafik via Services.
En almindelig misforståelse er, at en fejlede readiness-probe forårsager en genstart. Det gør den ikke. En readiness-fejl gør Pod'en uberedt; gentagne liveness- eller startup-probe-fejl kan forårsage containergenstarter. Se Kubernetes probe-koncepter og den officielle probe-konfigurationsguide.
Hvis applikationen legitimt har brug for en lang opstart, overvej en startup-probe med nok failureThreshold × periodSeconds tid til at dække realistisk opstart. Deaktiver ikke blot alle probes for at få status til at se grøn ud; det fjerner nyttig sundhedsbeskyttelse.
Kvalitetstjek: proben skal teste en betingelse, der afspejler dens formål, og applikationen skal overleve normal opstart uden at blive dræbt for tidligt.
Tilfælde D: containeren er OOMKilled
Sammenlign først containerens hukommelsesgrænse med dens faktiske opstartsbehov. Et lille eksempel:
Hvis Reason: OOMKilled optræder, og applikationen legitimt kræver mere end den konfigurerede grænse, så hæft grænsen forsigtigt eller reducer applikationens hukommelsesforbrug. Hvis Minikube selv er sulten efter hukommelse, kan det blot flytte problemet til noden at øge kun containergrænsen.
Den nuværende Minikube-dokumentation siger, at den standard lokale opsætning forventer mindst 2 CPU'er, 2 GB fri hukommelse og 20 GB fri diskplads. Minikube understøtter også ændring af den konfigurerede klynghukommelse, hvilket kræver en genstart. Se Minikubes nuværende startkrav.
Skift tilgang når: flere urelaterede Pods fejler eller bliver evikteret, eller Minikube selv er usund. Det peger ud over én Deployments hukommelsesgrænse.
Fase 4: Verificér stabilitet og afgør om problemet er på klyngeniveau
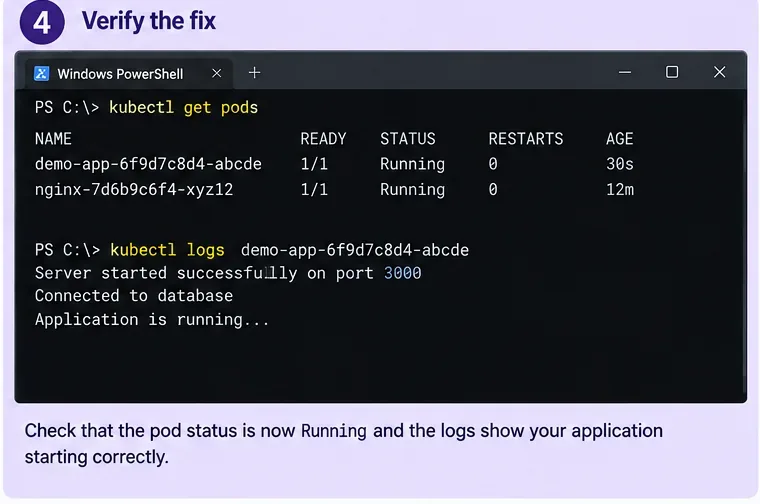
AI-genereret verificeringseksempel. En rigtig løsning bør bekræftes fra din egen Pod-tilstand, genstartstæller, probes, logs og applikationsadfærd.
Efter anvendelse af løsningen, overvåg arbejdsbyrden frem for at tjekke den én gang:
kubectl get pods -n <namespace> -w
For et Deployment:
kubectl rollout status deployment/<name> -n <namespace>
Læs derefter de nye logs:
kubectl logs <new-pod-name> -n <namespace>
Et stærkt succes-tegn er ikke blot STATUS=Running. Bekræft alle disse, hvor det er relevant:
READY når den forventede værdi, såsom 1/1.
Genstartstælleren forbliver uændret, mens du observerer normal opstart og trafik.
Ingen nye BackOff, probe-fejl eller OOM-events optræder.
Applikationslogs viser succesfuld initialisering.
Service'en eller den lokale adgangsvej når faktisk applikationen.
Hvis applikationen stadig fejler, tjek om Minikube selv er sund
Kør:
minikube status
kubectl get pods -A
Minikube status-kommandoen rapporterer tilstanden af den lokale klynge, inklusive host, kubelet, API-server og kubeconfig-status. Se den officielle minikube status reference.
Hvis kontrolplanet eller kerne-system Pods er usunde, indsamle klyngediagnostik:
minikube logs --problems
minikube logs
Minikubes dokumentation er eksplicit om, at minikube logs er til fejlfinding af den lokale Kubernetes-klynge, ikke din brugerapplikationskode. Brug kubectl logs til applikationscontaineren og minikube logs, når klyngen eller noden selv er mistænkt. Se den nuværende minikube logs reference og Minikube fejlfindingsvejledning.
Skift tilgang når: kerne-Kubernetes-komponenter fejler, API-serveren er utilgængelig, Minikube-status er usund, eller mange urelaterede arbejdsbyrder fejler på én gang. På det tidspunkt er det usandsynligt, at fortsat redigering af én Deployment løser det underliggende problem.
Bør du slette og genskabe Minikube-klyngen?
Kun efter du har adskilt et applikationsproblem fra et klyngeproblem. Genskabelse af en lokal udviklingsklynge kan være rimelig, når klyngen er engangs, dine manifests er reproducerbare, og Minikube selv er korrupt eller miskonfigureret. Det er et dårligt første svar på en applikation, der afsluttes med en klar stack trace.
Kommandoer som minikube delete fjerner den lokale klynge. Det kan også fjerne lokal Kubernetes-tilstand og data, du forventede at beholde. Brug ikke sletning som en diagnostisk genvej, når et persistent volume, en lokal database eller en manuelt oprettet ressource indeholder den eneste kopi af noget vigtigt.
Kvalitetstærskel for at skifte til klyngenskabelse: du har bekræftet, at fejlen ikke forklares af arbejdsbyrdens kommando, konfiguration, afhængighed, probes eller ressourcegrænser; Minikube-sundheden er unormal; og den lokale tilstand er enten sikkerhedskopieret eller sikkert reproducerbar.
Et kompakt beslutningstræ
Find
Næste handling
Gør ikke dette endnu
Applikations stack trace i --previous logs
Ret applikationen/konfigurationen indikeret af fejlen
Slet Minikube-klyngen
Reason: OOMKilled
Tjek containergrænser og node/Minikube-hukommelse
Antag at alle exit 137 tilfælde er identiske
Gentagne liveness/startup probe-fejl
Ret endpoint, port, timing eller startup probe-design
Deaktiver alle sundhedstjek permanent
Readiness probe fejler men containeren fortsætter med at køre
Ret readiness eller afhængigheds tilgængelighed
Diagnose det som en genstartsårsag uden andet bevis
ConfigMap/Secret ændret men gammel env-værdi forbliver
Erstat/genstart Pod'en efter validering af den nye konfiguration
Forvent at proces miljøvariabler hot-reloader
Minikube status/kerne Pods usunde
Brug Minikube-diagnostik og inspektér klyngressourcer
Bliv ved med at redigere én app Deployment uendeligt
Hvad denne arbejdsgang ikke kan garantere
En lokal CrashLoopBackOff kan afsløre en applikationsfejl, afhængighedsfejl, probe-fejl, ressourcegrænse, arkitekturmismatch, manglende fil, tilladelsesproblem eller mange andre opstartsfejl. Ingen fast kommandosekvens kan identificere alle årsager uden at læse den faktiske afslutningsårsag, Events og logs.
Derudover beviser en løsning, der virker i Minikube, ikke automatisk produktionsklarhed. Produktionsklynger kan bruge forskellige storage classes, sikkerhedspolitikker, ingress-controllere, node-arkitekturer, netværkspolitikker, ressourcekvoter, secrets-systemer eller eksterne tjenester. Minikube er værdifuldt til at reproducere og forstå container-niveau-fejlen, men miljø-specifik adfærd skal stadig testes, hvor applikationen faktisk vil køre.
Endelig tjekliste
Identificér den præcise fejlede container og navnerum.
Læs Last State, afslutningsårsag, exit code, genstartstæller og Events.
Brug kubectl logs --previous for hurtigt genstartende containere.
Omdan beviset til én specifik underliggende årsag-hypotese.
Ret konfiguration, afhængighedsadressering, probes eller ressourcer baseret på det bevis.
Genstart eller rul nye Pods ud, når miljø-baserede ConfigMap eller Secret-værdier ændres.
Verificér Ready-tilstand og bekræft at genstartstælleren stopper med at stige.
Brug minikube status og minikube logs kun når klyngesundheden også er mistænkt.
Genskab Minikube kun når klyngen selv er den sandsynlige årsag og engangs-tilstand er beskyttet.
Den mest pålidelige måde at løse CrashLoopBackOff på er at behandle det som et signal til at undersøge, ikke som diagnosen. I en sund fejlfindingsproces indsnævrer hver kommando årsagen: Pod-tilstand fortæller dig hvad der genstartes, tidligere logs fortæller dig hvorfor den sidste kørsel fejlede, manifestet og Events viser hvad Kubernetes bad containeren om at gøre, og Minikube-diagnostik fortæller dig om den lokale klynge selv er involveret. Når disse lag er enige, er løsningen normalt meget mindre—og meget lettere at verificere—end at slette og genopbygge alt.