Hjem
» Basis viden
»
Sådan løser du intern fejl 500 i Next.js Server Components
Sådan løser du intern fejl 500 i Next.js Server Components
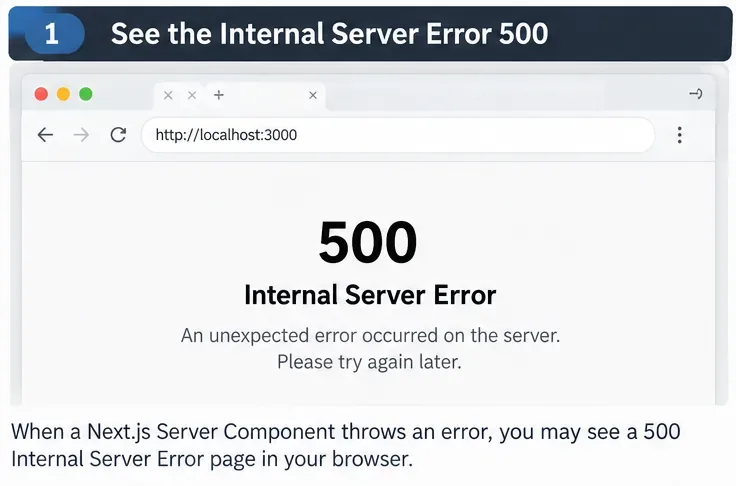
Du åbner en rute i et Next.js App Router-projekt, siden virkede for et øjeblik siden, og nu viser browseren en intern serverfejl eller et HTTP 500-svar. Genindlæsning hjælper ikke. Den klientbaserede konsol viser måske lidt nyttig information, fordi fejlen opstod, mens en Server Component blev renderet på serveren.
Den situation er almindelig nok til at føles mystisk, men en 500-fejl er ikke en diagnose. Det betyder, at serveren stødte på en uventet tilstand under håndteringen af anmodningen. Next.js kan returnere en 500-fejl for en ubehandlet applikationsfejl, og Server Components er særligt vigtige at undersøge, fordi de kan udføre dataadgang, databasespørgsmål, autentificeringskontroller og anden serverkunlogik under rendering.
Versionsnote: Som tjekket den 11. september 2026, lister den officielle Next.js-dokumentation Next.js 16.3.4 som den nyeste version. Fejlformuleringer, udviklingsoverlay, runtime-adfærd og deploymentslogs kan variere afhængigt af version og hostingplatform, så brug stack-trace fra dit eget projekt som primært bevis.
AI-genereret illustration af et Next.js 500-fejls-scenarie; det er ikke et faktisk skærmbillede fra en live-applikation.
Hvad forårsager typisk en 500-fejl i en Server Component?
I App Router bruger Next.js Server Components som standard. Den officielle Server and Client Components-dokumentation forklarer, at Server Components udføres på serveren og kan udføre server-side arbejde såsom dataadgang. Hvis en af disse operationer kaster en fejl, og undtagelsen ikke håndteres på en måde, der producerer et gyldigt svar eller fallback, kan anmodningen fejle.
Forbindelsesfejl, manglende tabel, udløbne legitimationsoplysninger, undtagelser i forespørgsler
Kør forespørgslen uafhængigt og inspicer serverlogs
Manglende miljøvariabel
undefined URL, token, forbindelsesstreng eller hemmelighed
Verificér lokale og deployments miljøindstillinger separat
Problem med server/klient-grænse
Hook, browser-API eller interaktiv kode brugt i den forkerte komponent
Flyt interaktiv kode bag en 'use client'-grænse
Ubehandlet applikationsundtagelse
Stack-trace peger på din side, layout, hjælper, auth-kode eller bibliotek
Ret den linje, der kaster fejlen, og tilføj derefter en passende fejlgrænse
Deployments-/runtime-problem
Virker lokalt, men fejler kun efter deployment
Sammenlign runtime-variabler, netværksadgang, Node/runtime-antagelser og produktionslogs
Trin 1: Repræsentér den fejlede rute lokalt og læs serveroutputtet
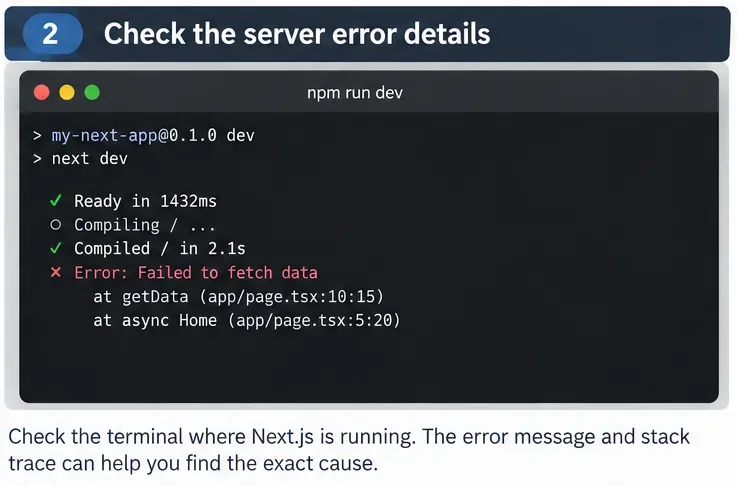
Start med det letteste bevis at opnå. Kør det samme projekt lokalt med din normale udviklingskommando, såsom npm run dev, og anmod om den præcise rute, der fejler. Begynd ikke med at ændre caching, opgradere pakker eller slette låsefiler. Find først den første meningsfulde undtagelse i terminalen, hvor Next.js kører.
Browseren fortæller dig, at en anmodning fejlede; serverens stack-trace fortæller dig sandsynligvis hvorfor. Kig efter den første linje i din egen applikationskode frem for den sidste linje inde i framework-internals. Notér ruten, filen, linjenummeret, fejltypen og om fejlen opstår ved hver anmodning eller kun med specifikke data.
AI-genereret illustration af at tjekke Next.js-serverterminalen for den første nyttige stack-trace-indgang.
Hvis problemet kun sker i produktion, skal du bruge din hosts runtime-logs i stedet. På Vercel skelner den officielle logningsvejledning mellem build-logs og runtime-logs og forklarer, at runtime-indgange kan filtreres efter statuskode og anmodningssti. Vercel dokumenterer også, at en fejl ved funktionskald kan returnere en 500, når runtime'en crasher, eller der opstår en ubehandlet undtagelse eller afvisning.
Trin 2: Isolér datahentning og gør fejl eksplicitte
Server Components fejler ofte, mens de venter på en opstrøms API eller database. Den officielle Next.js datahentningsvejledning viser Server Components, der udfører asynkron server-side dataadgang. Betragt hver ekstern afhængighed som et muligt fejlpunkt.
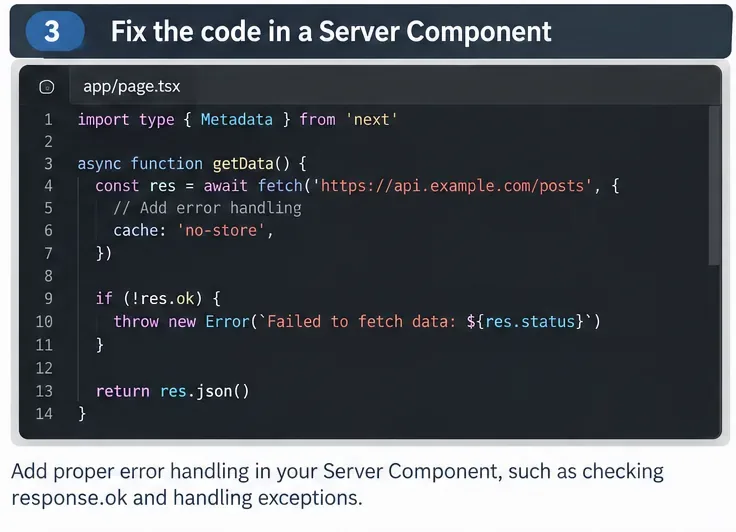
For fetch(), skel mellem en netværksfejl og et HTTP-fejlsvar. Et svar med en ikke-successtatus bør tjekkes, før dets data parses eller renderes. En lille wrapper gør det reelle problem synligt i serverlogs:
async function getData() {
  const apiUrl = process.env.API_URL;

  if (!apiUrl) {
    throw new Error('API_URL er ikke konfigureret');
  }

  const response = await fetch(apiUrl, { cache: 'no-store' });

  if (!response.ok) {
    throw new Error(`Opstrømsanmodning fejlede: ${response.status}`);
  }

  return response.json();
}
Log ikke adgangstokens, cookies, autorisationsheadere, databaseadgangskoder eller fulde URL'er med hemmeligheder. En statuskode, anmodningsmål-navn, korrelations-ID og en renset fejlbesked er normalt nok til at identificere den fejlede afhængighed.
AI-genereret illustration af at tilføje en eksplicit svarkontrol, før en Server Component bruger hentede data.
Trin 3: Tjek miljøvariabler og server/klient-grænsen
Hvis den samme commit virker lokalt, men returnerer 500 efter deployment, skal du sammenligne miljøerne, før du ændrer applikationslogikken. Bekræft, at hver påkrævet server-side variabel findes i deployment-målet, og at værdien peger på en tjeneste, der er tilgængelig fra den runtime. En lokal .env-fil beviser ikke, at produktionsdeploymentet har de samme værdier.
Inspektion derefter komponentgrænser. Next.js Server Components er standarden i App Router, mens interaktiv kode, der har brug for state, effekter, håndtering af begivenheder eller browser-kun API'er, hører til i en Client Component. Det officielle Next.js undervisningsmateriale demonstrerer at flytte en komponent, der bruger useState, bag et 'use client'-direktiv. Nogle grænsefejl fanges under kompilering frem for at blive til en 500-fejl, men at udelukke dem forhindrer dig i at behandle en kode-strukturfejl som en hosting-udfald.
Tjek også alle server-kun pakker, der antager en specifik Node.js-funktion, filsystemlayout, binær eller netværksmiljø. En afhængighed kan virke på én maskine og fejle i en anden runtime, hvis disse antagelser adskiller sig.
Trin 4: Tilføj den rigtige fejlhåndtering i stedet for at skjule undtagelsen
Når rodårsagen er kendt, skal du beslutte, om fejlen er forventet eller uventet. En manglende post kan fortjene et ikke-fundet-svar. En valideringsfejl kan fortjene en normal besked. En uventet undtagelse skal logges og tillades at nå en fejlgrænse frem for at blive stille omdannet til tomme data, der bryder et andet sted.
Next.js dokumenterer den specielle error.tsx-fil som en rute-segment fejlgrænse for uventede fejl. Dens komponent er en Client Component og kan tilbyde et forsøg igen via den leverede reset-funktion. Den officielle Next.js fejlhåndteringsguide demonstrerer også brug af notFound(), når en anmodet ressource ikke eksisterer.
En fejlgrænse forbedrer, hvad brugeren ser; den løser ikke den underliggende undtagelse. Behold server-side loggen, der identificerer årsagen, og eksponér ikke følsomme stack-traces eller hemmeligheder i UI'en.
Trin 5: Verificér løsningen i en produktionslignende bygning
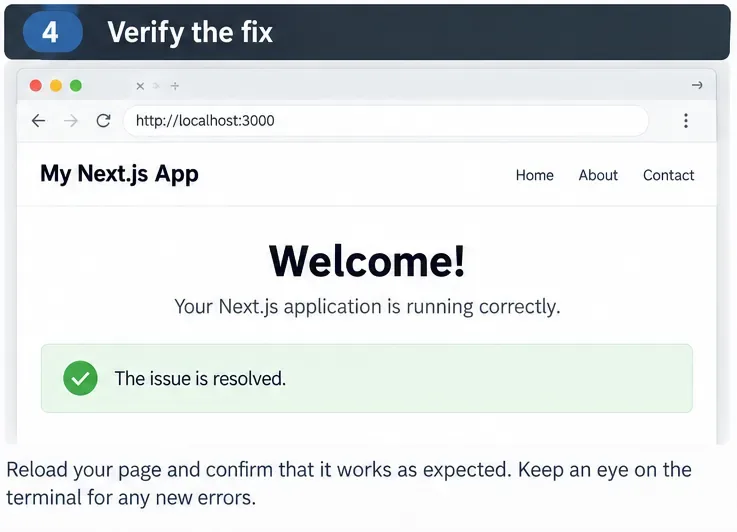
En udviklingsserver er nødvendig for diagnose, men det er ikke den endelige test. Efter ruten virker lokalt, skal du køre en produktionsbygning med dit projekts pakkehåndtering, starte den i produktionsmode, når det er praktisk, og anmode om den samme rute med de samme relevante dataforhold. Verificér derefter det deployede miljø med runtime-logs åbne.
npm run build
npm start
Hvis din hostingplatform bygger anderledes end din bærbare computer, skal du også teste en forhåndsvisningsdeployment, før du promoverer ændringen. En løsning er kun troværdig, når ruten returnerer den forventede status, render den forventede indhold, og der ikke opstår en ny serverundtagelse for den anmodning.
AI-genereret illustration af at verificere den reparererede rute efter, at server-side årsagen er blevet løst.
Sådan bekræfter du, at 500-fejlen faktisk er løst
Den tidligere fejlede URL indlæses gentagne gange uden et HTTP 500-svar.
Serverterminalen eller produktions runtime-logs viser ikke længere den oprindelige undtagelse.
Den samme løsning overlever npm run build og et produktionsmode-kørsel eller forhåndsvisningsdeployment.
Påkrævede miljøvariabler er til stede i det miljø, hvor fejlen oprindeligt opstod.
Eksterne API- eller databasefejl producerer nu en kontrolleret fejlvej i stedet for et uforklarligt crash.
Interaktiv browser-kun kode er inde i Client Components, mens hemmeligheder og privilegeret dataadgang forbliver på serveren.
En error.tsx-grænse giver brugerne en rimelig fallback for uventede rute-segmentfejl.
Hvis det stadig fejler
Reducer ruten, indtil den stopper med at fejle. Erstat midlertidigt én afhængighed ad gangen med en kendt sikker værdi: først databasekaldet, derefter den eksterne API, derefter autentificering eller sessionsopslag, derefter underkomponenter. Den første fjernede operation, der får 500-fejlen til at forsvinde, identificerer det område, der skal undersøges. Gendan hver afhængighed efter test frem for at efterlade falske data i den endelige applikation.
For et produktions-kun problem, skal du sammenligne den præcise deployede commit, Node/runtime-konfiguration, miljøvariabler, netværkstilgængelighed og afhængighedsversioner. Hvis platformen rapporterer en udbyderspecifik fejlkode, skal du bruge udbyderens officielle dokumentation for den præcise kode i stedet for at antage, at alle 500-fejl har samme årsag.
Den vigtigste fejlfindingregel er enkel: betragt "Intern Fejl 500" som symptomet. Det nyttige bevis er den server-side undtagelse, der skete umiddelbart før den. Find den undtagelse først, gør den fejlede afhængighed eksplicit, korriger miljøet eller kodegrænsen, der udløste den, og verificér resultatet i den samme runtime, hvor problemet opstod.