Så här åtgärdar du Kubernetes CrashLoopBackOff i lokal Minikube
Målet är inte bara att få CrashLoopBackOff att försvinna i några sekunder. En bra åtgärd lämnar containern igång, håller Poden Ready när den ska ta emot trafik, stoppar att omstartsräknaren ökar och producerar loggar som visar en normal applikationsstart. I lokal Minikube bör du också bekräfta att Minikube-klustret i sig är friskt innan du bygger om det.
Kubernetes nuvarande dokumentation beskriver CrashLoopBackOff som ett backoff-tillstånd som uppstår när en container upprepade gånger startar, misslyckas och startas om. Kubernetes fördröjer gradvis ytterligare omstarter för att undvika en tät felloop. Etiketten är därför ett symptom på upprepat containerfel, inte den underliggande orsaken i sig. Se Kubernetes Pod-livscykel dokumentation.
Den här guiden använder fyra diagnostiska faser. Följ dem i ordning och sluta när du har identifierat och korrigerat den faktiska orsaken. Minikube är avsett för lokal inlärning och utveckling, så samma applikationsnivådiagnos överförs till andra Kubernetes-kluster, medan de Minikube-specifika återställningsstegen inte nödvändigtvis gäller för produktion. Se den aktuella Minikube startdokumentationen.
Hur ser en lyckad åtgärd ut?
Använd observerbara tecken snarare än en enda grön statusrad:
Den berörda containern förblir i ett igångvarande tillstånd tillräckligt länge för att slutföra normal start.
Poden blir Ready om den förväntas servera trafik.
Omstartsräknaren slutar öka under din observationsperiod.
kubectl logs visar en normal startväg snarare än att samma fatala fel upprepas.
Liveness- och startup-probes, om de är konfigurerade, slutar misslyckas.
Applikationen kan nå de tjänster eller beroenden den faktiskt behöver.
minikube status visar ett friskt lokalt kluster när klusterhälsan var ifrågasatt.
Krav inte att en befintlig Pods omstartsräknare ska återgå till noll. Kubernetes registrerar hur många gånger containern har startats om i den Poden; en lyckad reparation kan lämna en historisk räknare som inte är noll. Det viktiga är att räknaren slutar öka. Om en Deployment-rollout skapar en ny Pod, startar den nya Poden normalt med sin egen färska omstartsräknare.
Fas 1: Bevisa vilken container som kraschar
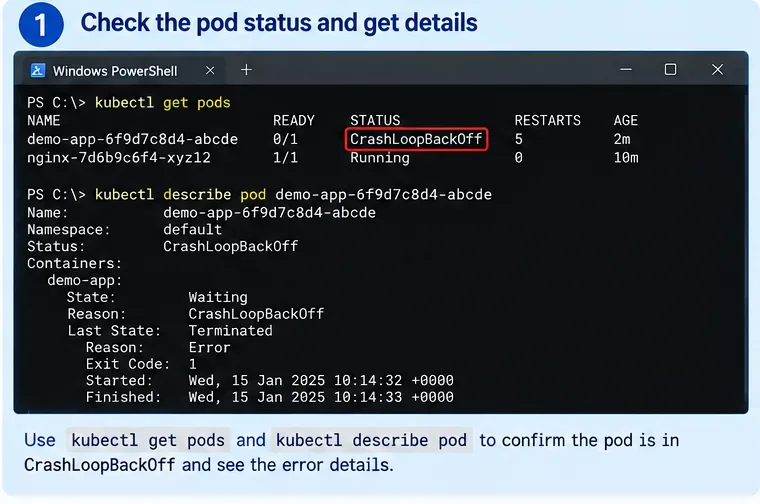
AI-genererad illustration av en Kubernetes felsökningsterminal. Namnen, datumen och utdatan är exempel, inte en skärmdump från ett verkligt Minikube-kluster.
Börja med Pod-listan:
kubectl get pods -A
Om du redan känner till namnrymden, begränsa kommandot:
kubectl get pods -n my-namespace
Beskriv sedan den berörda Poden:
kubectl describe pod <pod-name> -n <namespace>
Titta på fyra fält i containerns avsnitt:
State — containern kan för närvarande vara Waiting med anledningen CrashLoopBackOff.
Last State — ofta Terminated, vilket berättar vad som hände i den tidigare körningen.
Reason and Exit Code — användbara ledtrådar som Error eller OOMKilled.
Restart Count och Events — bevis på att felet upprepas och om probes eller kubelet-åtgärder är inblandade.
En subtil men användbar distinktion: Podens övergripande fas kan fortfarande vara Running medan en av dess containrar väntar i CrashLoopBackOff. STATUS-kolumnen som skrivs ut av kubectl get pods är en bekväm läsbar sammanfattning, inte en komplett diagnos av Pod-livscykeltillståndet.
Kvalitetskontroll: vid slutet av denna fas bör du känna till exakt Pod, namnrymd och container som startar om. Om Poden har flera containrar, identifiera vilken som misslyckas innan du läser loggar.
Om felet inte faktiskt är CrashLoopBackOff
Tvinga inte in varje startproblem i den här guiden. ImagePullBackOff, ErrImagePull, Pending och ContainerCreating pekar på olika felstadier. Till exempel inträffar ett bildhämtningproblem innan din applikationsprocess startar, så applikationsloggar kanske inte finns ännu.
Ändra tillvägagångssätt när: Events-avsnittet pekar på bildhämtning, volymmontering, schemaläggning eller admissionfel snarare än en container som startar och avslutas.
Fas 2: Läs den misslyckade containerns nuvarande och tidigare loggar
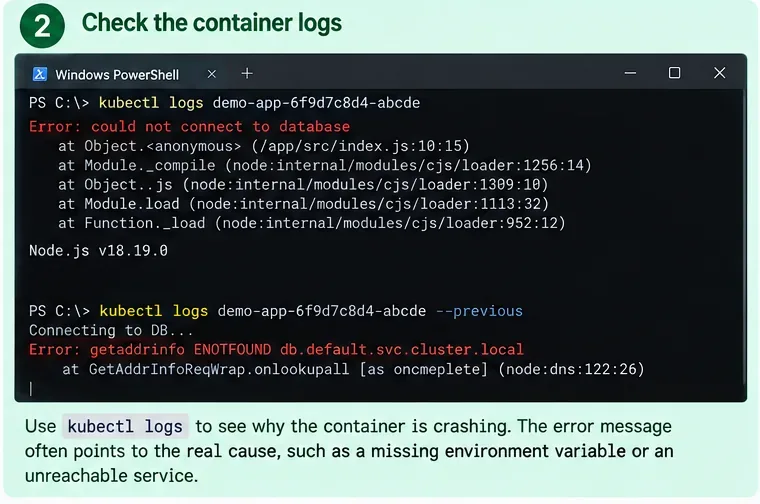
AI-genererad illustration av nuvarande och tidigare containerloggar. Felmeddelanden är exempel som används för att demonstrera diagnostikarbetsflödet.
För en Pod med en enda container, börja med:
kubectl logs <pod-name> -n <namespace>
När containern startar om snabbt är det mest användbara kommandot ofta:
kubectl logs <pod-name> -n <namespace> --previous
Kubernetes dokumenterar --previous som alternativet som skriver ut loggar från containerns tidigare instans i Poden. Om Poden innehåller mer än en container, ange den som misslyckas:
Klassificera det första meningsfulla fatala felet snarare än att fokusera på den sista raden "process exited". Typiska mönster inkluderar:
Bevis
Sannolik riktning
Vad du ska testa härnäst
Stack trace plus exit code 1
Applikations- eller startkonfigurationsfel
Kontrollera kommando, argument, miljö, filer och beroendeadresser
Reason: OOMKilled
Containern överskred sin minnesgräns eller dödades på grund av minnespress
Inspektera gränser, applikationsminnesanvändning och Minikube/nodkapacitet
Liveness- eller startup-probe-fel i Events
Hälsokontroll misslyckas före eller efter start
Testa probe-sökväg, port, timing och startvaraktighet
DNS- eller anslutningsfel till en annan tjänst
Fel tjänstenamn, namnrymd, port eller beroendebreddskap
Inspektera Service-objekt och DNS inom klustret
Saknad fil, nyckel eller miljövariabel
ConfigMap, Secret, montering eller manifestavvikelse
Jämför Deployment med de refererade objekten
Kvalitetskontroll: du bör kunna ange en falsifierbar hypotes som "applikationen avslutas eftersom DATABASE_HOST pekar på en icke-existerande Service", inte bara "Kubernetes är trasigt".
Behandla inte exit code 137 ensam som bevis för OOM
En exit code på 137 visas vanligtvis när en process tar emot SIGKILL, men den starkare Kubernetes-specifika signalen är Last State: Terminated med Reason: OOMKilled. Kubernetes resurshanteringsdokumentation visar denna kombination när en container överskrider sin minnesgräns. Se Kubernetes resurshanteringsdokumentation.
Användbar åtgärd: basera diagnosen på avslutningsorsaken och omgivande Events, inte siffran 137 i sig.
Fas 3: Åtgärda den underliggande orsaken, inte backoff-timern
AI-genererad YAML-illustration som visar ett exempel på konfigurationskorrigering. Fältnvärdena är illustrativa och måste anpassas till den faktiska arbetsbelastningen.
När du vet varför containern avslutas, ändra den minsta saken som adresserar den orsaken. Att starta om Poden upprepade gånger reparerar inte ett dåligt kommando, saknad konfiguration, misslyckad hälsokontroll eller otillräckligt minne.
Case A: applikationen försöker nå en annan tjänst på localhost
Inuti en normal Kubernetes Pod delar containrar i samma Pod ett nätverksnamnrymd och kan kommunicera med varandra över localhost. En databas som körs i en annan Pod nås inte via din applikations localhost. Kubernetes skapar DNS-namn för Services så att arbetsbelastningar kan upptäcka dem via tjänstenamn. Se Kubernetes nätverkskoncept och DNS för Services och Pods.
Om din Service heter postgres i samma namnrymd, kan din applikation kunna använda:
DATABASE_HOST=postgres
Över namnrymder, använd ett namnrymdskvalificerat namn som postgres.data eller det fullständigt kvalificerade tjänstenamnet som är lämpligt för din klusterdomän.
Verifiera Service innan du redigerar applikationen:
kubectl get svc -A
kubectl get endpointslices -n <namespace>
Ändra tillvägagångssätt när: Service finns men har inga användbara backend-endpoints. I det fallet räcker det inte att fixa klientvärdnamnet; diagnos serverns Deployment eller Service-selector.
Case B: ConfigMap- eller Secret-värden är felaktiga
Inspektera referenserna i arbetsbelastningsmanifestet:
kubectl get deployment <name> -n <namespace> -o yaml
kubectl get configmap -n <namespace>
kubectl get secret -n <namespace>
Kubernetes stöder miljövariabler från env, ConfigMaps och Secrets. En användbar detalj är att ConfigMap-värden som konsumeras som miljövariabler inte uppdateras i en redan igångvarande process när ConfigMap ändras; Poden måste ersättas. Detsamma gäller för Secret-värden som konsumeras som miljövariabler. Se Kubernetes ConfigMap-dokumentation och Kubernetes Secret-injektionsdokumentation.
För en Deployment, efter att ha korrigerat konfigurationen, är en rollout-omstart ett sätt att skapa nya Pods:
Kvalitetskontroll: verifiera att den nya Poden faktiskt använder det avsedda värdet. Anta inte att redigering av en ConfigMap omedelbart ändrar en miljövariabel inuti en befintlig container.
Case C: en liveness- eller startup-probe dödar en långsam applikation
Kubernetes definierar tre probetyper med olika syften:
Startup probe: avgör om applikationsstarten har slutförts. Medan den är aktiv väntar liveness- och readiness-probes.
Liveness probe: avgör när Kubernetes ska starta om en fastnat eller osund container.
Readiness probe: avgör om en Pod ska ta emot trafik via Services.
Ett vanligt missförstånd är att en misslyckad readiness-probe orsakar en omstart. Det gör den inte. Ett readiness-fel gör Poden unready; upprepade liveness- eller startup-probe-fel kan orsaka containeromstarter. Se Kubernetes probe-koncept och den officiella probe-konfigurationsguiden.
Om applikationen legitimt behöver en lång start, överväg en startup probe med tillräcklig failureThreshold × periodSeconds-tid för att täcka realistisk start. Inaktivera inte alla probes bara för att statusen ska se grön ut; det tar bort användbart hälsoskydd.
Kvalitetskontroll: proben bör testa ett tillstånd som återspeglar dess syfte, och applikationen bör överleva normal start utan att dödas i förtid.
Case D: containern är OOMKilled
Jämför först containerns minnesgräns med dess faktiska startbehov. Ett litet exempel:
Om Reason: OOMKilled visas och applikationen legitimt kräver mer än den konfigurerade gränsen, höj gränsen noggrant eller minska applikationens minnesanvändning. Om Minikube i sig är svältet på minne, kan det att bara öka containerns gräns helt enkelt flytta problemet till noden.
Den aktuella Minikube-dokumentationen säger att den standardlokala installationen förväntar sig minst 2 CPU:er, 2 GB ledigt minne och 20 GB ledigt diskutrymme. Minikube stöder också ändring av det konfigurerade klusterminnet, vilket kräver en omstart. Se Minikubes aktuella startkrav.
Ändra tillvägagångssätt när: flera orelaterade Pods misslyckas eller evikteras, eller om Minikube i sig är osunt. Det pekar bortom en Deployments minnesgräns.
Fas 4: Verifiera stabilitet och avgör om problemet är på klusternivå
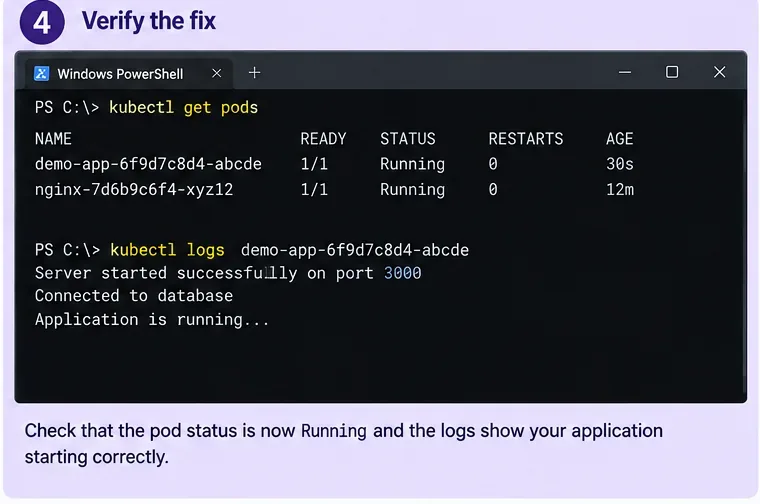
AI-genererat verifieringsexempel. En verklig åtgärd bör bekräftas från din egen Podstatus, omstartsräknare, probes, loggar och applikationsbeteende.
Efter att ha tillämpat åtgärden, övervaka arbetsbelastningen snarare än att kontrollera den en gång:
kubectl get pods -n <namespace> -w
För en Deployment:
kubectl rollout status deployment/<name> -n <namespace>
Läs sedan de nya loggarna:
kubectl logs <new-pod-name> -n <namespace>
En stark framgångssignal är inte bara STATUS=Running. Bekräfta alla dessa där tillämpligt:
READY når det förväntade värdet, som 1/1.
Omstartsräknaren förblir oförändrad medan du observerar normal start och trafik.
Inga nya BackOff-, probe-fel- eller OOM-events visas.
Applikationsloggarna visar framgångsrik initialisering.
Service eller lokal åtkomstväg når faktiskt applikationen.
Om applikationen fortfarande misslyckas, kontrollera om Minikube i sig är friskt
Kör:
minikube status
kubectl get pods -A
Minikube status-kommandot rapporterar tillståndet för det lokala klustret, inklusive värd, kubelet, API-server och kubeconfig-status. Se den officiella minikube status-referensen.
Om kontrollplanet eller kärnsystem-Pods är osunda, samla klusterdiagnostik:
minikube logs --problems
minikube logs
Minikubes dokumentation är explicit att minikube logs är för felsökning av det lokala Kubernetes-klustret, inte din användarapplikationskod. Använd kubectl logs för applikationscontainern och minikube logs när klustret eller noden i sig är misstänkt. Se den aktuella minikube logs-referensen och Minikube felsökningsvägledning.
Ändra tillvägagångssätt när: kärnkomponenter i Kubernetes misslyckas, API-servern är otillgänglig, Minikube status är osund, eller många orelaterade arbetsbelastningar misslyckas samtidigt. Vid den punkten är det osannolikt att fortsätta redigera en Deployment löser det underliggande problemet.
Bör du radera och återskapa Minikube-klustret?
Endast efter att du har separerat ett applikationsproblem från ett klusterproblem. Att återskapa ett lokalt utvecklingskluster kan vara rimligt när klustret är engångsartat, dina manifest är reproducerbara och Minikube i sig är korrupt eller felkonfigurerat. Det är ett dåligt första svar på en applikation som avslutas med en tydlig stack trace.
Kommandon som minikube delete tar bort det lokala klustret. Det kan också ta bort lokal Kubernetes-status och data du förväntade dig att behålla. Använd inte radering som en diagnostisk genväg när en persistent volym, lokal databas eller manuellt skapad resurs innehåller den enda kopian av något viktigt.
Kvalitetströskel för att byta till klusteråterskapande: du har bekräftat att felet inte förklaras av arbetsbelastningens kommando, konfiguration, beroende, probes eller resursgränser; Minikube-hälsan är onormal; och det lokala tillståndet är antingen säkerhetskopierat eller säkert reproducerbart.
Ett kompakt beslutsdiagram
Fynd
Nästa åtgärd
Gör inte ännu
Applikationsstack trace i --previous loggar
Fixa applikationen/konfigurationen som indikeras av felet
Radera Minikube-klustret
Reason: OOMKilled
Kontrollera containerns gränser och nod/Minikube-minne
Anta att alla exit 137-fall är identiska
Upprepade liveness/startup probe-fel
Fixa endpoint, port, timing eller startup probe-design
Inaktivera varje hälsokontroll permanent
Readiness probe misslyckas men containern fortsätter köra
Fixa readiness eller beroendetillgänglighet
Diagnostisera det som en omstartsorsak utan andra bevis
ConfigMap/Secret ändrades men gammalt env-värde kvarstår
Ersätt/starta om Poden efter validering av ny konfiguration
Förvänta att processmiljövariabler hot-reloadas
Minikube status/kärn-Pods osunda
Använd Minikube-diagnostik och inspektera klusterresurser
Fortsätt redigera en app Deployment obestämd tid
Vad detta arbetsflöde inte kan garantera
En lokal CrashLoopBackOff kan exponera en applikationsbugg, beroendefel, probe-misstag, resursgräns, arkitekturmismatch, saknad fil, behörighetsproblem eller många andra startfel. Ingen fast kommandosekvens kan identifiera varje orsak utan att läsa den faktiska avslutningsorsaken, Events och loggar.
Dessutom bevisar inte en åtgärd som fungerar i Minikube automatiskt produktionsberedskap. Produktionskluster kan använda olika lagringsklasser, säkerhetspolicys, ingresskontrollanter, nodarkitekturer, nätverkspolicys, resurskvoter, secretsystem eller externa tjänster. Minikube är värdefullt för att reproducera och förstå containerfel på låg nivå, men miljöspecifikt beteende måste fortfarande testas där applikationen faktiskt kommer att köras.
Slutgiltig checklista
Identifiera exakt vilken container och namnrymd som misslyckas.
Läs Last State, avslutningsorsak, exit code, omstartsräknare och Events.
Använd kubectl logs --previous för containrar som startar om snabbt.
Omvandla bevisen till en specifik underliggande orsakshypotes.
Fixa konfiguration, beroendeadressering, probes eller resurser baserat på dessa bevis.
Starta om eller rulla ut nya Pods när miljöbaserade ConfigMap- eller Secret-värden ändras.
Verifiera Ready-tillstånd och bekräfta att omstartsräknaren slutar öka.
Använd minikube status och minikube logs endast när klusterhälsan också är misstänkt.
Återskapa Minikube endast när klustret i sig är den sannolika orsaken och engångsartat tillstånd är skyddat.
Det mest pålitliga sättet att fixa CrashLoopBackOff är att behandla det som en signal att undersöka, inte som diagnosen. I en sund felsökningsprocess snävar varje kommando in orsaken: Podstatus berättar vad som startar om, tidigare loggar berättar varför den senaste körningen misslyckades, manifestet och Events visar vad Kubernetes bad containern att göra, och Minikube-diagnostik berättar om det lokala klustret i sig är inblandat. När dessa lager är överens är åtgärden vanligtvis mycket mindre – och mycket lättare att verifiera – än att radera och bygga om allt.