Hem
» Grundläggande kunskap
»
Hur man åtgärdar "Nginx 502 Bad Gateway" vid proxyanvändning till Node.js
Hur man åtgärdar "Nginx 502 Bad Gateway" vid proxyanvändning till Node.js
En NGINX 502 Bad Gateway framför en Node.js-applikation betyder vanligtvis en sak: NGINX accepterade klientförfrågan men kunde inte få ett användbart svar från den uppströmsapplikation som den skulle kontakta. Den snabbaste lösningen är därför att inte starta om allt eller öka varje timeout. Bevisa först om Node.js-tjänsten är nåbar från samma nätverksplats som NGINX, använd sedan NGINX-felloggen för att välja nästa steg.
Den här guiden använder fyra diagnostiska steg. Kommandona förutsätter att en Linux-värd och en Node.js-app förväntas på port 3000. Ersätt port, värdnamn, sökvägar och tjänstnamn med värdena i din distribution.
Vad bör du kontrollera innan du byter NGINX?
Ställ först tre frågor:
Lyssnar Node.js-processen faktiskt på adressen och porten som NGINX försöker nå?
Vilket exakt uppströmsfel registrerar NGINX-felloggen för den misslyckade begäran?
Körs NGINX och Node.js på samma värd, i separata containrar eller på separata maskiner?
De svaren är viktiga eftersom samma webbläsarsynliga 502 kan komma från väldigt olika förhållanden. En stoppad nodprocess, fel proxy_passport, en felaktig containeranvändning 127.0.0.1, en upstream-timeout och ett ogiltigt upstream-svar har inte samma lösning.
NGINX dokumenterar proxy_passsom direktivet som anger protokollet och adressen för proxyservern. Dess uppströmsmodul exponerar också variabler som $upstream_addr, $upstream_status, $upstream_connect_timeoch $upstream_response_time, vilka är användbara när du behöver mer detaljerad produktionsloggning. Se den officiella dokumentationen för NGINX-proxymodulen och NGINX-uppströmsmodulens dokumentation .
Steg 1: Kan NGINX uppströms nås direkt?
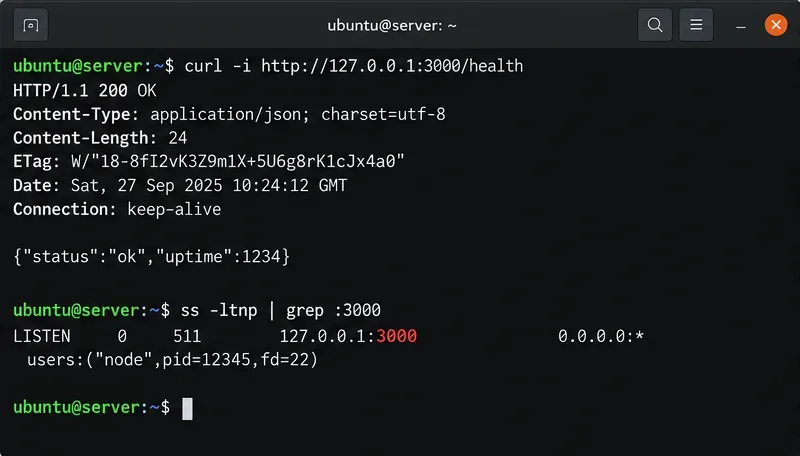
Börja med att kringgå den omvända proxyn. Om NGINX är på samma värd som Node.js och din konfiguration pekar på 127.0.0.1:3000, testa exakt den destinationen:
curl -i http://127.0.0.1:3000/health
ss -ltnp | grep ':3000'
Ett felfritt resultat kan returnera HTTP 200 från din applikation och visa en lyssnare på port 3000. Om anslutningen nekas, redigera inte NGINX-timeouts ännu. Det finns ingen lyssningstjänst på adressen som NGINX försöker använda, eller så lyssnar tjänsten någon annanstans.
Den första kontrollen kringgår NGINX: terminalen anropar Node.js hälsoslutpunkt direkt och bekräftar vilken adress som lyssnar på port 3000.
Vad händer om Node.js-processen körs men porten saknas?
En körande process räcker inte. Applikationen måste ha slutfört serverstarten och framgångsrikt bundit en lyssnande socket. Node.js dokumenteras server.listen()som den operation som startar en TCP- eller IPC-server som lyssnar efter anslutningar. Den noterar också att detta EADDRINUSEinträffar när en annan server redan äger den begärda porten. Granska den officiella dokumentationen för Node.js nätserver och Node.js HTTP-dokumentation .
En minimal Node.js HTTP-testtjänst kan se ut så här:
import http from 'node:http';

const server = http.createServer((req, res) => {
  if (req.url === '/health') {
    res.writeHead(200, { 'content-type': 'application/json' });
    return res.end(JSON.stringify({ status: 'ok' }));
  }

  res.writeHead(200, { 'content-type': 'text/plain' });
  res.end('Node.js is running');
});

server.listen(3000, '127.0.0.1', () => {
  console.log('Listening on http://127.0.0.1:3000');
});
Att binda till 127.0.0.1är lämpligt när NGINX och Node.js delar samma värd och ingen annan maskin behöver direkt åtkomst till Node-porten. Om de finns i separata containrar har den adressen en annan betydelse, vilket beskrivs nedan.
Steg 2: Vad står det egentligen i NGINX-felloggen?
När du vet om uppströmsen svarar direkt, kontrollera loggposten som genererades samtidigt som 502. En vanlig plats på Linux-paket är /var/log/nginx/error.log, men den faktiska sökvägen styrs av error_logdirektivet och kan variera beroende på installation.
sudo tail -n 100 /var/log/nginx/error.log
NGINX kärndokumentation anger att det error_logstyr diagnostikloggens destination och allvarlighetsgrad. Dess kommandoradsdokumentation ger också möjlighet nginx -Tatt testa och dumpa den aktiva konfigurationen, vilket kan hjälpa dig att hitta en oväntad loggsökväg eller ett serverblock. Se NGINX kärnloggningsdokumentation och NGINX kommandoradsparametrar .
En anslutningsvägrad ingång pekar mot uppströmsadressen eller tjänstens tillgänglighet, inte mot ett behov av en längre proxy-timeout.
Använd meddelandet för att begränsa problemet:
Vad du ser
Mest användbar nästa kontroll
Connection refusedvid anslutning till uppströms
Bekräfta nodlyssnaren, porten, adressen, containernätverket och processtillståndet.
Uppströmsanslutningens tidsgräns överskrids
Kontrollera routingens/brandväggens tillgänglighet och om destinationen är tillgänglig överhuvudtaget.
Uppströmsläsning utlöses efter anslutning
Mät applikationens svarstid och inspektera långsamt Node.js-arbete eller nedströmsberoenden innan du ökar proxy_read_timeout.
Endast WebSocket-förfrågningar misslyckas
Kontrollera rubrikerna för WebSocket-uppgradering och anslutning samt NGINX-versionens beteende.
Steg 3: Pekar proxy_pass på adressen som Node.js verkligen använder?
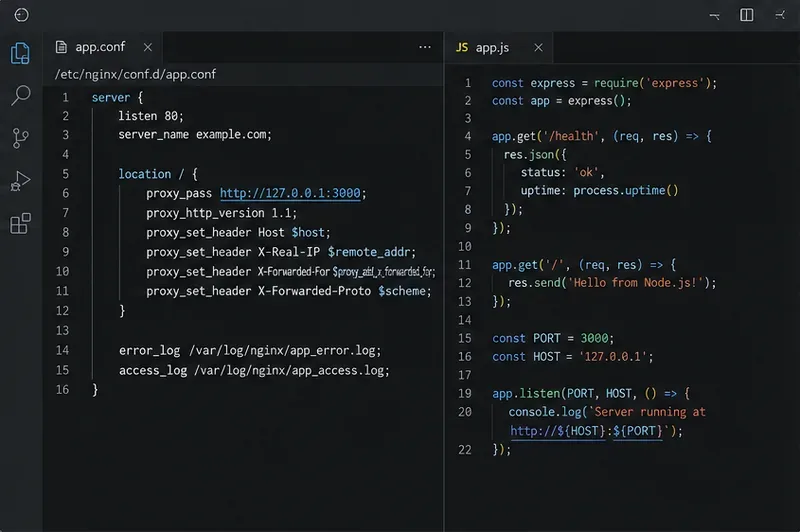
Jämför live-lyssnaren från steg 1 med den aktiva NGINX-konfigurationen. En konventionell installation med samma värd ser ut så här:
NGINX stöder officiellt en IP-adress, värdnamn, uppströmsgrupp eller UNIX-domänsocket i proxy_pass. Den kritiska regeln är enkel: destinationen måste kunna nås från NGINX-arbetarens nätverkskontext.
Jämför båda sidor av anslutningen: NGINX uppströmsmålet måste matcha en adress och port som Node.js-servern faktiskt lyssnar på.
Finns NGINX och Node.js i separata Docker Compose-containrar?
Om de är det, 127.0.0.1hänvisar "inuti NGINX-containern" till själva NGINX-containern, inte Node.js-containern. Docker Compose-dokumentationen anger att tjänster på standard-Compose-nätverket kan upptäckas via tjänstnamn. Den rekommenderar också att man använder containerporten för kommunikation mellan tjänster snarare än en värdpublicerad port.
Om till exempel Compose-tjänsten är namngiven appoch Node lyssnar på containerport 3000, kan NGINX använda:
location / {
    proxy_pass http://app:3000;
}
Båda tjänsterna måste dela ett nätverk. Node-tjänsten måste också lyssna på ett gränssnitt som kan nås från det containernätverket; applikationer binder vanligtvis till 0.0.0.0insidan av containern för detta ändamål. Du behöver inte nödvändigtvis publicera port 3000 till värden bara för NGINX-till-app-trafik. Verifiera topologin mot den officiella nätverksdokumentationen för Docker Compose .
Ska du använda localhost eller 127.0.0.1?
Om båda processerna körs på samma värd kan endera fungera, men de är inte alltid utbytbara i alla miljöer eftersom localhostde kan lösas upp till IPv4, IPv6 eller båda. Genom att använda den exakta adressen som visas av lyssnaren tas en variabel bort. Node.js dokumenterar att om argumentet hostutelämnas kan den lyssna på den ospecificerade IPv6-adressen ::när den är tillgänglig, eller den ospecificerade IPv4-adressen 0.0.0.0annars.
Om du ser en avvikelse, till exempel att NGINX kontaktar 127.0.0.1:3000medan programmet endast är tillgängligt via ett annat containervärdnamn, en annan port eller en UNIX-socket, korrigera adressen istället för att kompensera med nya försök.
Är en längre timeout verkligen rätt lösning?
Ändra bara timeouts när loggarna visar en timeout och du förstår varför uppströmsfunktionen behöver längre tid. NGINX dokumenterar en standardtid proxy_connect_timeoutpå 60 sekunder och noterar att den vanligtvis inte kan överstiga 75 sekunder. Den dokumenterar också en standardtid proxy_read_timeoutpå 60 sekunder, mätt mellan successiva läsningar från uppströmsfunktionen snarare än över hela svaret.
Exemplet ovan är inte en universell rekommendation. En låg anslutningstimeout kan vara rimlig för en lokal uppströms kedja som ska ansluta nästan omedelbart, medan en längre lästimeout kan vara motiverad för en legitimt lång begäran. Men om applikationen är långsam på grund av en blockerad händelseslinga, en databas som stannar, ett överbelastat beroende eller en begäran som har hängt sig, döljer en ökning av timeouten bara symtomet.
Vad händer om bara WebSocket-anslutningar får ett 502-fel eller en frånkoppling?
WebSocket-proxyanvändning har ytterligare krav eftersom Upgradeoch Connection-rubrikerna är hop-by-hop-rubriker och inte automatiskt vidarebefordras i den vanliga reverse-proxy-sökvägen. NGINX:s officiella WebSocket-dokumentation visar explicit hur man ställer in dessa rubriker.
NGINX noterar också att en inaktiv proxybaserad WebSocket-anslutning stängs om uppströmskopplingen inte skickar några data inom läs-timeout-intervallet; en ping på applikationsnivå kan hålla anslutningen aktiv där så är lämpligt. För aktuellt beteende och versionsspecifika anteckningar, använd den officiella NGINX WebSocket-proxydokumentationen .
Steg 4: Hur validerar du åtgärden utan att skapa ett nytt avbrott?
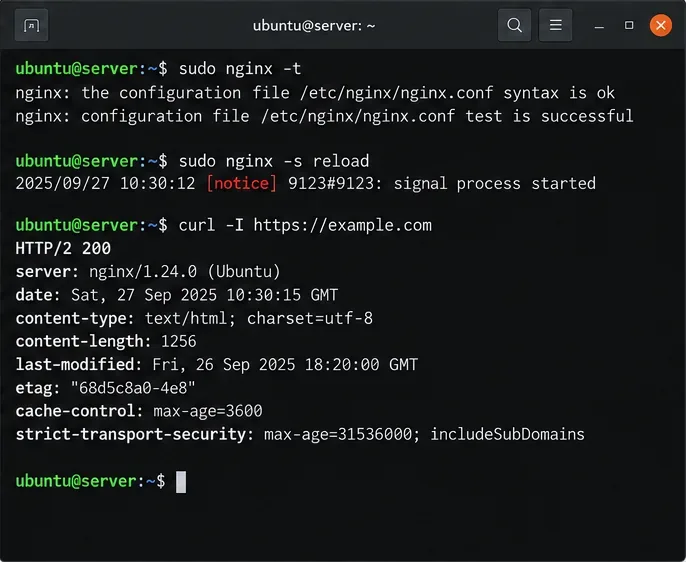
Testa konfigurationen innan du laddar om NGINX:
sudo nginx -t
sudo nginx -s reload
NGINX-dokument -tsom en syntax- och refererad filkontroll och -s reloadsom signalen som laddar om konfigurationen genom att starta nya arbetare och smidigt stänga av gamla.
Efter att du har korrigerat uppströmssökvägen, testa NGINX-konfigurationen, ladda om den och verifiera att den offentliga slutpunkten returnerar ett normalt svar.
Stanna inte vid "startsidan laddas". Testa om rutten som ursprungligen misslyckades, inklusive dess HTTP-metod och eventuell begäran. Om 502-felet bara inträffade vid uppladdningar, API-anrop, stora rapporter eller WebSockets, testa samma trafikmönster.
Vad händer om direkta Node.js-förfrågningar fungerar men NGINX fortfarande returnerar 502?
Det resultatet minskar problemet avsevärt. Kontrollera dessa punkter i ordning:
Bekräfta det aktiva serverblocket. Kör sudo nginx -Toch se till att de förväntade server_nameoch locationhanterar begäran.
Bekräfta det exakta uppströmsmålet. Adressen proxy_passmåste matcha det som är tillgängligt från NGINX, inte bara det som fungerar från din bärbara dator eller en annan container.
Kontrollera protokollmatchningen. Om uppströmsservern förväntar sig HTTPS men NGINX använder http://, eller vice versa, korrigera schemat och konfigurera sedan uppströms TLS avsiktligt.
Leta efter återställningar av programanslutningar. Kontrollera Node.js-processloggarna med samma tidsstämpel som NGINX-felet. En krasch eller avbruten anslutning kräver en åtgärd på programsidan.
Kontrollera specialiserad trafik. WebSockets, strömmande svar, stora förfrågningar och ovanligt långsamma hanterare kan behöva andra proxyinställningar än ett enkelt JSON API.
Om NGINX och Node.js är separerade av en brandvägg, Kubernetes-tjänst, lastbalanserare, service mesh eller annan proxy, kanske det felande hoppet inte är den lokala NGINX-till-nod-anslutningen. Testa varje hopp oberoende av varandra istället för att anta att den synliga NGINX-servern är källan till felet.
Bör du starta om Node.js eller NGINX först?
En omstart är lämplig när du har bevis på att en process har stoppats, är ohälsosam eller kör en inaktuell konfiguration. Det är inte den bästa första diagnostiska åtgärden eftersom det kan radera ledtrådar och tillfälligt få ett intermittent problem att försvinna.
Om Node-porten saknas, kontrollera din processhanterare eller containerloggar, korrigera programmets startproblem och starta sedan tjänsten. Om du bara ändrade NGINX-konfigurationen, använd den nginx -tinnan du laddar om. Om du ändrade Node.js-kod eller miljövariabler, starta om Node-tjänsten med den handledare som din distribution faktiskt använder, till exempel systemd, en containerorkestrator eller en annan processhanterare.
För Node.js produktionsversion, verifiera även att du använder en versionslinje som stöds. Från och med september 2026 listar den officiella Node.js-versionssidan Node.js 24 och 22 som LTS-linjer och rekommenderar att produktionsapplikationer använder aktiva LTS- eller underhålls-LTS-versioner. Kontrollera aktuell status på den officiella Node.js-versionssidan istället för att förlita dig på en gammal handledning.
En kompakt NGINX 502 beslutstabell
Testa
Resultat
Sannolik riktning
curluppströms direkt
Anslutning nekad
Noden lyssnar inte där, fel adress/port eller fel containernamnrymd.
curluppströms direkt
HTTP 200
Fokusera på NGINX-konfiguration, nätverkskontext, protokoll, rubriker eller ruttspecifikt beteende.
NGINX-fellogg
Uppströms timeout
Mät anslutning och applikationens svarstid innan du ändrar timeout-värden.
Använd appens tjänstnamn och det delade containernätverket när tjänsterna är separata.
Endast WebSocket-rutten misslyckas
Vanliga HTTP-rutter fungerar
Kontrollera uppgradering/anslutningsvidarebefordran och läsningstidsgränsbeteende.
nginx -t
Misslyckas
Åtgärda syntax- eller refererade filfel innan du laddar om.
Slutlig egenkontroll
Du har förmodligen åtgärdat grundorsaken, snarare än att bara undertrycka symptomet, när alla följande är sanna:
Node.js-uppströmsen svarar direkt från samma nätverkskontext som NGINX använder.
Nodlyssnaren kommer proxy_passöverens om protokoll, adress och port.
NGINX-felloggen registrerar inte längre uppströmsanslutningsfel för den berörda rutten.
nginx -tlyckas före varje konfigurationsladdning.
Den ursprungliga misslyckade begäran – inte bara hemsidan – lyckas nu via NGINX.
Timeouts ändrades endast när loggar och uppmätt programbeteende motiverade ändringen.
Containerdistributioner använder tjänst-till-tjänst-nätverk snarare än att anta att 127.0.0.1de korsar containergränser.
Det mest tillförlitliga felsökningsmönstret är därför: testa noden direkt, läs NGINX-felet, matcha uppströmsadressen med den faktiska nätverkstopologin, validera och ladda sedan om . En 502 är ett gateway-symptom. Den användbara frågan är alltid vilket hopp som misslyckades och vad loggen säger om det felet.