Slik løser du “PyTorch CUDA Out of Memory” under modelltrening
En PyTorch-treningskjøring kan fungere i flere steg og deretter stoppe med torch.OutOfMemoryError eller en melding som CUDA out of memory. Tried to allocate .... Den umiddelbare årsaken er enkel: den neste CUDA-allokeringen fikk ikke plass. Det nyttige spørsmålet er hvorfor den ikke fikk plass.
Under trening kan GPU-minne inneholde modellparametere, gradienter, optimertilstand, inndata-tensorer, midlertidige arbeidsområder og aktiveringer lagret for bakoverpropagering. PyTorch bruker også en cachelagret allokatorklasse, så minne som vises som “reservert” er ikke identisk med minne som for øyeblikket er opptatt av aktive tensorer. Denne distinksjonen er viktig når du skal avgjøre om du skal redusere arbeidsbelastningen eller undersøke allokatorfragmentering.
Denne veiledningen følger den gjeldende PyTorch-dokumentasjonen og bruker de gjeldende AMP-API-navnene. Spesielt dokumenterer PyTorch nå torch.amp.autocast("cuda") og torch.amp.GradScaler("cuda"); de eldre torch.cuda.amp.*-inngangspunktene er foreldet. Se PyTorch Automatic Mixed Precision-dokumentasjon.
Rask triage: hvilken type OOM har du med å gjøre?
Symptom
Sannsynlig retning
Beste første handling
OOM skjer ved første fremoverpass
Det aktive arbeidssettet er for stort
Reduser mikrobatchstørrelse eller inndatastørrelse; verifiser at modellen selv får plass.
Prøv AMP, aktiverings-sjekkpointing og en mindre mikrobatch.
Minnet øker hver iterasjon
En tensor eller beregningsgraf kan være beholdt
Undersøk lister, metrikker, bufrede utdata og referanser til tap-tensorer.
Allokert minne er moderat, men reservert minne er mye større
Caching eller fragmentering kan være relevant
Undersøk memory_summary() før du endrer allokatorinnstillinger.
En annen prosess bruker allerede betydelig VRAM
Ikke alt GPU-minne tilhører denne treningsprosessen
Identifiser prosessen og frigjør den GPU-en eller planlegg jobben et annet sted.
AI-generert illustrasjon av en typisk CUDA out-of-memory-melding. De nøyaktige tallene varierer etter modell, GPU og treningssteg.
Steg 1: Mål minne før du endrer treningsoppskriften
Begynn med å registrere batchstørrelse, inndatadimensjoner, presisjon og punktet der feilen skjer. Undersøk deretter både minne for aktive tensorer og allokator-reservert minne. PyTorch eksponerer memory_allocated(), memory_reserved(), toppvarianter og memory_summary(). Den gjeldende dokumentasjonen for CUDA-minnehåndtering forklarer at den cachelagrede allokatoren beholder gjenbrukbare blokker, noe som er grunnen til at ubrukt reservert minne fortsatt kan vises som brukt i GPU-overvåkingsverktøy. PyTorch CUDA-minnehåndtering.
Hvis en enkel oppsummering ikke er nok, kan PyTorch fange allokatorsnapshotter for dypere analyse. Minneverktøyene kan registrere allokeringshistorikk og produsere et snapshot som kan inspekteres med PyTorchs minnevisualiserer. PyTorch merker at disse verktøyene ser minne administrert av PyTorch-allokatoren; allokeringer gjort direkte av andre CUDA-biblioteker vises kanskje ikke der. PyTorch-veiledning for å forstå CUDA-minnebruk.
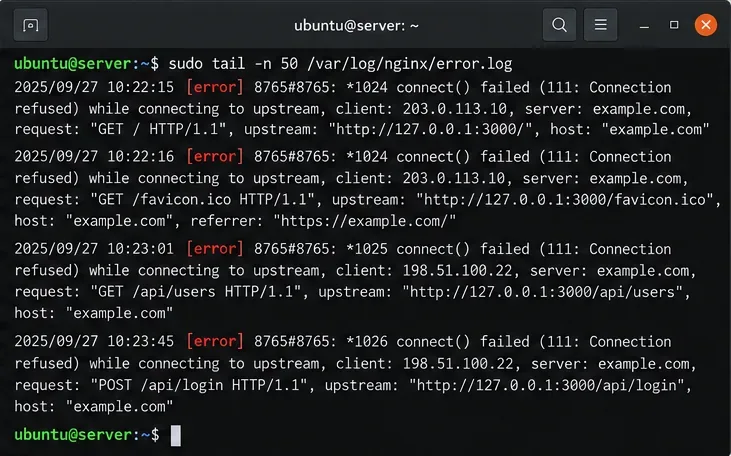
AI-generert illustrasjon av sjekk av samlet GPU-minnebruk med nvidia-smi; bruk den sammen med PyTorch-allokatorstatistikk for å se om en annen prosess konsumerer VRAM.
Behandle ikke torch.cuda.empty_cache() som en generell OOM-løsning
torch.cuda.empty_cache() frigjør ubrukte cachelagrede blokker slik at andre GPU-applikasjoner kan bruke dem. PyTorch sier uttrykkelig at det ikke frigjør minne opptatt av aktive tensorer og øker derfor ikke mengden GPU-minne tilgjengelig for PyTorch for tensorer som fortsatt er i live. Det kan være nyttig mellom separate eksperimenter eller etter sletting av store objekter, men det er ikke en erstatning for å redusere det aktive minnefotavtrykket.
Steg 2: Reduser det aktive arbeidssettet først
Den mest pålitelige første løsningen er vanligvis en mindre mikrobatch: antall prøver behandlet av ett fremover-/bakoverpass. Aktiveringsminne vokser vanligvis med batchstørrelse, bildeoppløsning, sekvenslengde og andre inndatadimensjoner. Hvis modellen trener ved batchstørrelse 32 men feiler ved 64, er reduksjon av batchen ikke en workaround i negativ forstand; det er en direkte reduksjon av toppminnebehovet.
AI-generert illustrasjon av reduksjon av batchstørrelsen per steg for å senke topp CUDA-minnebruk.
For bilder kan senking av romlig oppløsning eller beskjæringsstørrelse gjøre en stor forskjell. For transformere og andre sekvensmodeller kan reduksjon av sekvenslengde være enda viktigere fordi noen mellomliggende tensorer vokser sterkt med sekvenslengden. Den nøyaktige skaleringen avhenger av arkitekturen, så mål i stedet for å anta.
Sørg også for at evalueringskoden ikke bygger gradienter unødvendig. PyTorchs ytelsesveiledning anbefaler å deaktivere gradientberegning for validering eller inferanse når gradienter ikke er nødvendig, fordi autograd ellers lagrer mellomliggende buffere. Et typisk mønster er:
model.eval()
with torch.no_grad():
    for x, y in val_loader:
        x = x.cuda(non_blocking=True)
        y = y.cuda(non_blocking=True)
        pred = model(x)
Under trening, bruk optimizer.zero_grad(set_to_none=True) med mindre algoritmen din er avhengig av den atferdsmessige forskjellen mellom en nullgradient og en None-gradient. PyTorchs optimertilstandsdokumentasjon sier at å sette gradienter til None generelt har et lavere minnefotavtrykk og kan forbedre ytelsen beskjedent. PyTorch optimertilstand zero_grad-dokumentasjon.
Steg 3: Behold en større effektiv batch med AMP og gradientakkumulering
Bruk Automatic Mixed Precision når modellen støtter det
Automatic Mixed Precision (AMP) kjører kvalifiserte operasjoner i lavere presisjon mens operasjoner som trenger mer rekkevidde eller presisjon beholdes i passende typer. PyTorch dokumenterer at AMP kan forbedre ytelsen og redusere minnefotavtrykket for mange CUDA-arbeidsbelastninger, men det er ikke numerisk egnet for hver modell. Spesielt advarer PyTorch om at noen modeller foruttrenet i bfloat16 kan overflyte i float16.
Et gjeldende CUDA AMP-treningsmønster er:
scaler = torch.amp.GradScaler("cuda")

for inputs, targets in train_loader:
    inputs = inputs.cuda(non_blocking=True)
    targets = targets.cuda(non_blocking=True)
    optimizer.zero_grad(set_to_none=True)

    with torch.amp.autocast("cuda", dtype=torch.float16):
        outputs = model(inputs)
        loss = loss_fn(outputs, targets)

    scaler.scale(loss).backward()
    scaler.step(optimizer)
    scaler.update()
PyTorch anbefaler å kjøre fremoverpasset og tapet under autocast, og deretter forlate autocast-konteksten før bakoverpropagering. Hvis float16 produserer ustabilitet, undersøk om bfloat16 er støttet og hensiktsmessig for maskinvaren og modellen din, i stedet for å anta at alle blandet presisjon-moduser oppfører seg identisk.
Bruk gradientakkumulering når du trenger en større effektiv batch
Gradientakkumulering behandler flere mindre mikrobatcher før optimertilstanden oppdateres. Hvis mikrobatchen er 4 og du akkumulerer 8 steg, er den effektive batchen for én optimertilstandsoppdatering 32 prøver per arbeider, forutsatt at hver mikrobatch har fire prøver og at dataparallelloppsettet ikke endrer denne aritmetikken.
accum_steps = 8
optimizer.zero_grad(set_to_none=True)

for step, (inputs, targets) in enumerate(train_loader):
    inputs = inputs.cuda(non_blocking=True)
    targets = targets.cuda(non_blocking=True)

    with torch.amp.autocast("cuda", dtype=torch.float16):
        outputs = model(inputs)
        loss = loss_fn(outputs, targets) / accum_steps

    scaler.scale(loss).backward()

    if (step + 1) % accum_steps == 0:
        scaler.step(optimizer)
        scaler.update()
        optimizer.zero_grad(set_to_none=True)
AI-generert illustrasjon av gradientakkumulering, som bytter flere fremover-/bakoversteg mot en større effektiv batch uten å holde hele batchen i VRAM samtidig.
For produksjonskode, håndter også et siste delvis akkumuleringsvindu når antall batcher ikke er delelig med accum_steps. Hvis du bruker distribuert trening, kan gradientssynkroniseringsatferd endre minne-/ytelsesbytteforholdet, så følg den distribuerte API-ens akkumuleringsveiledning i stedet for å kopiere en enkelt-GPU-løkke uendret.
Steg 4: Bytt beregning mot minne, og undersøk deretter beholdning og fragmentering
Aktiverings-sjekkpointing
Aktiverings-sjekkpointing reduserer minne ved å ikke holde utvalgte fremoveraktiveringer i live til bakoverpropagering. I stedet beregner PyTorch dem på nytt under bakoverpropagering. Dette bytter ytterligere beregning mot et lavere aktiveringsminnefotavtrykk. Den gjeldende PyTorch-sjekkpointdokumentasjonen anbefaler å eksplisitt sende use_reentrant=False. PyTorch aktiverings-sjekkpointdokumentasjon.
from torch.utils.checkpoint import checkpoint

def forward(self, x):
    x = checkpoint(self.block1, x, use_reentrant=False)
    x = checkpoint(self.block2, x, use_reentrant=False)
    return self.head(x)
Sjekkpoint-lag med store lagrede aktiveringer og akseptabel beregningskostnad. Anta ikke at sjekkpointing av hver operasjon er optimal; det kan bremse treningen betydelig.
Se etter tensorer som holder beregningsgrafer i live
Hvis minnet vokser hver iterasjon i stedet for å toppe på omtrent samme nivå, undersøk Python-referanser. Et vanlig mønster er å lagre graf-tilkoblede tensorer i en liste:
# Risikabelt hvis beholdt i mange steg:
loss_history.append(loss)

# Lagre et Python-tall i stedet:
loss_history.append(loss.item())
Det samme problemet kan skje når du bufrer modellutdata, oppmerksomhetskart, skjulte tilstander eller valideringstensorer uten å koble dem fra eller flytte dem av GPU-en. Slett referanser du ikke lenger trenger, og bruk detach() kun når du bevisst ønsker en tensor koblet fra autograd.
Juster allokatoren kun etter at statistikken peker på fragmentering
Gjeldende PyTorch-dokumentasjon foretrekker miljøvariabelen PYTORCH_ALLOC_CONF. Den eldre PYTORCH_CUDA_ALLOC_CONF forblir et alias for bakoverkompatibilitet. Denne navngivningsdetaljen endret seg i den gjeldende dokumentasjonen, så nye konfigurasjoner bør bruke det foretrukne navnet. PyTorch CUDA-miljøvariabler.
To allokatoralternativer er spesielt relevante:
expandable_segments:True er eksperimentelt og er designet for å redusere ubrukelige minnefliser når allokeringsstørrelser endres, for eksempel arbeidsbelastninger der batch- eller tensorstørrelser varierer.
max_split_size_mb kan redusere fragmentering med den innebygde allokatoren, men PyTorch beskriver det uttrykkelig som en siste utvei for arbeidsbelastninger som feiler med OOM mens de viser en stor mengde inaktive split-blokker. Det kan også skade ytelsen og ignoreres av cudaMallocAsync-backenden.
# Eksempel for en arbeidsbelastning med varierende allokeringsstørrelser:
export PYTORCH_ALLOC_CONF=expandable_segments:True
Kopier ikke allokatorflagg fra en annen maskin uten å sjekke memory_summary() eller et snapshot. Et ekte kapasitetsproblem – der aktive tensorer allerede fyller GPU-en – vil ikke løses av fragmenteringsjustering.
Når én GPU fortsatt ikke får plass til modellen
Hvis én prøve ved den minste praktiske inndatastørrelsen fortsatt OOM-er, kan problemet være modellen og optimertilstanden i stedet for batchen. På det tidspunktet, vurder en mindre arkitektur, lavere presisjonsparametere der det er numerisk hensiktsmessig, CPU/offload-strategier eller shardet distribuert trening.
PyTorchs Fully Sharded Data Parallel (FSDP) kan shard modellparametere på tvers av dataparallelle arbeidere, og FULL_SHARD-strategien sharder også gradienter og optimertilstander. Dette kan redusere minne per GPU sammenlignet med fullt replikert dataparallellitet, på bekostning av kommunikasjon og mer kompleks treningsatferd. PyTorch FSDP-dokumentasjon.
Praktisk rekkefølge av operasjoner
Prioritet
Endring
Minnefordel
Hovedbytteforhold
1
Reduser mikrobatch eller inndatastørrelse
Senker direkte det aktive arbeidssettet
Kan senke gjennomstrømningen eller endre optimeringsatferd
2
Bruk AMP
Kan redusere aktiverings-/tensorminne
Krever numerisk validering
3
Bruk gradientakkumulering
Holder mikrobatcher små mens en større effektiv batch beholdes
Flere steg per optimertilstandsoppdatering
4
Bruk aktiverings-sjekkpointing
Reduserer lagrede aktiveringer
Ekstra beregning
5
Fjern beholdte tensorer/grafere
Stopper utilsiktet vekst
Krever kodeinspeksjon
6
Juster allokatorinnstillinger
Kan hjelpe fragmenteringsbundne tilfeller
Arbeidsbelastningsspesifikt; kan redusere ytelsen
7
Shard eller endre modellen
Kan redusere minne for parametere/tilstand per GPU
Høyest kompleksitet
Sjekkliste: hvordan vite at OOM faktisk er løst
Kjør flere representative treningsiterasjoner, ikke bare ett vellykket fremoverpass.
Tilbakestill og registrer max_memory_allocated() slik at du kjenner den nye toppen.
Bekreft at GPU-minnet når et stabilt område i stedet for å øke hver iterasjon.
Valider tap og gradienter etter at blandet presisjon er aktivert.
Bekreft at gradientakkumulering bevarer optimertilstandsoppdateringsplanen du tilsiktet.
Kjør et valideringspass under torch.no_grad() når gradienter ikke er påkrevd.
Hvis du endret allokatorinnstillinger, sammenlign minnestatistikk og gjennomstrømning før og etter.
Kall ikke problemet løst kun fordi nvidia-smi viser mindre reservert minne etter empty_cache(); selve treningsarbeidsbelastningen må fullføre ved sin normale topp.
En CUDA OOM bør best behandles som et minnebudsjetproblem, ikke som en enkelt PyTorch-feil. Mål toppen, reduser det levende arbeidssettet først, bruk deretter blandet presisjon, akkumulering og sjekkpointing som bevisste bytteforhold. Gå kun til allokatorjustering når allokatorstatistikken indikerer fragmentering, og gå til sharding eller en annen modell når modellen selv ikke lenger får plass komfortabelt på én GPU.