Sākums
» Pamatzināšanas
»
Kā novērst Kubernetes CrashLoopBackOff lokālajā Minikube
Kā novērst Kubernetes CrashLoopBackOff lokālajā Minikube
Mērķis nav tikai panākt, lai CrashLoopBackOff pazustu uz dažām sekundēm. Labs risinājums nodrošina, ka konteiners turpina darboties, Pods ir gatavs (Ready), kad tam jāsaņem trafiks, pārtrauc restartu skaita pieaugumu un rada žurnālus, kas parāda normālu lietotnes palaišanu. Lokālajā Minikube pirms klastera pārbūvēšanas ir jāpārliecinās, ka pats Minikube klasteris ir vesels.
Kubernetes pašreizējā dokumentācija apraksta CrashLoopBackOff kā atpakaļskaitīšanas nosacījumu, kas parādās, kad konteiners atkārtoti startē, neizdodas un tiek restartēts. Kubernetes pakāpeniski aizkavē papildu restartus, lai izvairītos no ciešas kļūdu cilpas. Tādējādi šis apzīmējums ir atkārtotu konteinera kļūdu simptoms, nevis pati pamatcēlonis. Skatiet Kubernetes Pod dzīves cikla dokumentāciju.
Šajā rokasgrāmatā tiek izmantotas četras diagnostikas fāzes. Sekojiet tām secībā un apstājieties, kad esat identificējis un izlabojis faktisko cēloni. Minikube ir paredzēts lokālai mācībai un izstrādei, tāpēc tā pati lietotnes līmeņa diagnostika attiecas uz citiem Kubernetes klasteriem, savukārt Minikube specifiskie atjaunošanas soļi ne vienmēr ir piemēroti ražošanas videi. Skatiet pašreizējo Minikube starta dokumentāciju.
Kā izskatās veiksmīgs labojums?
Izmantojiet novērojamus pazīmes, nevis vienu zaļu statusa rindu:
Skartais konteiners paliek darbspējīgā stāvoklī pietiekami ilgi, lai pabeigtu normālu startēšanu.
Pods kļūst Ready (Gatavs), ja no tā tiek sagaidīts, ka tas apkalpos trafiku.
Restartu skaits jūsu novērošanas periodā vairs nepalielinās.
kubectl logs parāda normālu startēšanas ceļu, nevis atkārtotu to pašu fatālo kļūdu.
Dzīvības (Liveness) un starta (Startup) zondes, ja tās ir konfigurētas, pārstāj neizdoties.
Lietotne var sasniegt pakalpojumus vai atkarības, kas tai patiešām ir nepieciešamas.
minikube status parāda veselu lokālo klasteri, ja klastera veselība bija apšaubāma.
Nepieprasiet, lai esoša Pod restartu skaitītājs atgrieztos nullē. Kubernetes reģistrē, cik reižu konteiners ir restartējies šajā Pod; veiksmīgs remonts var atstāt nenulles vēsturisko skaitu. Svarīgi ir tas, ka skaits pārstāj pieaugt. Ja Deployment izvietojums izveido jaunu Pod, šis jaunais Pod parasti sākas ar savu svaigu restartu skaitu.
1. fāze: Pierādiet, kurš konteiners avarē
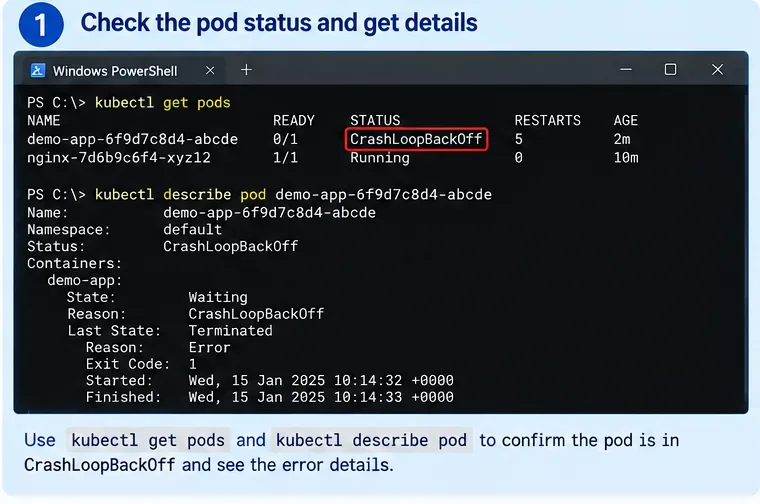
AI ģenerēta Kubernetes problēmu novēršanas termināla ilustrācija. Nosaukumi, datumi un izvade ir piemēri, nevis ekrānuzņēmums no īsta Minikube klastera.
Sāciet ar Pod sarakstu:
kubectl get pods -A
Ja jūs jau zināt nosaukumu telpu (namespace), sašauriniet komandu:
kubectl get pods -n my-namespace
Tad aprakstiet skarto Pod:
kubectl describe pod <pod-name> -n <namespace>
Apskatiet četrus laukus konteinera sadaļā:
State (Stāvoklis) — konteiners var pašlaik būt Waiting (Gaida) ar iemeslu CrashLoopBackOff.
Last State (Pēdējais stāvoklis) — bieži Terminated (Beidzies), kas norāda, kas notika iepriekšējā palaišanā.
Reason and Exit Code (Iemesls un Iziešanas kods) — noderīgas norādes, piemēram, Error vai OOMKilled.
Restart Count (Restartu skaits) un Events (Notikumi) — pierādījumi, ka kļūme atkārtojas, un vai iesaistītas zondes vai kubelet darbības.
Smalka, bet noderīga atšķirība: Pod kopējais fāzes stāvoklis joprojām var būt Running (Darbojas), kamēr viens no tā konteineriem gaida stāvoklī CrashLoopBackOff. STATUS kolonna, ko izvada kubectl get pods, ir ērts cilvēkam lasāms kopsavilkums, nevis pilnīga Pod dzīves cikla stāvokļa diagnostika.
Kvalitātes pārbaude: līdz šīs fāzes beigām jums jāzina precīzs Pod, nosaukumu telpa un konteiners, kas restartējas. Ja Pod ir vairāki konteineri, identificējiet, kurš no tiem neizdodas, pirms lasāt žurnālus.
Ja kļūme patiesībā nav CrashLoopBackOff
Nemēģiniet piespiest visas startēšanas problēmas iekļauties šajā rokasgrāmatā. ImagePullBackOff, ErrImagePull, Pending un ContainerCreating norāda uz dažādiem kļūdu posmiem. Piemēram, attēla vilkšanas problēma rodas pirms jūsu lietotnes procesa startēšanas, tāpēc lietotnes žurnāli var vēl neeksistēt.
Mainiet pieeju, kad: Notikumu sadaļa norāda uz attēla vilkšanu, tilpuma montāžu, plānošanu vai pieņemšanas kļūdām, nevis uz konteineru, kas startē un iziet.
2. fāze: Izlasiet avarējušā konteinera pašreizējos un iepriekšējos žurnālus
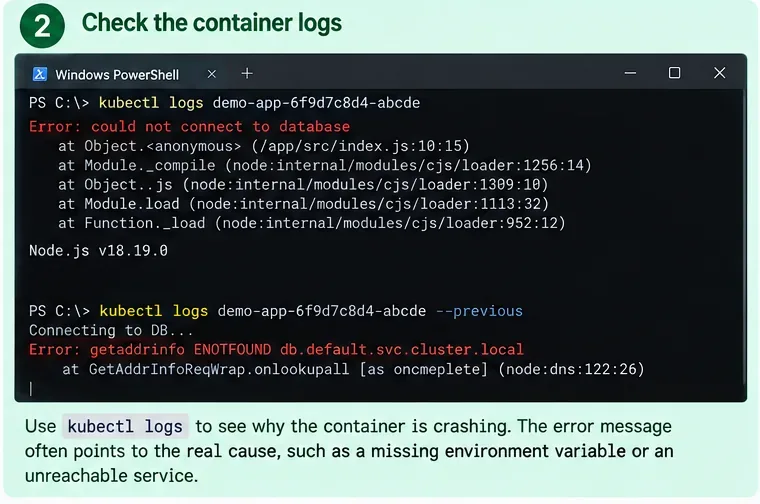
AI ģenerēta ilustrācija par pašreizējiem un iepriekšējiem konteinera žurnāliem. Kļūdu paziņojumi ir piemēri, kas izmantoti, lai demonstrētu diagnostikas darbplūsmu.
Pod ar vienu konteineru sāciet ar:
kubectl logs <pod-name> -n <namespace>
Kad konteiners restartējas ātri, visnoderīgākā komanda bieži vien ir:
kubectl logs <pod-name> -n <namespace> --previous
Kubernetes dokumentācija apraksta --previous kā opciju, kas izvada žurnālus no iepriekšējās konteinera instances Podā. Ja Pod satur vairāk nekā vienu konteineru, norādiet to, kurš neizdodas:
Klasificējiet pirmo nozīmīgo fatālo kļūdu, nevis koncentrējieties uz pēdējo rindu “process exited” (process izbeidzās). Tipiski modeļi ietver:
Pierādījums
Iespējamais virziens
Ko pārbaudīt tālāk
Steka izsekošana kopā ar izejas kodu 1
Lietotnes vai starta konfigurācijas kļūda
Pārbaudiet komandu, argumentus, vidi, failus un atkarību adreses
Reason: OOMKilled
Konteiners pārsniedza savus atmiņas ierobežojumus vai tika nogalināts atmiņas spiediena dēļ
Pārbaudiet ierobežojumus, lietotnes atmiņas lietošanu un Minikube/mezgla kapacitāti
Dzīvības vai starta zondu kļūmes Notikumos
Veselības pārbaude neizdodas pirms vai pēc startēšanas
Pārbaudiet zondes ceļu, portu, laika grafiku un starta ilgumu
DNS vai savienojuma kļūda ar citu pakalpojumu
Nepareizs pakalpojuma nosaukums, nosaukumu telpa, ports vai atkarības gatavība
Pārbaudiet Service objektus un klastera iekšējo DNS
Trūkst faila, atslēgas vai vides mainīgā
ConfigMap, Secret, montāžas vai manifestu neatbilstība
Salīdziniet Deployment ar atsaucēm uz objektiem
Kvalitātes pārbaude: jums jāspēj formulēt falsificējama hipotēze, piemēram, “lietotne izbeidzas, jo DATABASE_HOST norāda uz neesošu Service”, nevis tikai “Kubernetes ir bojāts”.
Neklasificējiet izejas kodu 137 kā vienīgo OOM pierādījumu
Izejas kods 137 parasti parādās, kad process saņem SIGKILL, bet spēcīgāks Kubernetes specifisks signāls ir Last State: Terminated ar Reason: OOMKilled. Kubernetes resursu pārvaldības dokumentācija parāda šo kombināciju, kad konteiners pārsniedz savu atmiņas ierobežojumu. Skatiet Kubernetes resursu pārvaldības dokumentāciju.
Noderīga darbība: balstiet diagnostiku uz izbeigšanās iemeslu un apkārtējiem Notikumiem, nevis pašu numuru 137.
3. fāze: Novērsiet pamatcēloni, nevis atpakaļskaitīšanas taimeru
AI ģenerēta YAML ilustrācija, kas parāda piemēra konfigurācijas labojumu. Lauku vērtības ir ilustratīvas un tās ir jāpielāgo faktiskajam slodzes darbam.
Kad zināt, kāpēc konteiners izbeidzas, mainiet mazāko lietu, kas novērš šo cēloni. Pod atkārtota restartēšana nelabo sliktu komandu, trūkstošu konfigurāciju, neveiksmīgu veselības pārbaudi vai nepietiekamu atmiņu.
Gadījums A: Lietotne mēģina sasniegt citu pakalpojumu localhost
Iekšā normālā Kubernetes Pod, konteineri tajā pašā Pod koplieto tīkla nosaukumu telpu un var sazināties viens ar otru, izmantojot localhost. Datubāze, kas darbojas citā Pod, netiek sasniegta caur jūsu lietotnes localhost. Kubernetes izveido DNS nosaukumus pakalpojumiem (Services), lai slodzes darbi varētu tos atrast pēc pakalpojuma nosaukuma. Skatiet Kubernetes tīkla koncepcijas un DNS pakalpojumiem un Podiem.
Ja jūsu Service ir nosaukts postgres tajā pašā nosaukumu telpā, jūsu lietotne var izmantot:
DATABASE_HOST=postgres
Starp nosaukumu telpām izmantojiet nosaukumu ar nosaukumu telpas kvalifikāciju, piemēram, postgres.data, vai pilnībā kvalificētu pakalpojuma nosaukumu, kas atbilst jūsu klastera domēnam.
Pārbaudiet Service pirms lietotnes rediģēšanas:
kubectl get svc -A
kubectl get endpointslices -n <namespace>
Mainiet pieeju, kad: Service eksistē, bet tam nav izmantojamu aizmugurējo galapunktu. Šādā gadījumā klienta saimniekdatora nosaukuma labošana nav pietiekama; diagnosticējiet servera Deployment vai Service selektoru.
Gadījums B: ConfigMap vai Secret vērtības ir nepareizas
Pārbaudiet atsauces slodzes darba manifestā:
kubectl get deployment <name> -n <namespace> -o yaml
kubectl get configmap -n <namespace>
kubectl get secret -n <namespace>
Kubernetes atbalsta vides mainīgos no env, ConfigMaps un Secrets. Noderīga detaļa ir tā, ka ConfigMap vērtības, kas patērētas kā vides mainīgie, netiek atjauninātas jau darbojošā procesā, kad ConfigMap mainās; Pod ir jāaizstāj. Tas pats attiecas uz Secret vērtībām, kas patērētas kā vides mainīgie. Skatiet Kubernetes ConfigMap dokumentāciju un Kubernetes Secret ievadīšanas dokumentāciju.
Deployment gadījumā, pēc konfigurācijas labošanas, izvietojuma restarts (rollout restart) ir viens veids, kā izveidot jaunus Pod:
Kvalitātes pārbaude: pārliecinieties, ka jaunais Pod faktiski izmanto paredzēto vērtību. Nepieņemiet, ka ConfigMap rediģēšana nekavējoties maina vides mainīgo esošā konteinerā.
Gadījums C: Dzīvības vai starta zonde nogalina lēnu lietotni
Kubernetes definē trīs zondu tipus ar dažādiem mērķiem:
Starta zonde (Startup probe): nosaka, vai lietotnes startēšana ir pabeigta. Kamēr tā ir aktīva, dzīvības un gatavības zondes gaida.
Dzīvības zonde (Liveness probe): nosaka, kad Kubernetes jārestartē iestrēdzis vai neveselīgs konteiners.
Gatavības zonde (Readiness probe): nosaka, vai Pod jāsaņem trafiks caur pakalpojumiem (Services).
Bieži sastopams pārpratums ir tas, ka neveiksmīga gatavības zonde izraisa restartu. Tā nav. Gatavības kļūme padara Pod negatavu; atkārtotas dzīvības vai starta zondu kļūmes var izraisīt konteinera restartus. Skatiet Kubernetes zondu koncepcijas un oficiālo zondu konfigurācijas rokasgrāmatu.
Ja lietotnei likumīgi ir nepieciešama gara startēšana, apsveriet starta zondi ar pietiekamu failureThreshold × periodSeconds laiku, lai aptvertu reālistisku startēšanu. Vienkārši neizslēdziet visas zondes, lai statuss izskatītos zaļš; tas noņem noderīgu veselības aizsardzību.
Kvalitātes pārbaude: zondei jāpārbauda nosacījums, kas atspoguļo tās mērķi, un lietotnei jāizdzīvo normāla startēšana, netiekot priekšlaicīgi nogalinātai.
Gadījums D: Konteiners tiek OOMKilled
Vispirms salīdziniet konteinera atmiņas ierobežojumu ar tā faktiskajām starta vajadzībām. Mazs piemērs:
Ja parādās Reason: OOMKilled un lietotne likumīgi prasa vairāk nekā konfigurētais ierobežojums, uzmanīgi palieliniet ierobežojumu vai samaziniet lietotnes atmiņas lietošanu. Ja pašam Minikube trūkst atmiņas, tikai konteinera ierobežojuma palielināšana var vienkārši pārvietot problēmu uz mezglu.
Pašreizējā Minikube dokumentācija nosaka, ka standarta lokālajai iestatīšanai ir nepieciešami vismaz 2 CPU, 2 GB brīvas atmiņas un 20 GB brīvas diska vietas. Minikube arī atbalsta konfigurētā klastera atmiņas maiņu, kam nepieciešams restarts. Skatiet Minikube pašreizējās starta prasības.
Mainiet pieeju, kad: vairāki nesaistīti Pod neizdodas vai tiek izraidīti, vai pats Minikube ir neveselīgs. Tas norāda uz problēmu, kas pārsniedz viena Deployment atmiņas ierobežojumu.
4. fāze: Pārbaudiet stabilitāti un nosakiet, vai problēma ir klastera līmenī
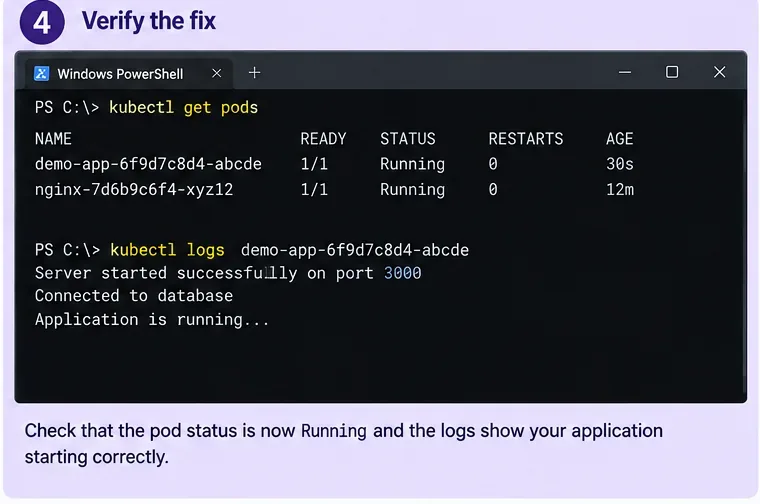
AI ģenerēts pārbaudes piemērs. Reāls labojums ir jāapstiprina, izmantojot jūsu pašu Pod stāvokli, restartu skaitu, zondes, žurnālus un lietotnes uzvedību.
Pēc labojuma piemērošanas novērojiet slodzes darbu, nevis pārbaudiet to tikai vienu reizi:
kubectl get pods -n <namespace> -w
Deployment gadījumā:
kubectl rollout status deployment/<name> -n <namespace>
Tad izlasiet jaunos žurnālus:
kubectl logs <new-pod-name> -n <namespace>
Spēcīgs panākumu signāls nav vienkārši STATUS=Running. Apstipriniet visus šos punktus, ja tie ir piemēroti:
READY sasniedz paredzēto vērtību, piemēram, 1/1.
Restartu skaits paliek nemainīgs, kamēr jūs novērojat normālu startēšanu un trafiku.
Neatrodas jauni BackOff, zondes kļūmes vai OOM notikumi.
Ja vadības plakne vai kodola sistēmas Pod ir neveselīgi, savāciet klastera diagnostiku:
minikube logs --problems
minikube logs
Minikube dokumentācija skaidri norāda, ka minikube logs ir paredzēts lokālā Kubernetes klastera atkļūdošanai, nevis jūsu lietotāja lietotnes kodam. Izmantojiet kubectl logs lietotnes konteineram un minikube logs, kad aizdomas ir par pašu klasteri vai mezglu. Skatiet pašreizējo minikube logs atsauces dokumentāciju un Minikube problēmu novēršanas norādījumus.
Mainiet pieeju, kad: kodola Kubernetes komponentes neizdodas, API serveris nav pieejams, Minikube status ir neveselīgs vai daudzi nesaistīti slodzes darbi vienlaikus neizdodas. Šajā brīdī turpināt rediģēt vienu Deployment, visticamāk, neatrisinās pamatproblēmu.
Vai jums jādzēš un jāizveido Minikube klasteris no jauna?
Tikai pēc tam, kad esat atdalījis lietotnes problēmu no klastera problēmas. Lokālās izstrādes klastera pārizveidošana var būt pamatota, ja klasteris ir vienreizlietojams, jūsu manifesti ir reproducējami un pats Minikube ir bojāts vai nepareizi konfigurēts. Tas ir sliktākais pirmās reakcijas variants lietotnei, kas izbeidzas ar skaidru steka izsekošanu.
Komandas, piemēram, minikube delete, noņem lokālo klasteri. Tas var arī noņemt lokālo Kubernetes stāvokli un datus, kurus jūs gaidījāt saglabāt. Neizmantojiet dzēšanu kā diagnostikas īsceļu, ja pastāvīgais tilpums, lokālā datubāze vai manuāli izveidots resurss satur vienīgo svarīgas lietas kopiju.
Kvalitātes slieksnis pārejai uz klastera pārizveidošanu: jūs esat apstiprinājis, ka kļūmi neizskaidro slodzes darba komanda, konfigurācija, atkarības, zondes vai resursu ierobežojumi; Minikube veselība ir nenormāla; un lokālais stāvoklis ir vai nu dublēts, vai droši reproducējams.
Kompakta lēmumu koks
Atklājums
Nākamā darbība
Ko vēl nedrīkst darīt
Lietotnes steka izsekošana --previous žurnālos
Labojiet lietotni/konfigurāciju, ko norāda kļūda
Dzēst Minikube klasteri
Reason: OOMKilled
Pārbaudiet konteinera ierobežojumus un mezgla/Minikube atmiņu
Pieņemt, ka visi 137 izejas koda gadījumi ir identiski
Atkārtotas dzīvības/starta zondu kļūmes
Labojiet galapunktu, portu, laika grafiku vai starta zondes dizainu
Neatgriezeniski izslēgt katru veselības pārbaudi
Gatavības zonde neizdodas, bet konteiners turpina darboties
Labojiet gatavību vai atkarības pieejamību
Diagnosticēt to kā restarta cēloni bez citiem pierādījumiem
ConfigMap/Secret mainīts, bet vecā vides vērtība paliek
Aizstājiet/restartējiet Pod pēc jaunās konfigurācijas validācijas
Paredzēt, ka procesa vides mainīgie karsti pārlādēsies
Minikube status/kodola Pod neveselīgi
Izmantojiet Minikube diagnostiku un pārbaudiet klastera resursus
Bezgalīgi turpināt rediģēt vienu lietotnes Deployment
Ko šī darbplūsma nevar garantēt
Lokāls CrashLoopBackOff var atklāt lietotnes kļūdu, atkarības kļūmi, zondes kļūdu, resursu ierobežojumu, arhitektūras neatbilstību, trūkstošu failu, atļauju problēmu vai daudzus citus starta traucējumus. Nekāda fiksēta komandu secība nevar identificēt katru cēloni, neizlasot faktisko izbeigšanās iemeslu, Notikumus un žurnālus.
Turklāt, labojums, kas darbojas Minikube, automātiski nepierāda gatavību ražošanai. Ražošanas klasteri var izmantot dažādas glabāšanas klases, drošības politikas, ienākošās kustības kontrolierus, mezglu arhitektūras, tīkla politikas, resursu kvotas, slepeno atslēgu sistēmas vai ārējos pakalpojumus. Minikube ir vērtīgs konteinera līmeņa kļūmes reproducēšanai un izpratnei, bet videi specifiskā uzvedība joprojām ir jātestē tur, kur lietotne faktiski darbosies.
Galīgā pārbaudes saraksts
Identificējiet precīzo neveiksmīgo konteineru un nosaukumu telpu.
Izlasiet Last State, izbeigšanās iemeslu, izejas kodu, restartu skaitu un Notikumus.
Izmantojiet kubectl logs --previous ātri restartējošiem konteineriem.
Pārvērtiet pierādījumus vienā konkrētā pamatcēloņa hipotēzē.
Labojiet konfigurāciju, atkarību adresāciju, zondes vai resursus, balstoties uz šiem pierādījumiem.
Restartējiet vai izvietojiet jaunus Pod, kad mainās uz vidi balstītas ConfigMap vai Secret vērtības.
Pārbaudiet Ready stāvokli un apstipriniet, ka restartu skaits pārstāj pieaugt.
Izmantojiet minikube status un minikube logs tikai tad, kad aizdomas ir arī par klastera veselību.
Pārizveidojiet Minikube tikai tad, kad pats klasteris ir iespējamais problēmas cēlonis un vienreizlietojamais stāvoklis ir aizsargāts.
Uzticamākais veids, kā novērst CrashLoopBackOff, ir uzskatīt to par signālu izmeklēšanai, nevis par diagnozi. Veselīgā problēmu novēršanas procesā katra komanda sašaurina cēloni: Pod stāvoklis pasaka, kas restartējas, iepriekšējie žurnāli pasaka, kāpēc pēdējā palaišana neizdevās, manifests un Notikumi parāda, ko Kubernetes lika konteineram darīt, un Minikube diagnostika pasaka, vai pats lokālais klasteris ir iesaistīts. Kad šie slāņi sakrīt, labojums parasti ir daudz mazāks — un daudz vieglāk pārbaudāms — nekā visu dzēst un pārbūvēt.