Начало
» Основни познания
»
Как да поправите Kubernetes CrashLoopBackOff в локален Minikube
Как да поправите Kubernetes CrashLoopBackOff в локален Minikube
Целта не е просто да накарате CrashLoopBackOff да изчезне за няколко секунди. Доброто решение оставя контейнера да работи, поддържа пода в състояние Ready, когато трябва да получава трафик, спира нарастването на брояча за рестартиране и генерира логове, които показват нормално стартиране на приложението. В локален Minikube трябва също да потвърдите, че самият Minikube клъстер е здрав, преди да го преизградите.
Текущата документация на Kubernetes описва CrashLoopBackOff като условие за изчакване (backoff), което се появява, когато контейнерът многократно стартира, се проваля и се рестартира. Kubernetes постепенно забавя допълнителните рестартирания, за да избегне плътен цикъл на грешки. Етикетът следователно е симптом на повтаряща се грешка в контейнера, а не самата коренова причина. Вижте документацията за жизнения цикъл на пода в Kubernetes.
Това ръководство използва четири диагностични фази. Следвайте ги последователно и спрете, когато идентифицирате и коригирате действителната причина. Minikube е предназначен за локално обучение и разработка, така че същата диагностика на ниво приложение се прилага и за други Kubernetes клъстери, докато специфичните за Minikube стъпки за възстановяване не непременно се прилагат за продукционна среда. Вижте текущата документация за стартиране на Minikube.
Как изглежда успешното поправяне?
Използвайте наблюдаеми признаци, а не единичен зелен статус:
Засегнатият контейнер остава в работещо състояние достатъчно дълго, за да завърши нормалното стартиране.
Подът става Ready, ако се очаква да обслужва трафик.
Броят на рестартиранията спира да нараства по време на периода на наблюдение.
kubectl logs показва нормален път на стартиране, вместо същата фатална грешка да се повтаря.
Сондите за жизненост (liveness) и стартиране (startup), ако са конфигурирани, спират да се провалят.
Приложението може да достигне услугите или зависимостите, от които действително се нуждае.
minikube status показва здрав локален клъстер, когато здравето на клъстера е било под въпрос.
Не изисквайте броячът за рестартиране на съществуващ под да се върне на нула. Kubernetes записва колко пъти контейнерът е бил рестартиран в този под; успешно поправяне може да остави ненулев исторически брой. Важното е броят да спре да нараства. Ако разгръщането на Deployment създаде нов под, този нов под обикновено започва със собствен нов брояч за рестартиране.
Фаза 1: Докажете кой контейнер се срива
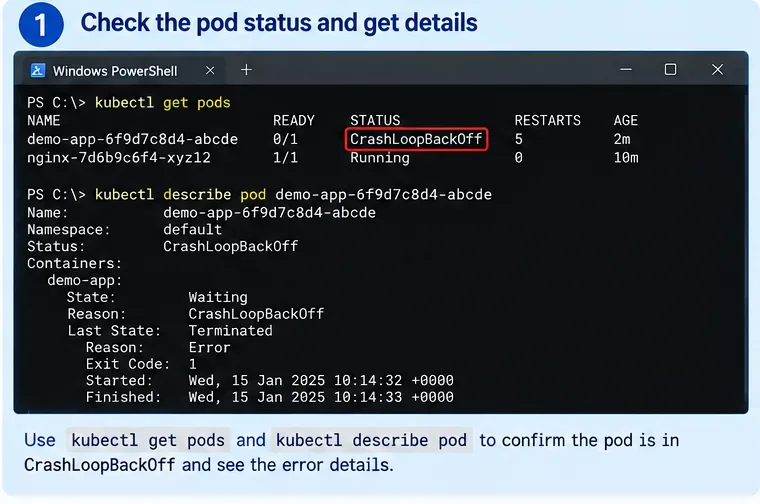
AI-генерирана илюстрация на терминал за отстраняване на неизправности в Kubernetes. Имената, датите и изходът са примери, а не екранна снимка от реален Minikube клъстер.
Започнете със списъка с подове:
kubectl get pods -A
Ако вече знаете именното пространство (namespace), стеснете командата:
kubectl get pods -n my-namespace
След това опишете засегнатия под:
kubectl describe pod <pod-name> -n <namespace>
Погледнете четири полета в секцията с контейнери:
State — контейнерът може в момента да е Waiting с причина CrashLoopBackOff.
Last State — често Terminated, което ви казва какво се е случило при предишното изпълнение.
Reason and Exit Code — полезни улики като Error или OOMKilled.
Restart Count и Events — доказателства, че грешката се повтаря и дали сондите или действията на kubelet са замесени.
Едно фино, но полезно разграничение: общата фаза на пода все още може да бъде Running, докато един от контейнерите му чака в състояние CrashLoopBackOff. Колоната STATUS, отпечатана от kubectl get pods, е удобен човешки четим обобщен статус, а не пълна диагноза на състоянието на жизнения цикъл на пода.
Проверка за качество: до края на тази фаза трябва да знаете точния под, именното пространство и контейнера, който се рестартира. Ако подът има множество контейнери, идентифицирайте кой от тях се проваля, преди да четете логове.
Ако грешката всъщност не е CrashLoopBackOff
Не насилвайте всеки проблем при стартиране в това ръководство. ImagePullBackOff, ErrImagePull, Pending и ContainerCreating сочат към различни етапи на грешка. Например проблем с изтеглянето на изображение възниква, преди процесът на вашето приложение да стартира, така че логът на приложението може все още да не съществува.
Променете подхода, когато: секцията Events сочи към изтегляне на изображения, монтиране на томове, планиране или грешки при приемане (admission), а не към контейнер, който стартира и излиза.
Фаза 2: Прочетете текущите и предишните логове на провалилия се контейнер
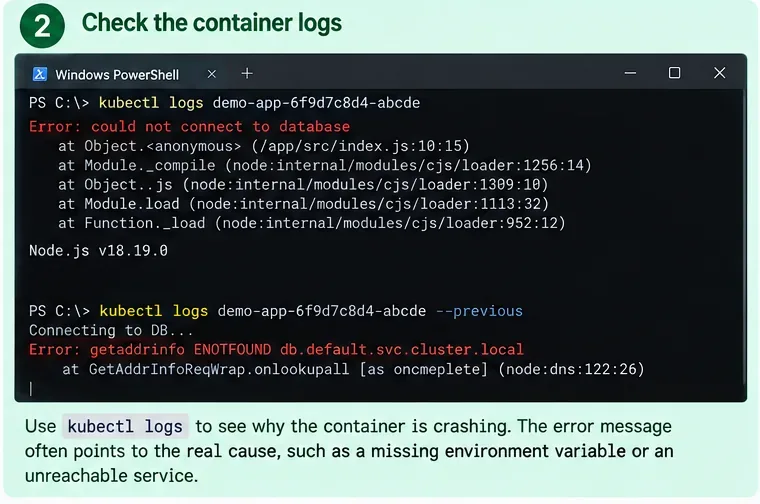
AI-генерирана илюстрация на текущи и предишни логове на контейнер. Съобщенията за грешки са примери, използвани за демонстрация на диагностичния работен процес.
За под с един контейнер, започнете с:
kubectl logs <pod-name> -n <namespace>
Когато контейнерът се рестартира бързо, най-полезната команда често е:
kubectl logs <pod-name> -n <namespace> --previous
Kubernetes документира --previous като опцията, която отпечатва логове от предишния екземпляр на контейнера в пода. Ако подът съдържа повече от един контейнер, посочете провалилия се:
Класифицирайте първата значима фатална грешка, вместо да се фокусирате върху последния ред „process exited“. Типични модели включват:
Доказателство
Вероятна посока
Какво да тествате следващо
Стек трейс плюс изходен код 1
Грешка в приложението или конфигурацията за стартиране
Проверете командата, аргументите, средата, файловете и адресите на зависимостите
Reason: OOMKilled
Контейнерът е надхвърлил ограничението си за памет или е бил убит поради натиск върху паметта
Инспектирайте ограниченията, използването на памет от приложението и капацитета на Minikube/възела
Провали на сонди за жизненост или стартиране в Events
Проверката на здравето се проваля преди или след стартирането
Тествайте пътя на сондата, порта, времето и продължителността на стартиране
DNS или грешка в връзката с друга услуга
Грешно име на услуга, namespace, порт или готовност на зависимостта
Инспектирайте обектите Service и DNS вътре в клъстера
Липсващ файл, ключ или променлива на средата
Несъответствие в ConfigMap, Secret, монтиране или манифест
Сравнете Deployment-а с препратените обекти
Проверка за качество: трябва да можете да формулирате фалсифицируема хипотеза като „приложението излиза, защото DATABASE_HOST сочи към несъществуваща Service“, а не просто „Kubernetes е счупен“.
Не приемайте изходен код 137 сам по себе си за доказателство за OOM
Изходен код 137 обикновено се появява, когато процес получи SIGKILL, но по-силният специфичен за Kubernetes сигнал е Last State: Terminated с Reason: OOMKilled. Документацията на Kubernetes за управление на ресурси показва тази комбинация, когато контейнер надхвърли ограничението си за памет. Вижте документацията на Kubernetes за управление на ресурси.
Полезно действие: базирайте диагнозата на причината за прекратяване и съседните Events, а не на числото 137 само по себе си.
Фаза 3: Поправете кореновата причина, а не таймера за изчакване
AI-генерирана YAML илюстрация, показваща пример за поправка на конфигурацията. Стойностите на полетата са илюстративни и трябва да бъдат адаптирани към действителното натоварване.
След като знаете защо контейнерът излиза, променете най-малкото нещо, което адресира тази причина. Повторното рестартиране на пода не поправя лоша команда, липсваща конфигурация, проваляща се проверка на здравето или недостатъчна памет.
Случай A: приложението се опитва да достигне друга услуга на localhost
Вътре в нормален Kubernetes под, контейнерите в същия под споделят мрежово пространство от имена и могат да комуникират един с друг чрез localhost. База данни, работеща в различен под, не се достига през localhost на вашето приложение. Kubernetes създава DNS имена за Services, така че натоварванията да могат да ги откриват по име на услугата. Вижте концепциите за мрежови връзки в Kubernetes и DNS за Services и Pods.
Ако вашата Service е с име postgres в същото namespace, вашето приложение може да може да използва:
DATABASE_HOST=postgres
В различните namespace-и използвайте име, квалифицирано с namespace, като postgres.data или пълното квалифицирано име на услугата, подходящо за домейна на вашия клъстер.
Проверете Service-а, преди да редактирате приложението:
kubectl get svc -A
kubectl get endpointslices -n <namespace>
Променете подхода, когато: Service-ът съществува, но няма използваем backend endpoints. В този случай поправянето на hostname-а на клиента не е достатъчно; диагностицирайте Deployment-а или селектора на Service-а на сървъра.
Случай B: Стойностите на ConfigMap или Secret са грешни
Инспектирайте препратките в манифеста на натоварването:
kubectl get deployment <name> -n <namespace> -o yaml
kubectl get configmap -n <namespace>
kubectl get secret -n <namespace>
Kubernetes поддържа променливи на средата от env, ConfigMaps и Secrets. Полезен детайл е, че стойностите на ConfigMap, консумирани като променливи на средата, не се актуализират в вече работещ процес, когато ConfigMap се промени; подът трябва да бъде заменен. Същото важи и за стойностите на Secret, консумирани като променливи на средата. Вижте документацията на Kubernetes за ConfigMap и документацията на Kubernetes за инжектиране на Secret.
За Deployment, след коригиране на конфигурацията, rollout restart е един от начините за създаване на нови подове:
Проверка за качество: потвърдете, че новият под действително използва желаната стойност. Не предполагайте, че редактирането на ConfigMap мигновено променя променлива на средата вътре в съществуващ контейнер.
Случай C: сонда за жизненост или стартиране убива бавно приложение
Kubernetes дефинира три типа сонди с различни цели:
Startup probe: определя дали стартирането на приложението е завършило. Докато е активна, сондите за жизненост и готовност изчакват.
Liveness probe: определя кога Kubernetes трябва да рестартира заседнал или нездрав контейнер.
Readiness probe: определя дали подът трябва да получава трафик чрез Services.
Често неразбиране е, че проваляща се сонда за готовност причинява рестартиране. Тя не го прави. Провалът на готовността прави пода неготов; повтарящи се провали на сондите за жизненост или стартиране могат да причинят рестартиране на контейнера. Вижте концепциите за сонди в Kubernetes и официалното ръководство за конфигуриране на сонди.
Ако приложението легитимно се нуждае от дълго стартиране, помислете за startup probe с достатъчно време failureThreshold × periodSeconds, за да покрие реалистичното стартиране. Не просто деактивирайте всички сонди, за да изглежда статусът зелен; това премахва полезна защита на здравето.
Проверка за качество: сондата трябва да тества условие, което отразява нейната цел, и приложението трябва да оцелее при нормално стартиране, без да бъде убито преждевременно.
Случай D: контейнерът е OOMKilled
Първо сравнете ограничението за памет на контейнера с действителните му нужди при стартиране. Малък пример:
Ако се появи Reason: OOMKilled и приложението легитимно изисква повече от конфигурираното ограничение, повишете ограничението внимателно или намалете използването на памет от приложението. Ако самият Minikube е гладен за памет, увеличаването само на ограничението на контейнера може просто да премести проблема към възела.
Текущата документация на Minikube казва, че стандартната локална настройка очаква поне 2 CPU, 2 GB свободна памет и 20 GB свободно дисково пространство. Minikube също така поддържа промяна на конфигурираната памет на клъстера, което изисква рестартиране. Вижте текущите изисквания за стартиране на Minikube.
Променете подхода, когато: няколко несвързани пода се провалят или са изгонени (evicted), или самият Minikube е нездрав. Това сочи отвъд ограничението за памет на един Deployment.
Фаза 4: Потвърдете стабилността и решете дали проблемът е на ниво клъстер
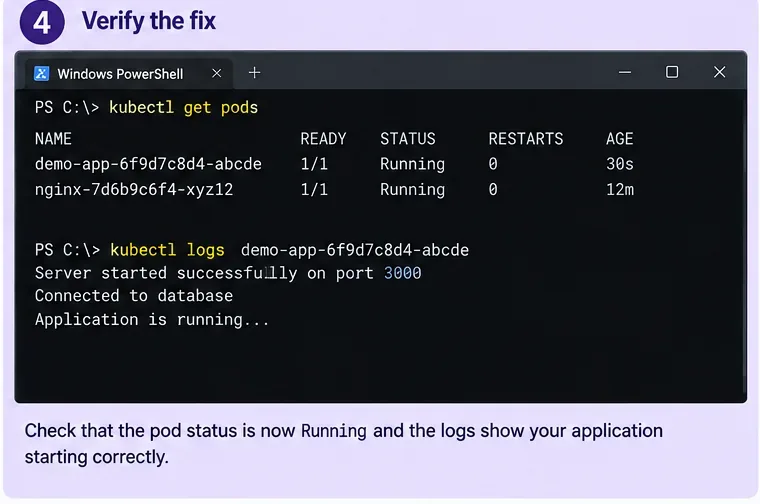
AI-генериран пример за потвърждение. Реалното поправяне трябва да бъде потвърдено от състоянието на вашия под, брояча за рестартиране, сондите, логовете и поведението на приложението.
След прилагане на поправката, наблюдавайте натоварването, вместо да го проверявате само веднъж:
kubectl get pods -n <namespace> -w
За Deployment:
kubectl rollout status deployment/<name> -n <namespace>
След това прочетете новите логове:
kubectl logs <new-pod-name> -n <namespace>
Силен сигнал за успех не е просто STATUS=Running. Потвърдете всички от следните, където е приложимо:
READY достига очакваната стойност, като 1/1.
Броят на рестартиранията остава непроменен, докато наблюдавате нормално стартиране и трафик.
Не се появяват нови събития за BackOff, провал на сонда или OOM.
Логовете на приложението показват успешно инициализиране.
Service-ът или локалният път за достъп действително достигат приложението.
Ако приложението все още се проваля, проверете дали самият Minikube е здрав
Изпълнете:
minikube status
kubectl get pods -A
Командата status на Minikube докладва състоянието на локалния клъстер, включително хоста, kubelet, API сървъра и статуса на kubeconfig. Вижте официалната референция за minikube status.
Ако контролният план или основните системни подове са нездрави, съберете диагностични данни за клъстера:
minikube logs --problems
minikube logs
Документацията на Minikube е ясна, че minikube logs е за дебъгване на локалния Kubernetes клъстер, а не на кода на вашето потребителско приложение. Използвайте kubectl logs за контейнера на приложението и minikube logs, когато клъстерът или възелът сам по себе си е под подозрение. Вижте текущата референция за minikube logs и ръководството за отстраняване на неизправности на Minikube.
Променете подхода, когато: основните компоненти на Kubernetes се провалят, API сървърът е недостъпен, статусът на Minikube е нездрав или много несвързани натоварвания се провалят едновременно. В този момент продължаването на редактирането на един Deployment е малко вероятно да реши основния проблем.
Трябва ли да изтриете и пресъздадете Minikube клъстера?
Само след като сте разграничили проблем с приложението от проблем с клъстера. Преизграждането на локален клъстер за разработка може да е разумно, когато клъстерът е еднократен, вашите манифести са възпроизводими и самият Minikube е повреден или неправилно конфигуриран. Това е лош първи отговор на приложение, което излиза с ясен стек трейс.
Команди като minikube delete премахват локалния клъстер. Това може също да премахне локалното Kubernetes състояние и данни, които сте очаквали да запазите. Не използвайте изтриването като диагностичен кратък път, когато постоянен том, локална база данни или ръчно създаден ресурс съдържат единственото копие на нещо важно.
Праг за качество за преминаване към преизграждане на клъстера: потвърдили сте, че грешката не се обяснява с командата, конфигурацията, зависимостта, сондите или ограниченията за ресурси на натоварването; здравето на Minikube е аномално; и локалното състояние е или архивирано, или безопасно възпроизводимо.
Компактно дърво на решенията
Констатация
Следващо действие
Не правете още
Стек трейс на приложението в логовете --previous
Поправете приложението/конфигурацията, посочена от грешката
Изтрийте Minikube клъстера
Reason: OOMKilled
Проверете ограниченията на контейнера и паметта на възела/Minikube
Приемете, че всички случаи с изход 137 са идентични
Повтарящи се провали на сонди за жизненост/стартиране
Поправете endpoint-а, порта, времето или дизайна на сондата за стартиране
Деактивирайте всяка проверка на здравето за постоянно
Сондата за готовност се проваля, но контейнерът продължава да работи
Поправете готовността или наличността на зависимостта
Диагностицирайте я като причина за рестартиране без други доказателства
ConfigMap/Secret е променен, но старата стойност на env остава
Заменете/рестартирайте пода след валидиране на новата конфигурация
Очаквайте променливите на средата на процеса да се презареждат горещо (hot-reload)
Статусът на Minikube/основните подове са нездрави
Използвайте диагностиката на Minikube и инспектирайте ресурсите на клъстера
Продължавайте да редактирате един Deployment безкрайно
Какво този работен процес не може да гарантира
Локален CrashLoopBackOff може да разкрие бъг в приложението, провал на зависимост, грешка в сондата, ограничение на ресурса, несъответствие в архитектурата, липсващ файл, проблем с разрешенията или много други грешки при стартиране. Никаква фиксирана последователност от команди не може да идентифицира всяка причина без четене на действителната причина за прекратяване, Events и логове.
Освен това, поправка, която работи в Minikube, не доказва автоматично готовност за продукционна среда. Продукционните клъстери могат да използват различни класове за съхранение, политики за сигурност, ingress контролери, архитектури на възли, мрежови политики, квоти за ресурси, системи за secrets или външни услуги. Minikube е ценен за възпроизвеждане и разбиране на грешката на ниво контейнер, но поведението, специфично за средата, все още трябва да бъде тествано там, където приложението ще работи действително.
Краен чеклист
Идентифицирайте точния провалящ се контейнер и namespace.
Прочетете Last State, причината за прекратяване, изходния код, брояча за рестартиране и Events.
Използвайте kubectl logs --previous за контейнери, които се рестартират бързо.
Превърнете доказателствата в една конкретна хипотеза за кореновата причина.
Поправете конфигурацията, адресирането на зависимостите, сондите или ресурсите въз основа на тези доказателства.
Рестартирайте или разгърнете нови подове, когато стойностите на ConfigMap или Secret, базирани на средата, се променят.
Потвърдете състоянието Ready и че броят на рестартиранията спира да нараства.
Използвайте minikube status и minikube logs само когато здравето на клъстера също е под съмнение.
Преизграждайте Minikube само когато самият клъстер е вероятната причина и еднократното състояние е защитено.
Най-надеждният начин за поправяне на CrashLoopBackOff е да го третирате като сигнал за разследване, а не като диагноза. В здравословен процес за отстраняване на неизправности всяка команда стеснява причината: състоянието на пода ви казва какво се рестартира, предишните логове ви казват защо последното изпълнение се е провалило, манифестът и Events показват какво Kubernetes е поискало от контейнера да направи, а диагностиката на Minikube ви казва дали локалният клъстер сам по себе си е замесен. След като тези слоеве се съгласят, поправката обикновено е много по-малка — и много по-лесна за потвърждение — от изтриването и преизграждането на всичко.