Начало
» Основни познания
»
Как да поправите грешката „Nginx 502 Bad Gateway“ при проксиране към Node.js
Как да поправите грешката „Nginx 502 Bad Gateway“ при проксиране към Node.js
NGINX 502 Bad Gateway пред Node.js приложение обикновено означава едно нещо: NGINX е приел заявката на клиента, но не е могъл да получи използваем отговор от приложението, с което е трябвало да се свърже. Следователно най-бързото решение е да не се рестартира всичко или да се повдига всеки път таймаут. Първо проверете дали услугата Node.js е достъпна от същото мрежово местоположение като NGINX, след което използвайте лога за грешки на NGINX, за да изберете следващия ход.
Това ръководство използва четири диагностични стъпки. Командите предполагат Linux хост и Node.js приложение, очаквано на порт 3000. Заменете порта, името на хоста, пътищата и имената на услугите със стойностите във вашето внедряване.
Какво трябва да проверите, преди да смените NGINX?
Първо задайте три въпроса:
Процесът Node.js наистина ли слуша адреса и порта, до които NGINX се опитва да достигне?
Каква точно грешка нагоре по веригата записва логът за грешки на NGINX за неуспешната заявка?
NGINX и Node.js работят ли на един и същ хост, в отделни контейнери или на отделни машини?
Тези отговори са важни, защото един и същ видим за браузъра код 502 може да възникне при много различни условия. Спрян Node процес, грешен proxy_passпорт, неправилно използване на контейнер 127.0.0.1, изчакване на upstream и невалиден upstream отговор нямат едно и също решение.
NGINX документира proxy_passкато директива, която указва протокола и адреса на прокси сървъра. Неговият upstream модул също така предоставя променливи като $upstream_addr, $upstream_status, $upstream_connect_timeи $upstream_response_time, които са полезни, когато се нуждаете от по-подробно регистриране на продукцията. Вижте официалната документация на прокси модула NGINX и документацията на upstream модула NGINX .
Стъпка 1: Може ли да се достигне директно до upstream-а на NGINX?
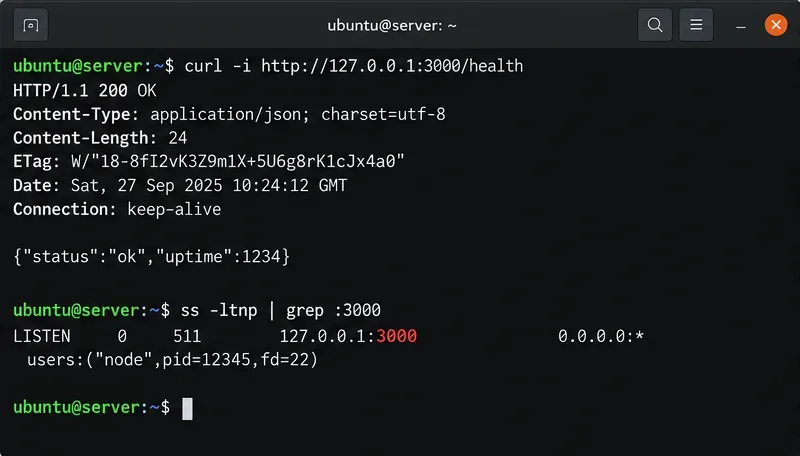
Започнете, като заобиколите обратния прокси. Ако NGINX е на същия хост като Node.js и вашата конфигурация сочи към 127.0.0.1:3000, тествайте точно тази дестинация:
curl -i http://127.0.0.1:3000/health
ss -ltnp | grep ':3000'
Един добър резултат може да върне HTTP 200 от вашето приложение и да покаже слушател на порт 3000. Ако връзката е отказана, не редактирайте времето за изчакване на NGINX все още. Няма услуга за слушане на адреса, който NGINX се опитва да използва, или услугата слуша някъде другаде.
Първата проверка заобикаля NGINX: терминалът извиква директно крайната точка за състояние на Node.js и потвърждава кой адрес слуша на порт 3000.
Ами ако процесът Node.js работи, но портът липсва?
Само работещ процес не е достатъчен. Приложението трябва да е завършило стартирането на сървъра си и успешно да е свързало слушащ сокет. Node.js е документиран server.listen()като операция, която стартира TCP или IPC сървър, слушащ за връзки. Също така се отбелязва, че това EADDRINUSEсе случва, когато друг сървър вече притежава заявения порт. Прегледайте официалната документация за Node.js net сървъра и документацията за Node.js HTTP .
Минимална Node.js HTTP тестова услуга може да изглежда така:
import http from 'node:http';

const server = http.createServer((req, res) => {
  if (req.url === '/health') {
    res.writeHead(200, { 'content-type': 'application/json' });
    return res.end(JSON.stringify({ status: 'ok' }));
  }

  res.writeHead(200, { 'content-type': 'text/plain' });
  res.end('Node.js is running');
});

server.listen(3000, '127.0.0.1', () => {
  console.log('Listening on http://127.0.0.1:3000');
});
Обвързването с 127.0.0.1е подходящо, когато NGINX и Node.js споделят един и същ хост и никоя друга машина не се нуждае от директен достъп до порта на Node. Ако са в отделни контейнери, този адрес има различно значение, което е разгледано по-долу.
Стъпка 2: Какво всъщност казва логът за грешки на NGINX?
След като разберете дали upstream отговаря директно, проверете записа в лога, създаден едновременно с 502. Често срещано местоположение в Linux пакетите е /var/log/nginx/error.log, но действителният път се контролира от error_logдирективата и може да се различава в зависимост от инсталацията.
sudo tail -n 100 /var/log/nginx/error.log
В основната документация на NGINX се посочва, че error_logконтролира местоназначението и тежестта на диагностичния лог. Документацията за командния ред предоставя и възможност nginx -Tза тестване и дъмп на активната конфигурация, което може да ви помогне да намерите неочакван път на лога или блок на сървъра. Вижте документацията за основното регистриране на NGINX и параметрите на командния ред на NGINX .
Вход с отказ за връзка сочи към адреса нагоре по веригата или към наличността на услугата, а не към необходимостта от по-дълъг таймаут на прокси сървъра.
Използвайте съобщението, за да стесните обхвата на проблема:
Това, което виждаш
Най-полезна следваща проверка
Connection refusedпри свързване към upstream
Потвърдете слушателя на Node, порта, адреса, мрежата на контейнера и състоянието на процеса.
Времето за изчакване на връзката нагоре по веригата изтече
Проверете достъпността на маршрутизацията/защитната стена и дали дестинацията изобщо е достъпна.
Времето за четене нагоре по веригата изтича след свързване
Измерете времето за реакция на приложението и проверете бавната работа на Node.js или зависимостите надолу по веригата, преди да увеличите proxy_read_timeout.
Само заявките за WebSocket се провалят
Проверете заглавките WebSocket Upgrade и Connection и поведението на версията на NGINX.
Стъпка 3: Дали proxy_pass сочи към адреса, който Node.js наистина използва?
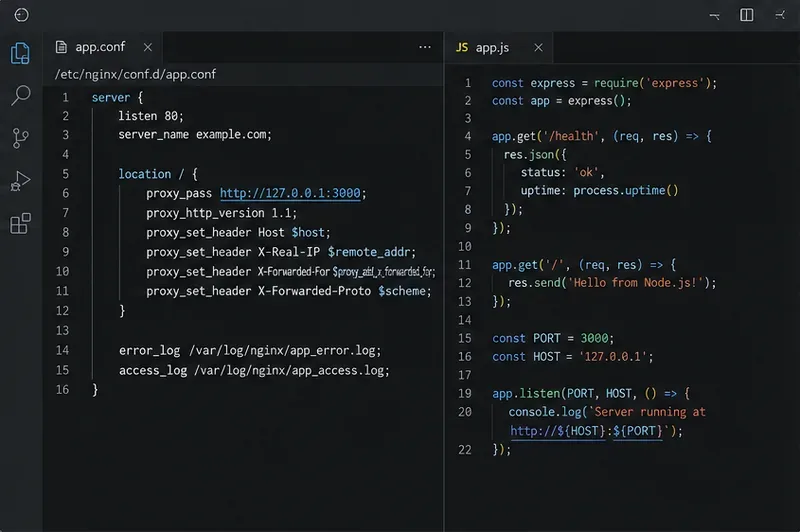
Сравнете слушателя на живо от стъпка 1 с активната конфигурация на NGINX. Конвенционалната конфигурация на един и същ хост изглежда така:
NGINX официално поддържа IP адрес, име на хост, група нагоре по веригата или UNIX-домейн сокет в proxy_pass. Критичното правило е просто: дестинацията трябва да е достъпна от мрежовия контекст на NGINX worker.
Сравнете двете страни на връзката: NGINX upstream target трябва да съвпада с адрес и порт, на които Node.js сървърът действително слуша.
NGINX и Node.js в отделни Docker Compose контейнери ли са?
Ако е така, 127.0.0.1„вътре в NGINX контейнера“ се отнася до самия NGINX контейнер, а не до Node.js контейнера. Документацията на Docker Compose посочва, че услугите в мрежата по подразбиране на Compose са откриваеми по име на услуга. Тя също така препоръчва използването на порта на контейнера за комуникация между услуги, а не порт, публикуван от хоста.
Например, ако услугата Compose е именувана appи Node слуша на контейнерен порт 3000, NGINX може да използва:
location / {
    proxy_pass http://app:3000;
}
И двете услуги трябва да споделят мрежа. Услугата Node също трябва да слуша на интерфейс, достъпен от тази контейнерна мрежа; приложенията обикновено се свързват с 0.0.0.0вътрешността на контейнера за тази цел. Не е задължително да публикувате порт 3000 към хоста само за трафик от NGINX към приложение. Проверете топологията спрямо официалната мрежова документация на Docker Compose .
Трябва ли да използвате localhost или 127.0.0.1?
Ако и двата процеса работят на един и същ хост, всеки от тях може да работи, но не винаги са взаимозаменяеми във всяка среда, защото localhostмогат да се разрешат до IPv4, IPv6 или и двете. Използването на точния адрес, показан от слушателя, премахва една променлива. Node.js документира, че ако аргументът hostе пропуснат, той може да слуша на неопределения IPv6 адрес, ::когато е наличен, или на неопределения IPv4 адрес 0.0.0.0в противен случай.
Ако видите несъответствие, като например NGINX, който се свързва с 127.0.0.1:3000приложението, докато то е достъпно само чрез друго име на хост на контейнер, различен порт или UNIX сокет, поправете адреса, вместо да компенсирате с повторни опити.
По-дългият таймаут наистина ли е правилното решение?
Променяйте времето за изчакване само когато лог файловете показват такова и разбирате защо upstream-ът се нуждае от по-дълго време. NGINX документира по подразбиране proxy_connect_timeout60 секунди и отбелязва, че обикновено не може да надвишава 75 секунди. Също така документира по подразбиране proxy_read_timeout60 секунди, измерени между последователни четения от upstream-а, а не в целия отговор.
Горният пример не е универсална препоръка. Краткото време за изчакване на връзката може да има смисъл за локален upstream, който би трябвало да се свърже почти мигновено, докато по-дългото време за изчакване на четене може да е оправдано за наистина дълга заявка. Но ако приложението е бавно поради блокиран цикъл на събития, застой в базата данни, претоварена зависимост или замряла заявка, увеличаването на времето за изчакване само скрива симптома.
Ами ако само WebSocket връзките получат грешка 502 или прекъсват връзката?
Проксирането чрез WebSocket има допълнителни изисквания, тъй като заглавките Upgradeи Connectionса заглавки hop-by-hop и не се препращат автоматично по обичайния път на обратната прокси. Официалната документация на NGINX за WebSocket показва изрично задаване на тези заглавки.
NGINX също така отбелязва, че неактивна проксирана WebSocket връзка се затваря, ако upstream не изпраща данни в рамките на интервала за изчакване на четене; ping на ниво приложение може да поддържа връзката активна, където е уместно. За текущо поведение и специфични за версията бележки използвайте официалната документация за проксиране на NGINX WebSocket .
Стъпка 4: Как да валидирате корекцията, без да създавате нов прекъсване?
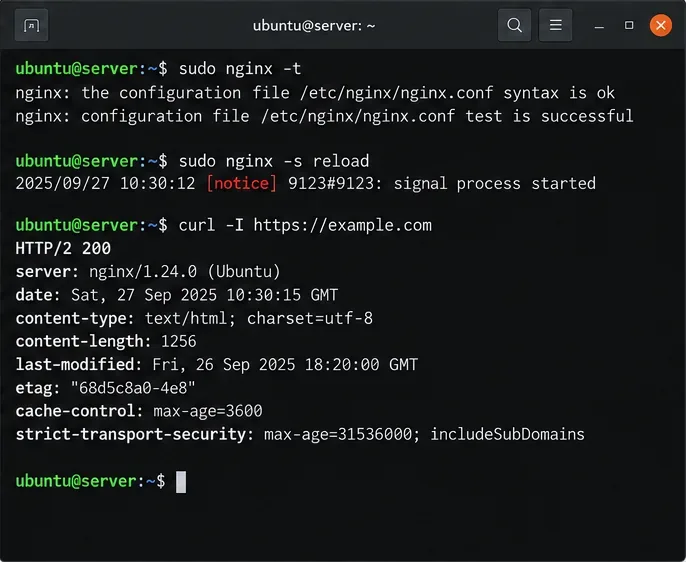
Тествайте конфигурацията преди да презаредите NGINX:
sudo nginx -t
sudo nginx -s reload
NGINX документира -tкато проверка на синтаксиса и референтните файлове и -s reloadкато сигнал, който презарежда конфигурацията, като стартира нови работници и грациозно изключва старите.
След коригиране на пътя нагоре по веригата, тествайте конфигурацията на NGINX, презаредете я и проверете дали публичната крайна точка връща нормален отговор.
Не спирайте на „зареждане на началната страница“. Тествайте отново маршрута, който първоначално е претърпял неуспех, включително неговия HTTP метод и тялото на заявката. Ако грешката 502 се е появявала само при качвания, API извиквания, големи отчети или WebSockets, тествайте същия модел на трафик.
Ами ако директните заявки към Node.js работят, но NGINX все още връща 502?
Този резултат значително стеснява обхвата на проблема. Проверете тези елементи по ред:
Потвърдете активния блок на сървъра. Стартирайте sudo nginx -Tи се уверете, че очакваните server_nameи locationобработват заявката.
Потвърдете точния адрес нагоре по веригата. Адресът в proxy_passтрябва да съвпада с този, който е достъпен от NGINX, а не само с този, който работи от вашия лаптоп или друг контейнер.
Проверете несъответствието на протоколите. Ако upstream очаква HTTPS, но NGINX използва http://, или обратното, коригирайте схемата и след това конфигурирайте upstream TLS умишлено.
Потърсете нулиране на връзките на приложението. Проверете лог файловете на процеса Node.js в същото времево клеймо като грешката NGINX. Срив или прекъсната връзка изисква корекция от страна на приложението.
Проверете специализирания трафик. WebSockets, стрийминг отговори, големи заявки и необичайно бавни обработчици може да изискват различни настройки на прокси сървъра от обикновен JSON API.
Ако NGINX и Node.js са разделени от защитна стена, услуга на Kubernetes, балансьор на натоварването, service mesh или друг прокси, неуспешният hop може да не е локалната връзка NGINX-Node. Тествайте всеки hop поотделно, вместо да приемате, че видимият NGINX сървър е източникът на повредата.
Трябва ли първо да рестартирате Node.js или NGINX?
Рестартирането е подходящо, когато имате доказателства, че даден процес е спрян, не е в добро състояние или изпълнява остаряла конфигурация. Това не е най-доброто първо диагностично действие, защото може да изтрие улики и временно да премахне периодичен проблем.
Ако портът на Node липсва, проверете вашия мениджър на процеси или регистрационни файлове на контейнера, коригирайте проблема със стартирането на приложението и след това стартирайте услугата. Ако сте променили само конфигурацията на NGINX, използвайте nginx -tпреди презареждане. Ако сте променили кода на Node.js или променливите на средата, рестартирайте услугата Node, като използвате супервайзора, който вашето внедряване действително използва, като например systemd, оркестратор на контейнери или друг мениджър на процеси.
За производствена версия на Node.js, проверете също дали сте на поддържана линия за издания. Към септември 2026 г. официалната страница за издания на Node.js посочва Node.js 24 и 22 като LTS линии и препоръчва производствените приложения да използват Active LTS или Maintenance LTS издания. Проверете текущото състояние на официалната страница за издания на Node.js, вместо да разчитате на стар урок.
Компактна таблица за решения NGINX 502
Тест
Резултат
Вероятна посока
curlдиректно нагоре по течението
Връзката е отказана
Възелът не слуша там, грешен адрес/порт или грешно пространство от имена на контейнера.
curlдиректно нагоре по течението
HTTP 200
Фокусирайте се върху конфигурацията на NGINX, мрежовия контекст, протокола, заглавките или специфичното за маршрута поведение.
Журнал на грешките на NGINX
Време за изчакване нагоре по веригата
Измерете свързаността и времето за реакция на приложението, преди да промените стойностите на времето за изчакване.
Използвайте името на услугата за приложения и мрежата от споделени контейнери, когато услугите са отделни.
Само WebSocket маршрутът е неуспешен
Нормалните HTTP маршрути работят
Проверете поведението при пренасочване на надстройка/връзка и времето за четене.
nginx -t
Неуспехи
Поправете синтактичните грешки или грешките в цитираните файлове преди презареждане.
Последна самопроверка
Вероятно сте отстранили първопричината, вместо просто да потиснете симптома, когато всички от следните условия са верни:
Node.js upstream отговаря директно от същия мрежов контекст, който NGINX използва.
Слушателят на Node и proxy_passтой се договарят за протокол, адрес и порт.
Журналът за грешки на NGINX вече не записва неуспехи при свързване нагоре по веригата за засегнатия маршрут.
nginx -tуспява преди всяко презареждане на конфигурацията.
Първоначалната неуспешна заявка – не само началната страница – сега е успешна чрез NGINX.
Времето за изчакване беше променяно само когато лог файловете и измереното поведение на приложението оправдаваха промяната.
Разгръщането на контейнери използва мрежа от услуга към услуга, вместо да се предполага, че 127.0.0.1пресича границите на контейнера.
Следователно най-надеждният модел за отстраняване на неизправности е: тествайте Node директно, прочетете грешката в NGINX, съпоставете адреса на upstream с действителната мрежова топология, след това валидирайте и презаредете . Код 502 е симптом на шлюз. Полезният въпрос винаги е кой хоп е неуспешен и какво казва логът за този неуспех.