Domov
» Základné znalosti
»
Ako opraviť stav CrashLoopBackOff v Kubernetes v lokálnom Minikube
Ako opraviť stav CrashLoopBackOff v Kubernetes v lokálnom Minikube
Cieľom nie je len nechať stav CrashLoopBackOff na pár sekúnd zmiznúť. Dobrá oprava zabezpečí, že kontajner beží, Pod je v stave Ready, keď má prijímať prevádzku, počet reštartov prestane rásť a logy budú ukazovať normálne spustenie aplikácie. V lokálnom Minikube by ste mali pred obnovením klastra tiež overiť, či je samotný klaster Minikube zdravý.
Aktuálna dokumentácia Kubernetes opisuje CrashLoopBackOff ako stav backoff, ktorý sa objaví, keď sa kontajner opakovane spúšťa, zlyháva a je reštartovaný. Kubernetes postupne oneskoruje ďalšie reštarty, aby sa vyhlo tesnej slučke zlyhaní. Tento štítok je preto symptómom opakovaného zlyhania kontajnera, nie samotnou príčinou. Pozri dokumentáciu životného cyklu Podov v Kubernetes.
Táto príručka používa štyri diagnostické fázy. Postupujte podľa nich v poradí a zastavte, keď identifikujete a opravíte skutočnú príčinu. Minikube je určený na lokálne učenie a vývoj, takže rovnaká diagnostika na úrovni aplikácie sa prenáša aj na iné klaster Kubernetes, zatiaľ čo kroky obnovy špecifické pre Minikube sa nemusia vzťahovať na produkčné prostredie. Pozri aktuálnu dokumentáciu spustenia Minikube.
Ako vyzerá úspešná oprava?
Používajte pozorovateľné znaky namiesto jedného zeleného stavového riadku:
Postihnutý kontajner zostáva v bežiacom stave dostatočne dlho na dokončenie normálneho spustenia.
Pod prejde do stavu Ready, ak sa očakáva, že bude obsluhovať prevádzku.
Počet reštartov sa počas vášho obdobia pozorovania nezvyšuje.
kubectl logs ukazuje normálnu cestu spustenia, nie opakujúcu sa rovnakú fatálnu chybu.
Sondy liveness a startup, ak sú nakonfigurované, prestávajú zlyhávať.
Aplikácia sa dokáže pripojiť k službám alebo závislostiam, ktoré skutočne potrebuje.
minikube status ukazuje zdravý lokálny klaster, ak bola otázka zdravia klastra na mieste.
Nevyžadujte, aby sa počítadlo reštartov existujúceho Podu vrátilo na nulu. Kubernetes zaznamenáva, koľkokrát sa kontajner v danom Pode reštartoval; úspešná oprava môže zanechať nenulový historický počet. Dôležité je, že počet prestane rásť. Ak rollout Deploymentu vytvorí nový Pod, tento nový Pod zvyčajne začína s vlastným novým počtom reštartov.
Fáza 1: Dokážte, ktorý kontajner zlyháva
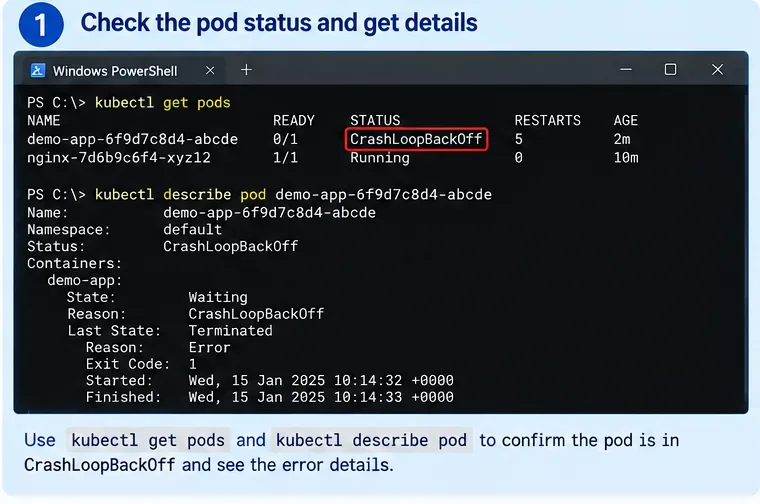
AI-generovaná ilustrácia terminálu na riešenie problémov s Kubernetes. Názvy, dátumy a výstup sú príklady, nie snímka obrazovky zo skutočného klastra Minikube.
Začnite zoznamom Podov:
kubectl get pods -A
Ak už poznáte namespace, zúžte príkaz:
kubectl get pods -n my-namespace
Potom popíšte postihnutý Pod:
kubectl describe pod <pod-name> -n <namespace>
Pozrite sa na štyri polia v sekcii kontajnera:
State — kontajner môže byť momentálne v stave Waiting s dôvodom CrashLoopBackOff.
Last State — často Terminated, čo vám povie, čo sa stalo pri predchádzajúcom behu.
Reason and Exit Code — užitočné stopy ako Error alebo OOMKilled.
Restart Count a Events — dôkazy, že zlyhanie sa opakuje, a či sú zapojené sondy alebo akcie kubeletu.
Jemný, ale užitočný rozdiel: celková fáza Podu môže byť stále Running, zatiaľ čo jeden z jeho kontajnerov čaká v stave CrashLoopBackOff. Stĺpec STATUS vypísaný príkazom kubectl get pods je pohodlné človekom čitateľné zhrnutie, nie kompletná diagnostika stavu životného cyklu Podu.
Kontrola kvality: na konci tejto fázy by ste mali poznať presný Pod, namespace a kontajner, ktorý sa reštartuje. Ak má Pod viac kontajnerov, identifikujte, ktorý zlyháva, skôr než začnete čítať logy.
Ak zlyhanie nie je skutočne CrashLoopBackOff
Nesnažte sa každému problému so spustením prispôsobiť túto príručku. ImagePullBackOff, ErrImagePull, Pending a ContainerCreating ukazujú na iné štádiá zlyhania. Napríklad problém sťahovania obrazu nastáva pred spustením procesu vašej aplikácie, takže logy aplikácie ešte nemusia existovať.
Zmeňte prístup, keď: sekcia Events ukazuje na sťahovanie obrazov, pripájanie zväzkov, plánovanie alebo chyby prijatia (admission), nie na kontajner, ktorý sa spustí a ukončí.
Fáza 2: Čítajte aktuálne a predchádzajúce logy zlyhaného kontajnera
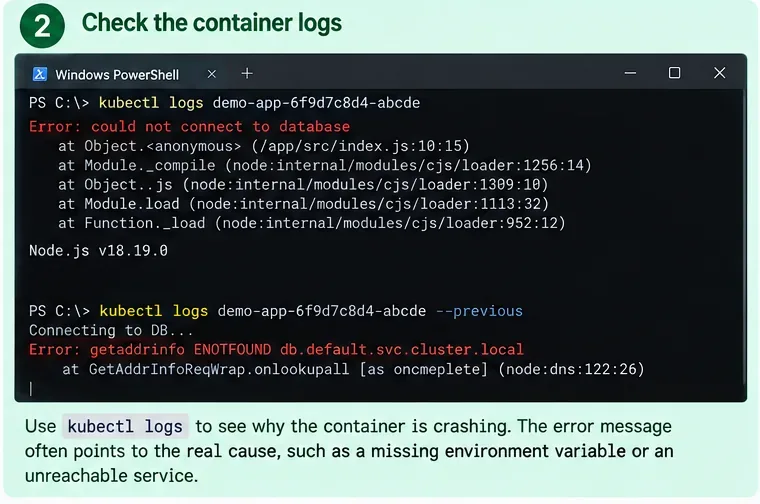
AI-generovaná ilustrácia aktuálnych a predchádzajúcich logov kontajnera. Chybové hlášky sú príklady použité na demonštráciu diagnostického postupu.
Pre Pod s jedným kontajnerom začnite s:
kubectl logs <pod-name> -n <namespace>
Keď sa kontajner reštartuje rýchlo, najužitočnejším príkazom je často:
kubectl logs <pod-name> -n <namespace> --previous
Kubernetes dokumentuje --previous ako možnosť, ktorá vypíše logy z predchádzajúcej inštancie kontajnera v Pode. Ak Pod obsahuje viac ako jeden kontajner, špecifikujte ten zlyhávajúci:
Klasifikujte prvú významnú fatálnu chybu namiesto zamerania sa na posledný riadok „process exited“. Typické vzory zahŕňajú:
Dôkaz
Pravdepodobný smer
Čo testovať ďalej
Stack trace plus exit code 1
Chyba aplikácie alebo konfigurácie spustenia
Skontrolujte príkaz, argumenty, prostredie, súbory a adresy závislostí
Reason: OOMKilled
Kontajner prekročil svoj limit pamäte alebo bol zabitý kvôli tlaku na pamäť
Skontrolujte limity, využitie pamäte aplikáciou a kapacitu Minikube/nódu
Zlyhania sond liveness alebo startup v Events
Kontrola zdravia zlyháva pred alebo po spustení
Otestujte cestu sondy, port, načasovanie a dĺžku spustenia
Chyba DNS alebo pripojenia k inej službe
Nesprávny názov služby, namespace, port alebo pripravenosť závislosti
Skontrolujte objekty Service a DNS v rámci klastra
Chýbajúci súbor, kľúč alebo premenná prostredia
Nesúlad ConfigMap, Secret, mountu alebo manifestu
Porovnajte Deployment s odkazovanými objektmi
Kontrola kvality: mali by ste byť schopní formulovať falsifikovateľnú hypotézu, napríklad „aplikácia sa ukončí, pretože DATABASE_HOST ukazuje na neexistujúcu službu“, nie len „Kubernetes je pokazený“.
Nepovažujte exit code 137 samostatne za dôkaz OOM
Exit code 137 sa bežne objavuje, keď proces dostane signál SIGKILL, ale silnejším signálom špecifickým pre Kubernetes je Last State: Terminated s Reason: OOMKilled. Dokumentácia správy zdrojov Kubernetes ukazuje túto kombináciu, keď kontajner prekročí svoj limit pamäte. Pozri dokumentáciu správy zdrojov Kubernetes.
Užitočná akcia: založte diagnostiku na dôvode ukončenia a okolitých Events, nie na samotnom čísle 137.
Fáza 3: Opravte príčinu, nie časovač backoff
AI-generovaná ilustrácia YAML ukazujúca príklad opravy konfigurácie. Hodnoty polí sú ilustračné a musia byť prispôsobené skutočnej záťaži.
Akonce poznáte dôvod, prečo sa kontajner ukončuje, zmeňte najmenšiu vec, ktorá rieši túto príčinu. Opakované reštartovanie Podu neopraví zlý príkaz, chýbajúcu konfiguráciu, zlyhávajúcu kontrolu zdravia alebo nedostatočnú pamäť.
Prípad A: Aplikácia sa snaží pripojiť k inej službe na localhost
Vnútri normálneho Podu Kubernetes zdieľajú kontajnery v tom istom Pode sieťový namespace a môžu medzi sebou komunikovať cez localhost. Databáza bežiaca v inom Pode nie je dosiahnuteľná cez localhost vašej aplikácie. Kubernetes vytvára DNS názvy pre Služby, aby záťaže mohli byť objavené podľa názvu služby. Pozri koncepty siete Kubernetes a DNS pre Služby a Pod.
Ak je vaša Služba pomenovaná postgres v rovnakom namespace, vaša aplikácia môže byť schopná použiť:
DATABASE_HOST=postgres
Naprieč namespaceami použite názov kvalifikovaný namespaceom, ako je postgres.data, alebo plne kvalifikovaný názov služby vhodný pre doménu vášho klastra.
Overte Službu pred úpravou aplikácie:
kubectl get svc -A
kubectl get endpointslices -n <namespace>
Zmeňte prístup, keď: Služba existuje, ale nemá použiteľné backendové endpointy. V takom prípade oprava hostnameu klienta nestačí; diagnostikujte serverový Deployment alebo selektor Služby.
Prípad B: Hodnoty ConfigMap alebo Secret sú nesprávne
Skontrolujte odkazy v manifeste záťaže:
kubectl get deployment <name> -n <namespace> -o yaml
kubectl get configmap -n <namespace>
kubectl get secret -n <namespace>
Kubernetes podporuje premenné prostredia z env, ConfigMaps a Secrets. Užitočným detailom je, že hodnoty ConfigMap spotrebované ako premenné prostredia sa neaktualizujú v už bežiacom procese, keď sa ConfigMap zmení; Pod musí byť nahradený. To isté platí pre hodnoty Secret spotrebované ako premenné prostredia. Pozri dokumentáciu ConfigMap Kubernetes a dokumentáciu injektáže Secret Kubernetes.
Pre Deployment je po oprave konfigurácie rollout restart jedným zo spôsobov, ako vytvoriť nové Pod:
Kontrola kvality: overte, či nový Pod skutočne používa zamýšľanú hodnotu. Nepredpokladajte, že úprava ConfigMap okamžite zmení premennú prostredia vnútri existujúceho kontajnera.
Prípad C: Sonda liveness alebo startup zabíja pomalú aplikáciu
Kubernetes definuje tri typy sond s rôznymi účelmi:
Startup probe: určuje, či bolo spustenie aplikácie dokončené. Kým je aktívna, sondy liveness a readiness čakajú.
Liveness probe: určuje, kedy má Kubernetes reštartovať zaseknutý alebo nezdravý kontajner.
Readiness probe: určuje, či by mal Pod prijímať prevádzku cez Služby.
Bežným nedorozumením je, že zlyhávajúca readiness sonda spôsobí reštart. Nespôsobuje. Zlyhanie readiness urobí Pod nepripraveným; opakované zlyhania sond liveness alebo startup môžu spôsobiť reštarty kontajnera. Pozri koncepty sond Kubernetes a oficiálnu príručku konfigurácie sond.
Ak aplikácia legitímne potrebuje dlhé spustenie, zvážte startup sondu s dostatočným časom failureThreshold × periodSeconds na pokrytie realistického spustenia. Jednoducho nevypínajte všetky sondy, aby stav vyzeral zelený; tým odstránite užitočnú ochranu zdravia.
Kontrola kvality: sonda by mala testovať podmienku, ktorá odráža jej účel, a aplikácia by mala prežiť normálne spustenie bez toho, aby bola predčasne zabitá.
Prípad D: Kontajner bol OOMKilled
Najprv porovnajte limit pamäte kontajnera s jeho skutočnými potrebami pri spustení. Malý príklad:
Ak sa objaví Reason: OOMKilled a aplikácia legitímne vyžaduje viac ako nakonfigurovaný limit, opatrne zvýšte limit alebo znížte využitie pamäte aplikáciou. Ak Minikube sám trpí nedostatkom pamäte, zvýšenie iba limitu kontajnera môže jednoducho presunúť problém na nód.
Aktuálna dokumentácia Minikube uvádza, že štandardná lokálna inštalácia očakáva aspoň 2 CPU, 2 GB voľnej pamäte a 20 GB voľného diskového priestoru. Minikube tiež podporuje zmenu nakonfigurovanej pamäte klastra, čo si vyžaduje reštart. Pozri aktuálne požiadavky na spustenie Minikube.
Zmeňte prístup, keď: viacero nesúvisiacich Podov zlyháva alebo je eviktoovaných, alebo je Minikube sám nezdravý. To ukazuje mimo limitu pamäte jedného Deploymentu.
Fáza 4: Overte stabilitu a rozhodnite, či je problém na úrovni klastra
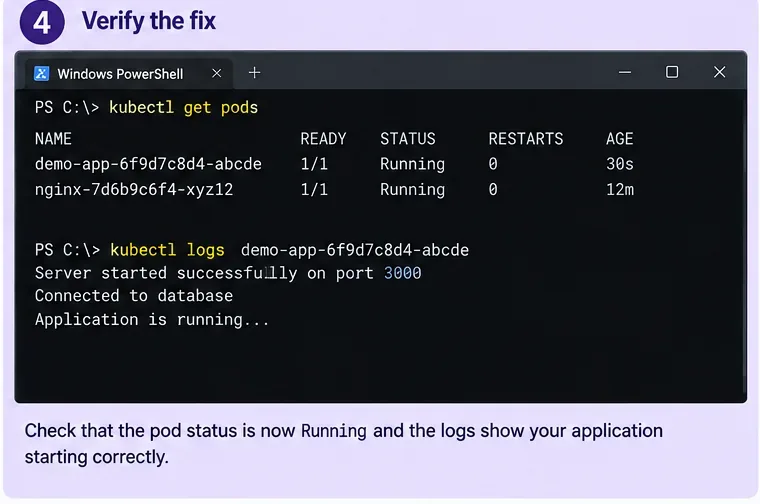
AI-generovaný príklad overenia. Skutočná oprava by mala byť potvrdená z vášho vlastného stavu Podu, počtu reštartov, sond, logov a správania aplikácie.
Po aplikácii opravy sledujte záťaž, nie ju kontrolujte len raz:
kubectl get pods -n <namespace> -w
Pre Deployment:
kubectl rollout status deployment/<name> -n <namespace>
Potom prečítajte nové logy:
kubectl logs <new-pod-name> -n <namespace>
Silným signálom úspechu nie je jednoducho STATUS=Running. Potvrďte všetky nasledujúce body, ak sú aplikovateľné:
READY dosiahne očakávanú hodnotu, napríklad 1/1.
Počet reštartov zostáva nezmenený, zatiaľ čo pozorujete normálne spustenie a prevádzku.
Nepojavujú sa žiadne nové udalosti BackOff, zlyhania sondy alebo OOM.
Logy aplikácie ukazujú úspešnú inicializáciu.
Služba alebo lokálna cesta prístupu skutočne dosiahne aplikáciu.
Ak aplikácia stále zlyháva, skontrolujte, či je Minikube sám zdravý
Spustite:
minikube status
kubectl get pods -A
Príkaz status v Minikube hlási stav lokálneho klastra, vrátane hostiteľa, kubeletu, API servera a stavu kubeconfig. Pozri oficiálnu referenciu minikube status.
Ak je riadiaca rovina alebo jadro systémových Podov nezdravé, zozbierajte diagnostiku klastra:
minikube logs --problems
minikube logs
Dokumentácia Minikube je explicitná v tom, že minikube logs slúži na ladenie lokálneho klastra Kubernetes, nie kódu vašej používateľskej aplikácie. Používajte kubectl logs pre kontajner aplikácie a minikube logs, keď je podozrivý samotný klaster alebo nód. Pozri aktuálnu referenciu minikube logs a usmernenie na riešenie problémov s Minikube.
Zmeňte prístup, keď: jadro komponentov Kubernetes zlyháva, API server je nedostupný, stav Minikube je nezdravý alebo mnoho nesúvisiacich záťaží zlyháva naraz. V takom bode je nepravdepodobné, že ďalšie úpravy jedného Deploymentu vyriešia základný problém.
Mali by ste vymazať a znova vytvoriť klaster Minikube?
Až po tom, čo ste oddelili problém aplikácie od problému klastra. Znovuvytvorenie lokálneho vývojového klastra môže byť rozumné, keď je klaster jednorazový, vaše manifesty sú reprodukovateľné a Minikube je sám poškodený alebo nesprávne nakonfigurovaný. Je to zlý prvý krok pri aplikácii, ktorá sa ukončí s jasným stack trace.
Príkazy ako minikube delete odstránia lokálny klaster. To môže tiež odstrániť lokálny stav Kubernetes a dáta, ktoré ste očakávali, že si ponecháte. Nepoužívajte mazanie ako diagnostickú skratku, keď trvalý zväzok, lokálna databáza alebo ručne vytvorený zdroj obsahuje jedinú kópiu niečoho dôležitého.
Prah kvality pre prechod na znovuvytvorenie klastra: potvrdili ste, že zlyhanie nie je vysvetlené príkazom záťaže, konfiguráciou, závislosťou, sondami alebo limitmi zdrojov; zdravie Minikube je abnormálne; a lokálny stav je buď zálohovaný, alebo bezpečne reprodukovateľný.
Kompaktný rozhodovací strom
Zistenie
Ďalšia akcia
Čo ešte nerobiť
Stack trace aplikácie v logoch --previous
Opravte aplikáciu/konfiguráciu naznačenú chybou
Vymazať klaster Minikube
Reason: OOMKilled
Skontrolujte limity kontajnera a pamäť nódu/Minikube
Predpokladať, že všetky prípady exit 137 sú identické
Opakované zlyhania sond liveness/startup
Opravte endpoint, port, načasovanie alebo dizajn startup sondy
Trvalo vypnúť každú kontrolu zdravia
Readiness sonda zlyháva, ale kontajner beží
Opravte readiness alebo dostupnosť závislosti
Diagnostikovať to ako príčinu reštartu bez iných dôkazov
ConfigMap/Secret sa zmenil, ale stará hodnota env zostáva
Nahraďte/reštartujte Pod po overení novej konfigurácie
Očakávať, že sa premenné prostredia procesu hot-reloadnú
Stav Minikube/jadro Podov je nezdravé
Použite diagnostiku Minikube a skontrolujte zdroje klastra
Ďalej donekonečna upravovať jeden Deployment aplikácie
Čo tento postup nemôže zaručiť
Lokálny CrashLoopBackOff môže odhaliť chybu aplikácie, zlyhanie závislosti, chybu sondy, limit zdrojov, nezhodu architektúry, chýbajúci súbor, problém s oprávneniami alebo mnoho iných zlyhaní pri spustení. Žiadna pevná sekvencia príkazov nemôže identifikovať každú príčinu bez čítania skutočného dôvodu ukončenia, Events a logov.
Tiež oprava, ktorá funguje v Minikube, automaticky nedokazuje pripravenosť na produkciu. Produkčné klaster môžu používať iné triedy úložiska, bezpečnostné politiky, ingress controllery, architektúry nódu, sieťové politiky, kvóty zdrojov, systémy tajných kľúčov alebo externé služby. Minikube je cenný na reprodukciu a pochopenie zlyhania na úrovni kontajnera, ale správanie špecifické pre prostredie musí byť stále testované tam, kde bude aplikácia skutočne bežať.
Finálny kontrolný zoznam
Identifikujte presný zlyhávajúci kontajner a namespace.
Prečítajte Last State, dôvod ukončenia, exit code, počet reštartov a Events.
Použite kubectl logs --previous pre kontajnery, ktoré sa rýchlo reštartujú.
Premena dôkazy na jednu špecifickú hypotézu o príčine.
Opravte konfiguráciu, adresovanie závislostí, sondy alebo zdroje na základe týchto dôkazov.
Reštartujte alebo nasadíte nové Pod, keď sa zmenia hodnoty ConfigMap alebo Secret založené na prostredí.
Overte stav Ready a potvrďte, že počet reštartov prestane rásť.
Používajte minikube status a minikube logs len vtedy, keď je podozrivé aj zdravie klastra.
Znovuvytvorte Minikube len vtedy, keď je samotný klaster pravdepodobným problémom a jednorazový stav je chránený.
Najspoľahlivejší spôsob, ako opraviť CrashLoopBackOff, je považovať ho za signál na vyšetrovanie, nie za diagnózu. V zdravom procese riešenia problémov každý príkaz zúži príčinu: stav Podu vám povie, čo sa reštartuje, predchádzajúce logy vám povedia, prečo posledný beh zlyhal, manifest a Events ukazujú, čo Kubernetes požadoval od kontajnera, a diagnostika Minikube vám povie, či je zapojený samotný lokálny klaster. Keď sa tieto vrstvy zhodnú, oprava je zvyčajne oveľa menšia – a oveľa ľahšie overiteľná – než vymazanie a znovuvytvorenie všetkého.