Kezdőlap
» Alap tudás
»
Hogyan javítsd meg a Kubernetes CrashLoopBackOff hibát helyi Minikube környezetben
Hogyan javítsd meg a Kubernetes CrashLoopBackOff hibát helyi Minikube környezetben
A cél nem csupán az, hogy a CrashLoopBackOff hiba néhány másodpercre eltűnjön. Egy jó javítás azt eredményezi, hogy a konténer fut, a Pod Ready (kész) állapotban van, amikor forgalmat kellene fogadnia, a újraindítási számláló nem növekszik tovább, és a naplók normál alkalmazásindítást mutatnak. Helyi Minikube környezetben azt is ellenőrizned kell, hogy maga a Minikube klaszter egészséges-e, mielőtt újraépítenéd.
A Kubernetes aktuális dokumentációja a CrashLoopBackOff hibát úgy írja le, mint egy backoff (visszalépési) állapot, amely akkor jelenik meg, amikor egy konténer ismételten elindul, elbukik, és újraindul. A Kubernetes fokozatosan késlelteti a további újraindításokat, hogy elkerülje a szoros hibakört. Ez a címke tehát az ismétlődő konténerhibák tünete, nem pedig önmagában a gyökérok. Lásd: Kubernetes Pod életciklus dokumentáció.
Ez az útmutató négy diagnosztikai fázist használ. Kövesd őket sorrendben, és állj meg, amikor azonosítottad és kijavítottad a tényleges okot. A Minikube helyi tanulási és fejlesztési célokra készült, így az alkalmazásszintű diagnosztika ugyanúgy alkalmazható más Kubernetes klasztereken is, míg a Minikube-specifikus helyreállítási lépések nem feltétlenül vonatkoznak a produkciós környezetre. Lásd: az aktuális Minikube indítási dokumentáció.
Milyen egy sikeres javítás?
Használj megfigyelhető jeleket, ne csak egyetlen zöld státuszsort:
A érintett konténer elég hosszú ideig futó állapotban marad ahhoz, hogy befejezze a normál indítást.
A Pod Ready (kész) állapotba kerül, ha azt várjuk tőle, hogy forgalmat szolgáljon ki.
A újraindítási számláló nem növekszik a megfigyelési időszak alatt.
A kubectl logs parancs normál indítási folyamatot mutat, nem pedig ugyanazt a végzetes hibát ismétlődően.
A liveness (életképesség) és startup (indítás) probe-ok, ha vannak konfigurálva, nem buknak el többé.
Az alkalmazás eléri azokat a szolgáltatásokat vagy függőségeket, amelyekre valóban szüksége van.
A minikube status parancs egészséges helyi klasztert mutat, ha a klaszter egészsége volt kérdéses.
Ne várd el, hogy egy meglévő Pod újraindítási számlálója nullára álljon vissza. A Kubernetes rögzíti, hányszor indult újra a konténer abban a Podban; egy sikeres javítás után maradhat nem nulla történelmi számláló. A lényeg az, hogy a számláló növekedése megálljon. Ha egy Deployment rollout új Podot hoz létre, az az új Pod általában saját, friss újraindítási számlálóval indul.
1. fázis: Bizonyítsd be, melyik konténer omlik össze
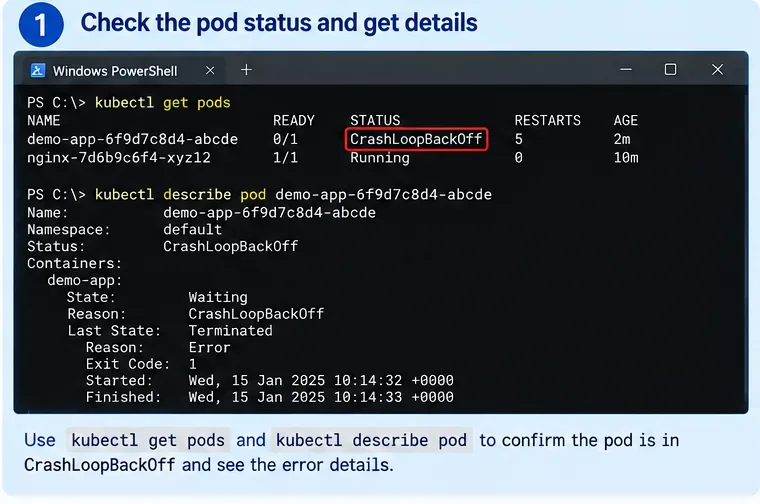
AI-generált illusztráció egy Kubernetes hibaelhárítási terminálról. A nevek, dátumok és kimenetek példák, nem valós Minikube klaszter képernyőképei.
Kezdd a Pod listával:
kubectl get pods -A
Ha már ismered a névteret, szűkítsd a parancsot:
kubectl get pods -n my-namespace
Ezután írd le az érintett Podot:
kubectl describe pod <pod-name> -n <namespace>
Vizsgáld meg a konténer szekció négy mezőjét:
State (Állapot) — a konténer jelenleg Waiting (várakozó) állapotban lehet CrashLoopBackOff okkal.
Last State (Utolsó állapot) — gyakran Terminated (leállt), ami megmutatja, mi történt az előző futás során.
Reason and Exit Code (Ok és kilépési kód) — hasznos nyomok, mint például Error vagy OOMKilled.
Restart Count (Újraindítási számláló) és Events (Események) — bizonyíték arra, hogy a hiba ismétlődik, és hogy a probe-ok vagy a kubelet műveletek érintettek-e.
Egy finom, de hasznos különbség: a Pod általános phase (fázisa) még mindig lehet Running (futó), miközben az egyik konténere CrashLoopBackOff állapotban várakozik. A kubectl get pods által kiírt STATUS oszlop egy kényelmes, ember által olvasható összefoglaló, nem pedig a Pod életciklus-állapotának teljes diagnózisa.
Minőségellenőrzés: ezen fázis végére tudnod kell a pontos Podot, névteret és azt a konténert, amely újraindul. Ha a Podnak több konténere van, azonosítsd, melyik bukik el, mielőtt elkezdenéd olvasni a naplókat.
Ha a hiba valójában nem CrashLoopBackOff
Ne próbáld meg minden indítási problémát ebbe az útmutatóba kényszeríteni. Az ImagePullBackOff, ErrImagePull, Pending és ContainerCreating állapotok eltérő hibaállapotokra utalnak. Például egy image-letöltési probléma az alkalmazásfolyamat elindulása előtt történik, így az alkalmazásnaplók még nem létezhetnek.
Válts megközelítést, amikor: az Events (Események) szekció image-letöltésre, kötetcsatolásra, ütemezésre vagy belépési (admission) hibákra utal, nem pedig egy olyan konténerre, amely elindul és kilép.
2. fázis: Olvasd el a hibás konténer aktuális és előző naplóit
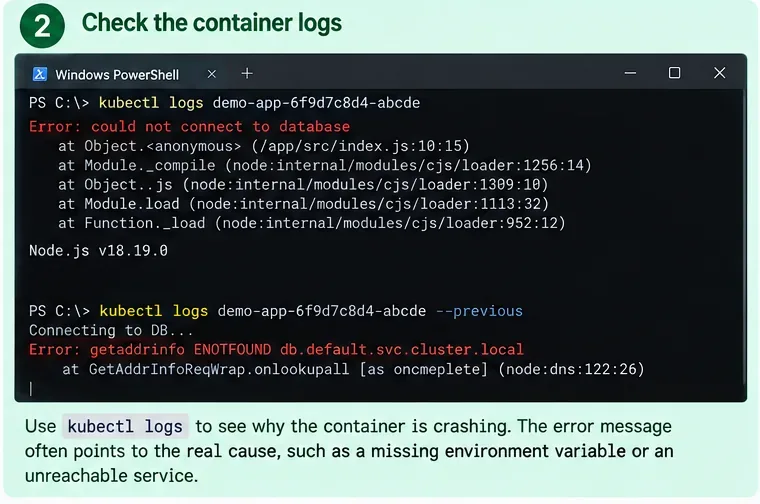
AI-generált illusztráció az aktuális és előző konténer naplókról. A hibaüzenetek példák a diagnosztikai munkafolyamat bemutatására.
Egyetlen konténerrel rendelkező Pod esetén kezdj ezzel:
kubectl logs <pod-name> -n <namespace>
Amikor a konténer gyorsan újraindul, a leghasznosabb parancs gyakran ez:
kubectl logs <pod-name> -n <namespace> --previous
A Kubernetes dokumentációja a --previous kapcsolót úgy írja le, mint azt az opciót, amely a Podban lévő konténer előző példányának naplóit nyomtatja ki. Ha a Pod több mint egy konténert tartalmaz, add meg a hibásat:
Osztályozd az első jelentős végzetes hibát, ahelyett, hogy a végső „process exited” (folyamat kilépett) sorra fókuszálnál. Tipikus minták közé tartoznak:
Bizonyíték
Valószínű irány
Mit tesztelj következőként
Stack trace és 1-es kilépési kód
Alkalmazás vagy indítási konfigurációs hiba
Ellenőrizd a parancsot, argumentumokat, környezetet, fájlokat és függőség-címeket
Reason: OOMKilled
A konténer túllépte a memóriakorlátját, vagy memórianyomás miatt ölték meg
Vizsgáld meg a korlátokat, az alkalmazás memóriahasználatát és a Minikube/csomópont kapacitást
Liveness vagy startup probe hibák az Events szekcióban
Az egészségügyi ellenőrzés elbukik az indítás előtt vagy után
Teszteld a probe útvonalát, portját, időzítését és az indítási időtartamot
DNS vagy kapcsolati hiba egy másik szolgáltatáshoz
Hibás szolgáltatásnév, névtér, port vagy függőség készenléti állapota
Vizsgáld meg a Service objektumokat és a klaszteren belüli DNS-t
Hiányzó fájl, kulcs vagy környezeti változó
ConfigMap, Secret, csatolás vagy manifest eltérés
Hasonlítsd össze a Deploymentot a hivatkozott objektumokkal
Minőségellenőrzés: képesnek kell lenned egy cáfolható hipotézis megfogalmazására, például „az alkalmazás azért lép ki, mert a DATABASE_HOST egy nem létező Service-re mutat”, nem pedig pusztán „a Kubernetes hibás”.
Ne kezeld a 137-es kilépési kódot önmagában OOM bizonyítékaként
A 137-es kilépési kód gyakran jelenik meg, amikor egy folyamat SIGKILL jelet kap, de az erősebb, Kubernetes-specifikus jelzés a Last State: Terminated a Reason: OOMKilled okkal. A Kubernetes erőforrás-kezelési dokumentációja ezt a kombinációt mutatja, amikor egy konténer túllépi a memóriakorlátját. Lásd: Kubernetes erőforrás-kezelési dokumentáció.
Hasznos lépés: alapozd a diagnózist a leállítási okra és a környező Events (Események) szekcióra, ne pusztán a 137-es számra.
3. fázis: Javítsd meg a gyökérokot, ne a backoff időzítőt
AI-generált YAML illusztráció egy példa konfigurációs javítást mutatva. A mezőértékek szemléltető jellegűek, és az aktuális munkaterheléshez kell igazítani őket.
Amikor tudod, miért lép ki a konténer, változtasd meg a legkisebb dolgot, amely kezeli ezt az okot. A Pod ismételt újraindítása nem javítja meg a hibás parancsot, a hiányzó konfigurációt, a hibás egészségügyi ellenőrzést vagy a nem elegendő memóriát.
A eset: Az alkalmazás localhost-on próbál elérni egy másik szolgáltatást
Egy normál Kubernetes Podban a Podban lévő konténerek megosztják a hálózati névteret, és kommunikálhatnak egymással localhost keresztül. Egy másik Podban futó adatbázist nem lehet elérni az alkalmazásod localhost-ján keresztül. A Kubernetes DNS neveket hoz létre a Services (Szolgáltatások) számára, hogy a munkaterhelések szolgáltatásnév alapján fedezhessék fel őket. Lásd: Kubernetes hálózati fogalmak és DNS a Services és Pods számára.
Ha a Service-ed neve postgres ugyanabban a névtérben, az alkalmazásod használhatja ezt:
DATABASE_HOST=postgres
Névterek között használj névtérrel minősített nevet, mint például postgres.data, vagy a klaszter domainjéhez illő teljesen minősített szolgáltatásnevet.
Ellenőrizd a Service-t az alkalmazás szerkesztése előtt:
kubectl get svc -A
kubectl get endpointslices -n <namespace>
Válts megközelítést, amikor: a Service létezik, de nincsenek használható backend végpontjai. Ebben az esetben a kliens hostname javítása nem elég; diagnosztizáld a szerver Deploymentot vagy a Service selectorát.
B eset: ConfigMap vagy Secret értékek hibásak
Vizsgáld meg a hivatkozásokat a munkaterhelés manifestjában:
kubectl get deployment <name> -n <namespace> -o yaml
kubectl get configmap -n <namespace>
kubectl get secret -n <namespace>
A Kubernetes támogatja a környezeti változókat env, ConfigMaps és Secrets forrásokból. Egy hasznos részlet, hogy a környezeti változókként fogyasztott ConfigMap értékek nem frissülnek egy már futó folyamatban, amikor a ConfigMap megváltozik; a Podot le kell cserélni. Ugyanez vonatkozik a környezeti változókként fogyasztott Secret értékekre. Lásd: Kubernetes ConfigMap dokumentáció és Kubernetes Secret injektálási dokumentáció.
Egy Deployment esetén a konfiguráció javítása után a rollout restart az egyik módja az új Podok létrehozásának:
Minőségellenőrzés: ellenőrizd, hogy az új Pod valóban a szándékolt értéket használja. Ne feltételezd, hogy egy ConfigMap szerkesztése azonnal megváltoztatja egy meglévő konténeren belüli környezeti változót.
C eset: Egy liveness vagy startup probe öli meg a lassú alkalmazást
A Kubernetes három típusú probe-ot definiál eltérő célokkal:
Startup probe: Meghatározza, hogy az alkalmazás indítása befejeződött-e. Amíg aktív, a liveness és readiness probe-ok várnak.
Liveness probe: Meghatározza, mikor kell a Kubernetesnek újraindítania egy beragadt vagy egészségtelen konténert.
Readiness probe: Meghatározza, hogy egy Podnak kell-e forgalmat kapnia a Services (Szolgáltatások) keresztül.
Egy gyakori félreértés, hogy a hibás readiness probe újraindítást okoz. Nem teszi. A readiness hiba a Podot nem kész (unready) állapotba hozza; az ismétlődő liveness vagy startup probe hibák okozhatnak konténer újraindításokat. Lásd: Kubernetes probe fogalmak és a hivatalos probe konfigurációs útmutató.
Ha az alkalmazásnak jogosan hosszú indításra van szüksége, fontolj meg egy startup probe-ot elegendő failureThreshold × periodSeconds idővel a reális indítás lefedésére. Ne egyszerűen tiltsd le az összes probe-ot, hogy a státusz zöldnek tűnjön; ez eltávolítja a hasznos egészségvédelmet.
Minőségellenőrzés: a probe-nak olyan feltételt kell tesztelnie, amely tükrözi a célját, és az alkalmazásnak túl kell élnie a normál indítást anélkül, hogy idő előtt megölnék.
D eset: A konténer OOMKilled (Out Of Memory) állapotban van
Először hasonlítsd össze a konténer memóriakorlátját a tényleges indítási igényeivel. Egy kis példa:
Ha megjelenik a Reason: OOMKilled, és az alkalmazás jogosan igényel többet, mint a konfigurált korlát, óvatosan emeld a korlátot, vagy csökkentsd az alkalmazás memóriahasználatát. Ha maga a Minikube éhezik a memóriára, csak a konténer korlátjának növelése egyszerűen átmozgathatja a problémát a csomópontra.
Az aktuális Minikube dokumentáció szerint a szabványos helyi beállítás legalább 2 CPU-t, 2 GB szabad memóriát és 20 GB szabad lemezterületet vár el. A Minikube támogatja a konfigurált klasztermemória megváltoztatását is, ami újraindítást igényel. Lásd: A Minikube aktuális indítási követelményei.
Válts megközelítést, amikor: több, egymástól független Pod bukik el vagy kerül kiutasításra, vagy maga a Minikube egészségtelen. Ez egy Deployment memóriakorlátján túlmutató problémára utal.
4. fázis: Ellenőrizd a stabilitást és döntsd el, hogy a probléma klaszterszintű-e
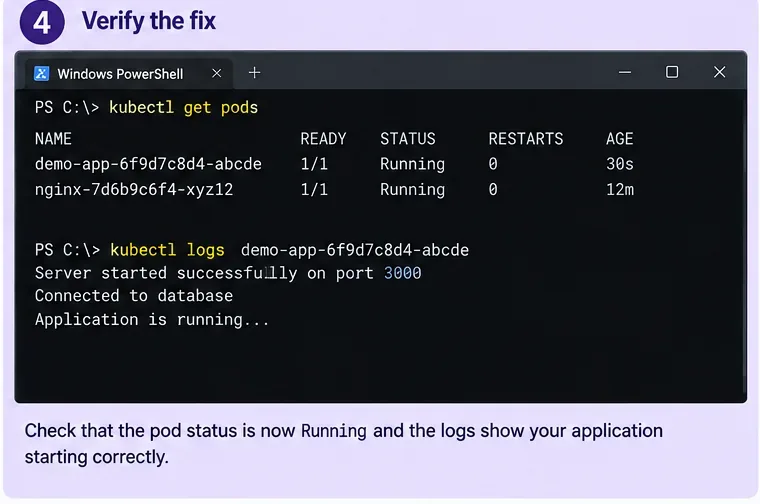
AI-generált ellenőrzési példa. Egy valós javítást a saját Pod állapotából, újraindítási számlálóból, probe-okból, naplókból és alkalmazásviselkedésből kell megerősíteni.
A javítás alkalmazása után figyeld a munkaterhelést, ne csak egyszer ellenőrizd:
kubectl get pods -n <namespace> -w
Egy Deployment esetén:
kubectl rollout status deployment/<name> -n <namespace>
Ezután olvasd el az új naplókat:
kubectl logs <new-pod-name> -n <namespace>
Egy erős sikerjel nem egyszerűen a STATUS=Running. Erősítsd meg az alábbiakat, ahol alkalmazhatók:
A READY eléri a várt értéket, például 1/1.
Az újraindítási számláló változatlan marad, miközben a normál indítást és forgalmat figyeled.
Nem jelennek meg új BackOff, probe-hiba vagy OOM események.
Az alkalmazásnaplók sikeres inicializálást mutatnak.
A Service vagy a helyi hozzáférési útvonal valóban eléri az alkalmazást.
Ha az alkalmazás továbbra is elbukik, ellenőrizd, hogy maga a Minikube egészséges-e
Futtasd:
minikube status
kubectl get pods -A
A Minikube status parancsa a helyi klaszter állapotát jelenti, beleértve a host, kubelet, API szerver és kubeconfig állapotát. Lásd: a hivatalos minikube status referencia.
Ha a vezérlősík vagy a magrendszer Podok egészségtelenek, gyűjts klaszterdiagnosztikai adatokat:
minikube logs --problems
minikube logs
A Minikube dokumentációja egyértelműen kimondja, hogy a minikube logs a helyi Kubernetes klaszter hibaelhárítására szolgál, nem a felhasználói alkalmazáskódra. Használd a kubectl logs-t az alkalmazáskonténerhez, és a minikube logs-t, amikor a klaszter vagy a csomópont maga gyanús. Lásd: az aktuális minikube logs referencia és Minikube hibaelhárítási útmutató.
Válts megközelítést, amikor: a mag Kubernetes komponensek elbuknak, az API szerver nem elérhető, a Minikube státusza egészségtelen, vagy sok, egymástól független munkaterhelés bukik el egyszerre. Ezen a ponton egy Deployment szerkesztésének folytatása valószínűleg nem oldja meg az alapvető problémát.
Töröld és hozd létre újra a Minikube klasztert?
Csak azután, hogy elkülönítetted az alkalmazásproblémát a klaszterproblémától. Egy helyi fejlesztési klaszter újraépítése indokolt lehet, ha a klaszter eldobható, a manifestjeid reprodukálhatók, és maga a Minikube sérült vagy hibásan konfigurált. Ez rossz első válasz egy olyan alkalmazás esetén, amely egyértelmű stack trace-dal lép ki.
Olyan parancsok, mint a minikube delete, eltávolítják a helyi klasztert. Ez eltávolíthatja a helyi Kubernetes állapotot és azokat az adatokat is, amelyeket meg akartál őrizni. Ne használd a törlést diagnosztikai gyorsítópálya-ként, amikor egy tartós kötet, helyi adatbázis vagy kézzel létrehozott erőforrás tartalmazza valami fontos dolog egyetlen másolatát.
Minőségi küszöb a klaszter újraépítésére váltáshoz: megerősítetted, hogy a hibát nem a munkaterhelés parancsa, konfigurációja, függőségei, probe-jai vagy erőforráskorlátjai magyarázzák; a Minikube egészsége rendellenes; és a helyi állapot vagy biztonsági mentéssel rendelkezik, vagy biztonságosan reprodukálható.
Egy tömör döntési fa
Találat
Következő lépés
Mit ne tegyél még
Alkalmazás stack trace a --previous naplókban
Javítsd meg az alkalmazást/konfigurációt, amelyre a hiba utal
Töröld a Minikube klasztert
Reason: OOMKilled
Ellenőrizd a konténer korlátokat és a csomópont/Minikube memóriát
Feltételezni, hogy minden 137-es kilépési eset azonos
Ismétlődő liveness/startup probe hibák
Javítsd meg a végpontot, portot, időzítést vagy a startup probe tervezését
Tiltson le minden egészségügyi ellenőrzést véglegesen
Readiness probe elbukik, de a konténer fut
Javítsd meg a readiness vagy a függőség elérhetőségét
Diagnosztizáld újraindítási okként más bizonyíték nélkül
ConfigMap/Secret megváltozott, de a régi env érték megmaradt
Cseréld/indítsd újra a Podot az új konfiguráció validálása után
Várni, hogy a folyamat környezeti változói hot-reloadoljanak
Minikube státusz/mag Podok egészségtelenek
Használd a Minikube diagnosztikát és vizsgáld meg a klaszter erőforrásait
Folytasd egy alkalmazás Deployment végtelen szerkesztését
Mit ez a munkafolyamat nem tud garantálni
Egy helyi CrashLoopBackOff feltárhat egy alkalmazáshibát, függőségi hibát, probe hibát, erőforráskorlátot, architektúra eltérést, hiányzó fájlt, jogosultsági problémát vagy sok más indítási hibát. Nincs olyan rögzített parancssorozat, amely minden okot azonosítani tudna anélkül, hogy elolvasnád a tényleges leállítási okot, az Events (Események) szekciót és a naplókat.
Továbbá egy Minikube-ben működő javítás nem bizonyítja automatikusan a produkciós készenlétet. A produkciós klaszterek eltérő tárolóosztályokat, biztonsági szabályzatokat, ingress vezérlőket, csomópont architektúrákat, hálózati szabályzatokat, erőforrás kvótákat, titokrendszereket vagy külső szolgáltatásokat használhatnak. A Minikube értékes a konténerszintű hiba reprodukálásában és megértésében, de a környezetspecifikus viselkedést még mindig ott kell tesztelni, ahol az alkalmazás valóban futni fog.
Végső ellenőrzőlista
Azonosítsd a pontos hibás konténert és névteret.
Olvasd el a Last State (Utolsó állapot), leállítási ok, kilépési kód, újraindítási számláló és Events (Események) szekciót.
Használd a kubectl logs --previous parancsot gyorsan újrainduló konténerekhez.
Alakítsd a bizonyítékokat egy specifikus gyökérok-hipotézissé.
Javítsd a konfigurációt, függőség-címzést, probe-okat vagy erőforrásokat ezen bizonyítékok alapján.
Indítsd újra vagy roll out új Podokat, amikor környezetalapú ConfigMap vagy Secret értékek változnak.
Ellenőrizd a Ready (kész) állapotot, és erősítsd meg, hogy az újraindítási számláló növekedése megáll.
Használd a minikube status és minikube logs parancsokat csak akkor, ha a klaszter egészsége is gyanús.
Csak akkor hozd létre újra a Minikube-ot, ha maga a klaszter a valószínű probléma, és az eldobható állapot védett.
A CrashLoopBackOff legmegbízhatóbb javítási módja, ha kivizsgálásra utaló jelként kezeled, nem pedig diagnózisként. Egy egészséges hibaelhárítási folyamatban minden parancs szűkíti az okot: a Pod állata megmutatja, mi újraindul, az előző naplók megmutatják, miért bukott el az utolsó futás, a manifest és az Events (Események) megmutatják, mit kért a Kubernetes a konténertől, a Minikube diagnosztika pedig megmutatja, hogy a helyi klaszter maga érintett-e. Amikor ezek a rétegek egyetértenek, a javítás általában sokkal kisebb – és sokkal könnyebben ellenőrizhető –, mint minden törlése és újraépítése.