Početna
» Osnovno znanje
»
Kako popraviti Kubernetes CrashLoopBackOff u lokalnom Minikube okruženju
Kako popraviti Kubernetes CrashLoopBackOff u lokalnom Minikube okruženju
Cilj nije samo da CrashLoopBackOff nestane na nekoliko sekundi. Dobra popravka ostavlja kontejner u stanju pokretanja, održava Pod u stanju Ready kada bi trebao primati promet, zaustavlja rast broja ponovnih pokretanja i generira logove koji pokazuju normalno pokretanje aplikacije. U lokalnom Minikube okruženju, također biste trebali potvrditi da je sam Minikube klaster zdrav prije nego što ga ponovno izgradite.
Trenutna Kubernetes dokumentacija opisuje CrashLoopBackOff kao uvjet odgode koji se pojavljuje kada se kontejner ponovno pokreće, ne uspijeva i ponovno se pokreće. Kubernetes progresivno odgađa dodatna ponovna pokretanja kako bi izbjegao usku petlju neuspjeha. Oznaka je stoga simptom ponovljenog neuspjeha kontejnera, a ne sam uzrok. Pogledajte Kubernetes dokumentaciju o životnom ciklusu Podova.
Ovaj vodič koristi četiri dijagnostičke faze. Slijedite ih redom i zaustavite se kada identificirate i ispravite stvarni uzrok. Minikube je namijenjen lokalnom učenju i razvoju, pa se ista dijagnostika na razini aplikacije prenosi na druge Kubernetes klastere, dok se Minikube-specifični koraci oporavka ne primjenjuju nužno na produkciju. Pogledajte trenutnu Minikube dokumentaciju za pokretanje.
Kako izgleda uspješna popravka?
Koristite opažljive znakove umjesto jedne zelene statusne linije:
Pogođeni kontejner ostaje u stanju pokretanja dovoljno dugo da dovrši normalno pokretanje.
Pod postaje Ready ako se očekuje da će posluživati promet.
Broj ponovnih pokretanja prestaje rasti tijekom vašeg razdoblja promatranja.
kubectl logs pokazuje normalan put pokretanja, a ne ponavljanje iste fatalne greške.
Sonde za živost (liveness) i pokretanje (startup), ako su konfigurirane, prestaju neuspješno prolaziti.
Aplikacija može doseći usluge ili ovisnosti koje stvarno treba.
minikube status pokazuje zdrav lokalni klaster kada je zdravlje klastera bilo upitno.
Ne zahtijevajte da brojač ponovnih pokretanja postojećeg Poda padne na nulu. Kubernetes bilježi koliko je puta kontejner ponovno pokrenut u tom Podu; uspješna popravka može ostaviti nepovijesni broj koji nije nula. Važno je da broj prestane rasti. Ako rollout Deploymenta stvori novi Pod, taj novi Pod obično počinje s vlastitim svježim brojačem ponovnih pokretanja.
Faza 1: Dokažite koji kontejner se ruši
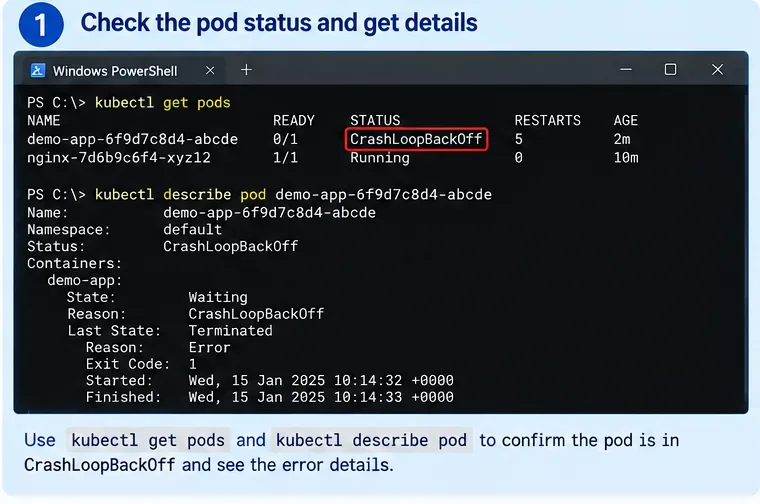
AI generirana ilustracija terminala za rješavanje problema s Kubernetesom. Imena, datumi i izlaz su primjeri, a ne snimka zaslona s pravog Minikube klastera.
Počnite s popisom Podova:
kubectl get pods -A
Ako već znate namespace, suzite naredbu:
kubectl get pods -n my-namespace
Zatim opišite pogođeni Pod:
kubectl describe pod <pod-name> -n <namespace>
Pogledajte četiri polja u sekciji kontejnera:
State — kontejner trenutno može biti u stanju Waiting s razlogom CrashLoopBackOff.
Last State — često Terminated, što vam govori što se dogodilo u prethodnom pokretanju.
Reason and Exit Code — korisne naznake poput Error ili OOMKilled.
Restart Count i Events — dokazi da se neuspjeh ponavlja i jesu li uključene sonde ili kubelet radnje.
Suptilna, ali korisna razlika: ukupna faza Poda i dalje može biti Running dok jedan od njegovih kontejnera čeka u stanju CrashLoopBackOff. Stupac STATUS koji ispisuje kubectl get pods je prikladan sažetak čitljiv ljudima, a ne potpuna dijagnoza stanja životnog ciklusa Poda.
Provjera kvalitete: do kraja ove faze trebali biste znati točan Pod, namespace i kontejner koji se ponovno pokreće. Ako Pod ima više kontejnera, identificirajte koji ne uspijeva prije čitanja logova.
Ako neuspjeh zapravo nije CrashLoopBackOff
Nemojte prisiljavati svaki problem s pokretanjem u ovaj vodič. ImagePullBackOff, ErrImagePull, Pending i ContainerCreating ukazuju na različite faze neuspjeha. Na primjer, problem s povlačenjem slike događa se prije nego što proces vaše aplikacije započne, pa logovi aplikacije možda još ne postoje.
Promijenite pristup kada: sekcija Events ukazuje na povlačenje slike, montiranje volumena, raspoređivanje (scheduling) ili greške prihvata (admission errors), a ne na kontejner koji se pokreće i izlazi.
Faza 2: Pročitajte trenutne i prethodne logove neuspjelog kontejnera
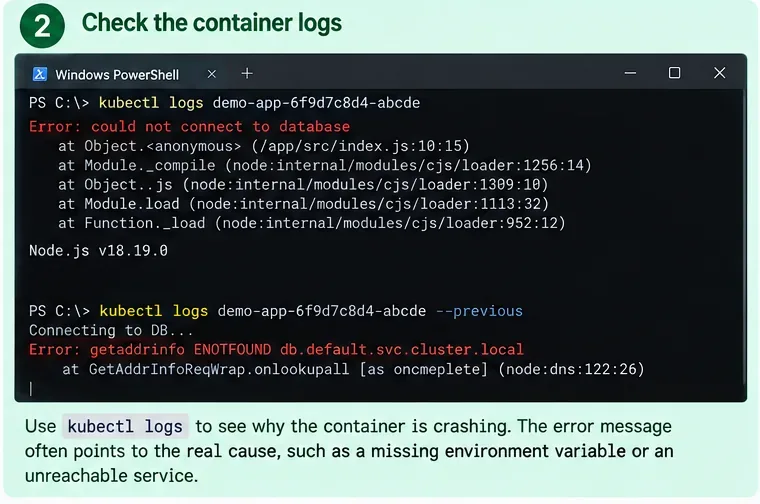
AI generirana ilustracija trenutnih i prethodnih logova kontejnera. Poruke o greškama su primjeri korišteni za demonstraciju dijagnostičkog tijeka rada.
Za Pod s jednim kontejnerom, počnite s:
kubectl logs <pod-name> -n <namespace>
Kada se kontejner brzo ponovno pokreće, najkorisnija naredba često je:
kubectl logs <pod-name> -n <namespace> --previous
Kubernetes dokumentira --previous kao opciju koja ispisuje logove iz prethodne instance kontejnera u Podu. Ako Pod sadrži više od jednog kontejnera, navedite onaj koji ne uspijeva:
Klasificirajte prvu značajnu fatalnu grešku umjesto da se fokusirate na završnu liniju “process exited”. Tipični obrasci uključuju:
Dokaz
Vjerojatan smjer
Što testirati sljedeće
Stack trace plus izlazni kod 1
Greška u aplikaciji ili konfiguraciji pokretanja
Provjerite naredbu, argumente, okruženje, datoteke i adrese ovisnosti
Reason: OOMKilled
Kontejner je prekoračio svoje ograničenje memorije ili je ubijen zbog pritiska na memoriju
Inspekcija ograničenja, korištenja memorije aplikacije i kapaciteta Minikube/čvora
Neuspjeh sonde za živost ili pokretanje u Events
Provjera zdravlja ne uspijeva prije ili nakon pokretanja
Testirajte putanju sonde, port, tajming i trajanje pokretanja
DNS ili greška povezivanja s drugom uslugom
Pogrešan naziv usluge, namespace, port ili spremnost ovisnosti
Inspekcija objekata Service i DNS-a unutar klastera
Nedostajuća datoteka, ključ ili varijabla okruženja
Nepodudarnost ConfigMap, Secret, mount ili manifest
Usporedite Deployment s referenciranim objektima
Provjera kvalitete: trebali biste moći navesti falsificiranu hipotezu poput “aplikacija izlazi jer DATABASE_HOST pokazuje na nepostojeću uslugu”, a ne samo “Kubernetes je pokvaren”.
Nemojte tretirati izlazni kod 137 sam kao dokaz OOM-a
Izlazni kod 137 često se pojavljuje kada proces primi SIGKILL, ali jači signal specifičan za Kubernetes je Last State: Terminated s Reason: OOMKilled. Dokumentacija Kubernetes upravljanja resursima pokazuje ovu kombinaciju kada kontejner prekorači svoje ograničenje memorije. Pogledajte Kubernetes dokumentaciju o upravljanju resursima.
Korisna radnja: temeljite dijagnozu na razlogu završetka i okolnim Eventima, a ne na samom broju 137.
Faza 3: Popravite uzrok, a ne timer odgode
AI generirana YAML ilustracija koja pokazuje primjer ispravka konfiguracije. Vrijednosti polja su ilustrativne i moraju se prilagoditi stvarnom workloadu.
Kada znate zašto kontejner izlazi, promijenite najmanju stvar koja rješava taj uzrok. Ponovno pokretanje Poda više puta ne popravlja lošu naredbu, nedostajuću konfiguraciju, neuspješnu provjeru zdravlja ili nedovoljnu memoriju.
Slučaj A: aplikacija pokušava doseći drugu uslugu na localhostu
Unutar normalnog Kubernetes Poda, kontejneri u tom istom Podu dijele mrežni namespace i mogu međusobno komunicirati putem localhost. Baza podataka koja radi u drugom Podu ne doseže se kroz localhost vaše aplikacije. Kubernetes stvara DNS nazive za Usluge kako bi workloadovi mogli otkrivati usluge po nazivu usluge. Pogledajte Kubernetes koncepte mrežnog povezivanja i DNS za Usluge i Podove.
Ako je vaša usluga nazvana postgres u istom namespaceu, vaša aplikacija možda može koristiti:
DATABASE_HOST=postgres
Kroz namespaceove, koristite kvalificirani naziv namespacea poput postgres.data ili potpuno kvalificirani naziv usluge prikladan za domenu vašeg klastera.
Provjerite uslugu prije uređivanja aplikacije:
kubectl get svc -A
kubectl get endpointslices -n <namespace>
Promijenite pristup kada: usluga postoji, ali nema upotrebljive backend krajnje točke. U tom slučaju, ispravljanje hostnamea klijenta nije dovoljno; dijagnosticirajte Deployment ili Service selektor poslužitelja.
Slučaj B: vrijednosti ConfigMap ili Secret su pogrešne
Inspekcija referenci u manifestu workloada:
kubectl get deployment <name> -n <namespace> -o yaml
kubectl get configmap -n <namespace>
kubectl get secret -n <namespace>
Kubernetes podržava varijable okruženja iz env, ConfigMaps i Secrets. Koristan detalj je da se vrijednosti ConfigMapa konzumirane kao varijable okruženja ne ažuriraju u već pokrenutom procesu kada se ConfigMap promijeni; Pod mora biti zamijenjen. Isto vrijedi za vrijednosti Secreta konzumirane kao varijable okruženja. Pogledajte Kubernetes ConfigMap dokumentaciju i Kubernetes dokumentaciju o ubrizgavanju Secreta.
Za Deployment, nakon ispravka konfiguracije, rollout restart je jedan način za stvaranje novih Podova:
Provjera kvalitete: provjerite koristi li novi Pod stvarno namjeravanu vrijednost. Nemojte pretpostavljati da uređivanje ConfigMapa trenutno mijenja varijablu okruženja unutar postojećeg kontejnera.
Slučaj C: sonda za živost ili pokretanje ubija sporu aplikaciju
Kubernetes definira tri vrste sondi s različitim svrhama:
Startup sonda: određuje je li pokretanje aplikacije završilo. Dok je aktivna, sonde za živost i spremnost čekaju.
Liveness sonda: određuje kada bi Kubernetes trebao ponovno pokrenuti zaglavljeni ili nezdravi kontejner.
Readiness sonda: određuje bi li Pod trebao primati promet kroz Usluge.
Uobičajeno nerazumijevanje je da neuspjeh readiness sonde uzrokuje ponovno pokretanje. Ne uzrokuje. Neuspjeh spremnosti čini Pod nespremnim; ponovljeni neuspjesi liveness ili startup sondi mogu uzrokovati ponovna pokretanja kontejnera. Pogledajte Kubernetes koncepte sondi i službeni vodič za konfiguraciju sondi.
Ako aplikacija legitimno treba dugo pokretanje, razmislite o startup sondi s dovoljno vremena failureThreshold × periodSeconds da pokrije realno pokretanje. Nemojte jednostavno onemogućiti sve sonde kako bi status izgledao zeleno; to uklanja korisnu zaštitu zdravlja.
Provjera kvalitete: sonda bi trebala testirati uvjet koji odražava svoju svrhu, a aplikacija bi trebala preživjeti normalno pokretanje bez prijevremenog ubijanja.
Slučaj D: kontejner je OOMKilled
Prvo usporedite ograničenje memorije kontejnera s njegovim stvarnim potrebama pri pokretanju. Mali primjer:
Ako se pojavi Reason: OOMKilled i aplikacija legitimno zahtijeva više od konfiguriranog ograničenja, pažljivo povisite ograničenje ili smanjite korištenje memorije aplikacije. Ako Minikube sam pati od nedostatka memorije, povećanje samo ograničenja kontejnera možda će samo premjestiti problem na čvor.
Trenutna Minikube dokumentacija kaže da standardna lokalna postavka očekuje najmanje 2 CPU-a, 2 GB slobodne memorije i 20 GB slobodnog prostora na disku. Minikube također podržava promjenu konfigurirane memorije klastera, što zahtijeva ponovno pokretanje. Pogledajte trenutne Minikube zahtjeve za pokretanje.
Promijenite pristup kada: nekoliko nepovezanih Podova ne uspijeva ili se izbacuje (evicted), ili je Minikube sam nezdrav. To ukazuje na problem izvan ograničenja memorije jednog Deploymenta.
Faza 4: Potvrdite stabilnost i odlučite je li problem na razini klastera
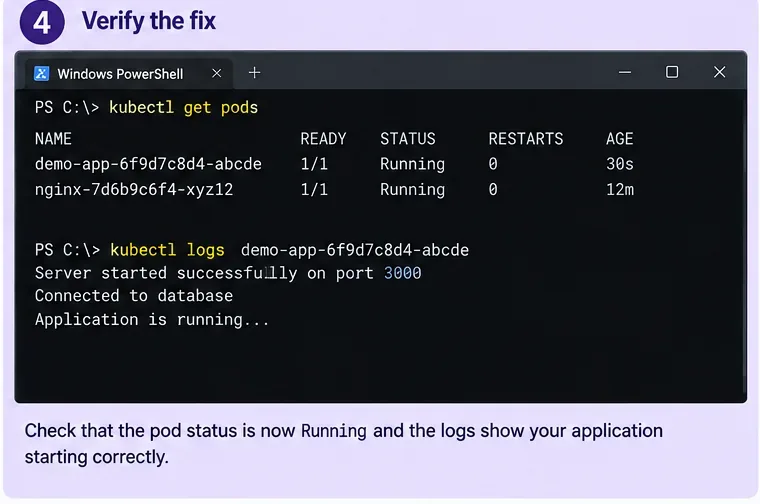
AI generirani primjer verifikacije. Stvarna popravka treba se potvrditi iz stanja vašeg Poda, broja ponovnih pokretanja, sondi, logova i ponašanja aplikacije.
Nakon primjene popravke, promatrajte workload umjesto da ga provjeravate jednom:
kubectl get pods -n <namespace> -w
Za Deployment:
kubectl rollout status deployment/<name> -n <namespace>
Zatim pročitajte nove logove:
kubectl logs <new-pod-name> -n <namespace>
Snažan signal uspjeha nije jednostavno STATUS=Running. Potvrdite sve sljedeće gdje je primjenjivo:
READY doseže očekivanu vrijednost, poput 1/1.
Broj ponovnih pokretanja ostaje nepromijenjen dok promatrate normalno pokretanje i promet.
Ne pojavljuju se novi BackOff, neuspjeh sonde ili OOM događaji.
Logovi aplikacije pokazuju uspješnu inicijalizaciju.
Usluga ili lokalni put pristupa stvarno doseže aplikaciju.
Ako aplikacija i dalje ne uspijeva, provjerite je li Minikube sam zdrav
Pokrenite:
minikube status
kubectl get pods -A
Minikube status naredba izvještava o stanju lokalnog klastera, uključujući host, kubelet, API server i status kubeconfiga. Pogledajte službenu minikube status referencu.
Ako su kontrolna ravnina ili osnovni sistemski Podovi nezdravi, prikupite dijagnostiku klastera:
minikube logs --problems
minikube logs
Minikube dokumentacija je eksplicitna da je minikube logs namijenjen otklanjanju grešaka lokalnog Kubernetes klastera, a ne koda vaše korisničke aplikacije. Koristite kubectl logs za kontejner aplikacije i minikube logs kada je klaster ili čvor sam pod sumnjom. Pogledajte trenutnu minikube logs referencu i Minikube smjernice za otklanjanje grešaka.
Promijenite pristup kada: osnovne Kubernetes komponente ne uspijevaju, API server je nedostupan, Minikube status je nezdrav ili mnogo nepovezanih workloadova ne uspijeva odjednom. U tom trenutku, nastavak uređivanja jednog Deploymenta vjerojatno neće riješiti temeljni problem.
Trebate li obrisati i ponovno stvoriti Minikube klaster?
Samо nakon što ste odvojili problem aplikacije od problema klastera. Ponovno stvaranje lokalnog razvojnog klastera može biti razumno kada je klaster jednokratan, vaši manifesti su reproducibilni, a Minikube je sam oštećen ili pogrešno konfiguriran. To je loš prvi odgovor na aplikaciju koja izlazi s jasnim stack traceom.
Naredbe poput minikube delete uklanjaju lokalni klaster. To također može ukloniti lokalno Kubernetes stanje i podatke za koje ste očekivali da će ostati. Nemojte koristiti brisanje kao dijagnostički prečac kada trajni volumen, lokalna baza podataka ili ručno stvoreni resurs sadrže jedinu kopiju nečega važnog.
Prag kvalitete za prelazak na ponovno stvaranje klastera: potvrdili ste da neuspjeh nije objašnjen naredbom workloada, konfiguracijom, ovisnošću, sondama ili ograničenjima resursa; Minikube zdravlje je abnormalno; i lokalno stanje je ili sigurnosno kopirano ili sigurno reproducibilno.
Kompaktno stablo odluka
Nalaz
Sljedeća radnja
Ne činite još
Stack trace aplikacije u --previous logovima
Popravite aplikaciju/konfiguraciju koju ukazuje greška
Obrišite Minikube klaster
Reason: OOMKilled
Provjerite ograničenja kontejnera i memoriju čvora/Minikubea
Pretpostavite da su svi slučajevi izlaska 137 identični
Ponovljeni neuspjesi liveness/startup sondi
Popravite endpoint, port, tajming ili dizajn startup sonde
Trajno onemogućite svaku provjeru zdravlja
Readiness sonda ne uspijeva, ali kontejner nastavlja raditi
Popravite spremnost ili dostupnost ovisnosti
Dijagnosticirajte to kao uzrok ponovnog pokretanja bez drugih dokaza
ConfigMap/Secret promijenjen, ali stara vrijednost okruženja ostaje
Zamijenite/ponovno pokrenite Pod nakon validacije nove konfiguracije
Očekujte da se varijable okruženja procesa hot-reloadaju
Minikube status/osnovni Podovi nezdravi
Koristite Minikube dijagnostiku i inspekciju resursa klastera
Nastavite beskonačno uređivati jedan Deployment aplikacije
Što ovaj tijek rada ne može garantirati
Lokalni CrashLoopBackOff može otkriti bug u aplikaciji, neuspjeh ovisnosti, grešku sonde, ograničenje resursa, nepodudarnost arhitekture, nedostajuću datoteku, problem s dozvolama ili mnoge druge neuspjehe pokretanja. Niti jedan fiksni slijed naredbi ne može identificirati svaki uzrok bez čitanja stvarnog razloga završetka, Eventa i logova.
Također, popravka koja radi u Minikubeu ne dokazuje automatski spremnost za produkciju. Produkcijski klasteri mogu koristiti različite storage klase, sigurnosne politike, ingress kontrolere, arhitekture čvorova, mrežne politike, kvote resursa, sustave tajni ili vanjske usluge. Minikube je vrijedan za reproduciranje i razumijevanje neuspjeha na razini kontejnera, ali ponašanje specifično za okruženje i dalje se mora testirati tamo gdje će se aplikacija stvarno pokretati.
Konačni popis provjere
Identificirajte točan neuspjeli kontejner i namespace.
Pročitajte Last State, razlog završetka, izlazni kod, broj ponovnih pokretanja i Events.
Koristite kubectl logs --previous za kontejnere koji se brzo ponovno pokreću.
Pretvorite dokaze u jednu specifičnu hipotezu o uzroku.
Popravite konfiguraciju, adresiranje ovisnosti, sonde ili resurse na temelju tih dokaza.
Ponovno pokrenite ili rolloutajte nove Podove kada se vrijednosti ConfigMapa ili Secreta temeljene na okruženju promijene.
Potvrdite stanje Ready i potvrdite da broj ponovnih pokretanja prestaje rasti.
Koristite minikube status i minikube logs samo kada je i zdravlje klastera pod sumnjom.
Ponovno stvorite Minikube samo kada je sam klaster vjerojatni problem i jednokratno stanje je zaštićeno.
Najpouzdaniji način za popravak CrashLoopBackOff je tretirati ga kao signal za istragu, a ne kao dijagnozu. U zdravom procesu otklanjanja grešaka, svaka naredba sužava uzrok: stanje Poda vam govori što se ponovno pokreće, prethodni logovi vam govore zašto je zadnje pokretanje neuspjelo, manifest i Events pokazuju što je Kubernetes tražio od kontejnera da učini, a Minikube dijagnostika vam govori je li lokalni klaster sam uključen. Kada se ti slojevi slažu, popravka je obično mnogo manja—i mnogo lakša za provjeru—nego brisanje i ponovna izgradnja svega.