Etusivu
» Perustieto
»
Kuinka korjata Kubernetes CrashLoopBackOff paikallisessa Minikubessa
Kuinka korjata Kubernetes CrashLoopBackOff paikallisessa Minikubessa
Tavoitteena ei ole vain saada CrashLoopBackOff häviämään hetkeksi. Hyvä korjaus pitää kontin käynnissä, varmistaa, että Pod on Ready-tilassa, kun sen pitäisi vastaanottaa liikennettä, pysäyttää uudelleenkäynnistyslaskurin nousun ja tuottaa lokit, jotka osoittavat normaalin sovelluksen käynnistymisen. Paikallisessa Minikubessa sinun tulisi myös varmistaa, että Minikube-klusteri itsessään on kunnossa ennen sen uudelleenrakentamista.
Kubernetesin nykyinen dokumentaatio kuvaa CrashLoopBackOff:n backoff-tilana, joka ilmenee, kun kontti käynnistyy toistuvasti, epäonnistuu ja käynnistetään uudelleen. Kubernetes viivästyttää asteittain lisäkäynnistyksiä tiukan vikasyklin välttämiseksi. Tunniste on siis oire toistuvasta kontin epäonnistumisesta, ei itsessään juurisyy. Katso Kubernetes Pod-lifecycle -dokumentaatio.
Tämä opas käyttää neljää diagnostista vaihetta. Seuraa niitä järjestyksessä ja lopeta, kun olet tunnistanut ja korjannut todellisen syyn. Minikube on tarkoitettu paikalliseen oppimiseen ja kehitykseen, joten sama sovellustason diagnosointi siirtyy muihin Kubernetes-klustereihin, kun taas Minikube-kohtaiset palautusvaiheet eivät välttämättä päde tuotantoon. Katso nykyinen Minikube start -dokumentaatio.
Miltä onnistunut korjaus näyttää?
Käytä havainnoitavia merkkejä yksittäisen vihreän statusrivin sijaan:
Kärsinyt kontti pysyy käynnissä tarpeeksi kauan suorittaakseen normaalin käynnistymisen.
Podista tulee Ready, jos sen odotetaan palvelevan liikennettä.
Uudelleenkäynnistyslaskuri lakkaa kasvamasta havaintojakson aikana.
kubectl logs näyttää normaalin käynnistyspolun sen sijaan, että sama vakava virhe toistuisi.
Liveness- ja startup-tutkat, jos ne on määritetty, lakkaavat epäonnistumasta.
Sovellus pystyy tavoittamaan palvelut tai riippuvuudet, joita se todella tarvitsee.
minikube status näyttää terveen paikallisen klusterin, kun klusterin kunto oli epäilyksen alainen.
Älä vaadi olemassa olevan Podin uudelleenkäynnistyslaskurin palaamaan nollaan. Kubernetes tallentaa, kuinka monta kertaa kontti on käynnistynyt uudelleen kyseisessä Podissa; onnistunut korjaus voi jättää nollasta poikkeavan historiallisen laskurin. Tärkeintä on, että laskuri lakkaa kasvamasta. Jos Deployment-julkaisu luo uuden Podin, tuo uusi Pod käynnistyy normaalisti omalla uudella uudelleenkäynnistyslaskurillaan.
Vaihe 1: Todista, mikä kontti kaatuu
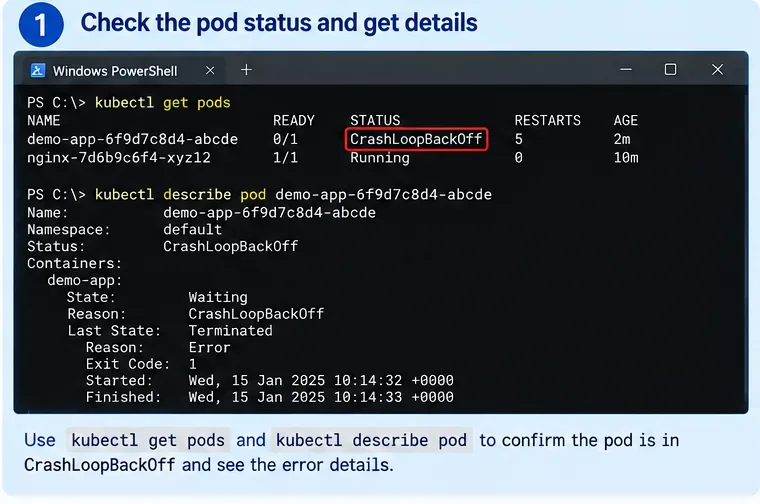
AI-generoitu kuvitus Kubernetes-vianetsintäpäätteestä. Nimet, päivämäärät ja tuloste ovat esimerkkejä, eivät kuvakaappaus oikeasta Minikube-klusterista.
Aloita Pod-luettelosta:
kubectl get pods -A
Jos avaruuden nimi (namespace) on jo tiedossa, rajaa komentoa:
kubectl get pods -n my-namespace
Kuvaile sitten kärsinyt Pod:
kubectl describe pod <pod-name> -n <namespace>
Tarkista neljä kenttää konttiosiossa:
State — kontti voi tällä hetkellä olla Waiting-tilassa syynä CrashLoopBackOff.
Last State — usein Terminated, mikä kertoo, mitä tapahtui edellisessä suorituksessa.
Reason and Exit Code — hyödyllisiä vihjeitä, kuten Error tai OOMKilled.
Restart Count ja Events — todisteet siitä, että vika toistuu ja ovatko tutkat tai kubelet-toiminnot osallisina.
Hienovarainen mutta hyödyllinen ero: Podin yleinen phase voi edelleen olla Running, vaikka yksi sen konteista odottaa CrashLoopBackOff-tilassa. kubectl get pods -komennon tulostama STATUS-sarake on kätevä ihmisen luettava yhteenveto, ei täydellinen diagnoosi Podin elinkaaren tilasta.
Laadun tarkistus: tämän vaiheen lopussa sinun tulisi tietää tarkka Pod, avaruus ja kontti, joka käynnistyy uudelleen. Jos Podissa on useita kontteja, tunnist mikä niistä epäonnistuu ennen lokien lukemista.
Jos vika ei todellisuudessa ole CrashLoopBackOff
Älä pakota jokaista käynnistysongelmaa tähän oppaaseen. ImagePullBackOff, ErrImagePull, Pending ja ContainerCreating viittaavat eri vikaantumisen vaiheisiin. Esimerkiksi kuvan latausongelma tapahtuu ennen sovellusprosessin käynnistymistä, joten sovelluslokeja ei välttämättä ole vielä olemassa.
Vaihda lähestymistapaa, kun: Events-osio viittaa kuvan lataamiseen, tilan liittämiseen, ajoitukseen tai hyväksyntävirheisiin sen sijaan, että kontti käynnistyisi ja poistuisi.
Vaihe 2: Lue epäonnistuneen kontin nykyiset ja edelliset lokit
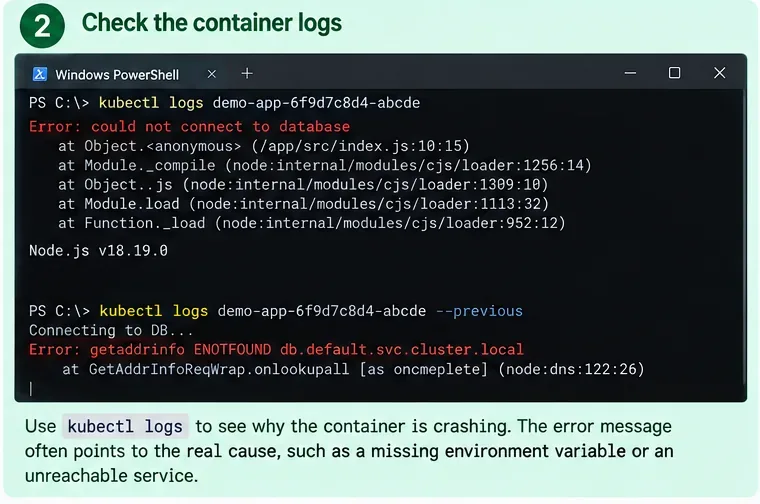
AI-generoitu kuvitus nykyisistä ja edellisistä kontin lokeista. Virheilmoitukset ovat esimerkkejä diagnostisen työnkulun demonstroimiseksi.
Yhden kontin Podissa aloita:
kubectl logs <pod-name> -n <namespace>
Kun kontti käynnistyy uudelleen nopeasti, hyödyllisin komento on usein:
kubectl logs <pod-name> -n <namespace> --previous
Kubernetes dokumentoi --previous:n vaihtoehdoksi, joka tulostaa lokit kontin edellisestä instanssista Podissa. Jos Pod sisältää useamman kuin yhden kontin, määritä epäonnistunut:
Luokittele ensimmäinen merkityksellinen vakava virhe keskittymättä viimeiseen “process exited” -rivin. Tyypillisiä kuvioita ovat:
Todiste
Luultava suunta
Mitä testata seuraavaksi
Pinon seuranta ja exit code 1
Sovellus- tai käynnistyskonfiguraatiovirhe
Tarkista komento, argumentit, ympäristö, tiedostot ja riippuvuuksien osoitteet
Reason: OOMKilled
Kontti ylitti muistirajansa tai se tapettiin muistipaineen vuoksi
Tarkista rajat, sovelluksen muistinkäyttö ja Minikube/solmun kapasiteetti
Liveness- tai startup-tutkien epäonnistumiset Eventsissä
Terveystarkistus epäonnistuu ennen tai jälkeen käynnistymisen
Testaa tutkan polku, portti, ajoitus ja käynnistyskesto
DNS- tai yhteysvirhe toiseen palveluun
Väärä palvelun nimi, avaruus, portti tai riippuvuuden valmius
Tarkista Service-oliot ja klusterinsisäinen DNS
Puuttuva tiedosto, avain tai ympäristömuuttuja
ConfigMap-, Secret-, mount- tai manifestivirhe
Vertaa Deploymentia viitattuihin objekteihin
Laadun tarkistus: sinun tulisi pystyä esittämään falsifioitava hypoteesi, kuten “sovellus poistuu, koska DATABASE_HOST osoittaa olemattomaan Serviceen”, ei pelkästään “Kubernetes on rikki”.
Älä pidä exit code 137:ää yksinään todisteena OOM:sta
Exit code 137 esiintyy usein, kun prosessi vastaanottaa SIGKILL-signaalin, mutta vahvempi Kubernetes-kohtainen signaali on Last State: Terminated yhdessä Reason: OOMKilled:n kanssa. Kubernetesin resurssinhallintadokumentaatio näyttää tämän yhdistelmän, kun kontti ylittää muistirajansa. Katso Kubernetesin resurssinhallintadokumentaatio.
AI-generoitu YAML-kuvitus, joka näyttää esimerkkikonfiguraatiokorjauksen. Kenttäarvot ovat havainnollistavia ja ne on mukautettava todelliseen työmäärään.
Kun tiedät miksi kontti poistuu, muuta pienin asia, joka käsittelee tuota syytä. Podin toistuva uudelleenkäynnistys ei korjaa virheellistä komentoa, puuttuvaa konfiguraatiota, epäonnistuvaa terveystarkistusta tai riittämätöntä muistia.
Tapaus A: sovellus yrittää tavoittaa toisen palvelun localhostissa
Normaalissa Kubernetes Podissa saman Podin kontit jakavat verkkonimiavaruuden ja voivat kommunikoida keskenään localhostin kautta. Toisessa Podissa olevaan tietokantaan ei päästä sovelluksen localhostin kautta. Kubernetes luo DNS-nimiä Serviceille, jotta työmäärät voivat löytää ne palvelun nimellä. Katso Kubernetesin verkkoconcepts ja DNS Servicesille ja Podeille.
Jos Service on nimeltään postgres samassa avaruudessa, sovelluksesi voi ehkä käyttää:
DATABASE_HOST=postgres
Avaruuksien välillä käytä avaruuden nimellä tarkennettua nimeä, kuten postgres.data, tai täysin qualified-palvelunimeä, joka sopii klusterisi verkkotunnukseen.
Varmista Service ennen sovelluksen muokkaamista:
kubectl get svc -A
kubectl get endpointslices -n <namespace>
Vaihda lähestymistapaa, kun: Service on olemassa, mutta sillä ei ole käyttökelpoisia backend-päätepisteitä. Tässä tapauksessa asiakkaan isäntänimen korjaaminen ei riitä; diagnosoi palvelimen Deployment tai Service-valitsin.
Tapaus B: ConfigMap- tai Secret-arvot ovat vääriä
Tarkista viittaukset työmäärän manifestissa:
kubectl get deployment <name> -n <namespace> -o yaml
kubectl get configmap -n <namespace>
kubectl get secret -n <namespace>
Kubernetes tukee ympäristömuuttujia env:stä, ConfigMapsista ja Secretsista. Hyödyllinen yksityiskohta on, että ympäristömuuttujina kulutettuja ConfigMap-arvoja ei päivitetä jo käynnissä olevaan prosessiin, kun ConfigMap muuttuu; Pod on korvattava. Sama pätee ympäristömuuttujina kulutettuihin Secret-arvoihin. Katso Kubernetes ConfigMap -dokumentaatio ja Kubernetes Secret-injektiodokumentaatio.
Deploymentissa konfiguraation korjaamisen jälkeen rollout restart on yksi tapa luoda uusia Podeja:
Laadun tarkistus: varmista, että uusi Pod todella käyttää tarkoitettua arvoa. Älä oleta olettaen, että ConfigMapin muokkaaminen muuttaa välittömästi ympäristömuuttujan olemassa olevan kontin sisällä.
Tapaus C: liveness- tai startup-tutka tappaa hitaan sovelluksen
Kubernetes määrittelee kolme tutkatyyppiä eri tarkoituksilla:
Startup-tutka: määrittää, onko sovelluksen käynnistyminen valmis. Kun se on aktiivinen, liveness- ja readiness-tutkat odottavat.
Liveness-tutka: määrittää, milloin Kubernetesin pitäisi käynnistää jumissa oleva tai epäterve kontti uudelleen.
Readiness-tutka: määrittää, pitäikö Podin vastaanottaa liikennettä Servicejen kautta.
Yleinen väärinkäsitys on, että epäonnistunut readiness-tutka aiheuttaa uudelleenkäynnistyksen. Ei aiheuta. Readiness-epäonnistuminen tekee Podista ei-valmiin; toistuvat liveness- tai startup-tutkien epäonnistumiset voivat aiheuttaa kontin uudelleenkäynnistyksiä. Katso Kubernetesin tutkaconcepts ja virallinen tutkakonfiguraatio-opas.
Jos sovellus tarvitsee oikeutetusti pitkän käynnistymisen, harkitse startup-tutkaa, jossa on tarpeeksi failureThreshold × periodSeconds -aikaa kattamaan realistinen käynnistyminen. Älä yksinkertaisesti poista kaikkia tutkoja käytöstä saadaksesi statuksen näyttämään vihreältä; se poistaa hyödyllisen terveydensuojan.
Laadun tarkistus: tutkan tulisi testata ehtoa, joka heijastaa sen tarkoitusta, ja sovelluksen tulisi selviytyä normaalista käynnistymisestä tulematta tapetuksi ennenaikaisesti.
Tapaus D: kontti on OOMKilled
Vertaa ensin kontin muistirajaa sen todellisiin käynnistystarpeisiin. Pieni esimerkki:
Jos Reason: OOMKilled esiintyy ja sovellus oikeutetusti vaatii enemmän kuin määritetty raja, nosta rajaa varovasti tai vähennä sovelluksen muistinkäyttöä. Jos Minikube itsessään on muistipulassa, vain konttirajan nostaminen voi siirtää ongelman solmulle.
Nykyinen Minikube-dokumentaatio sanoo, että standardi paikallinen asennus odottaa vähintään 2 CPU:ta, 2 GB vapaata muistia ja 20 GB vapaata levytilaa. Minikube tukee myös määritetyn klusterimuistin muuttamista, mikä vaatii uudelleenkäynnistyksen. Katso Minikuben nykyiset start-vaatimukset.
Vaihda lähestymistapaa, kun: useat epäliittyvät Podit epäonnistuvat tai evakuoidaan, tai Minikube itsessään on epäterve. Se viittaa yhden Deploymentin muistirajan ulkopuolelle.
Vaihe 4: Varmista vakaus ja päätä, onko ongelma klusteritasolla
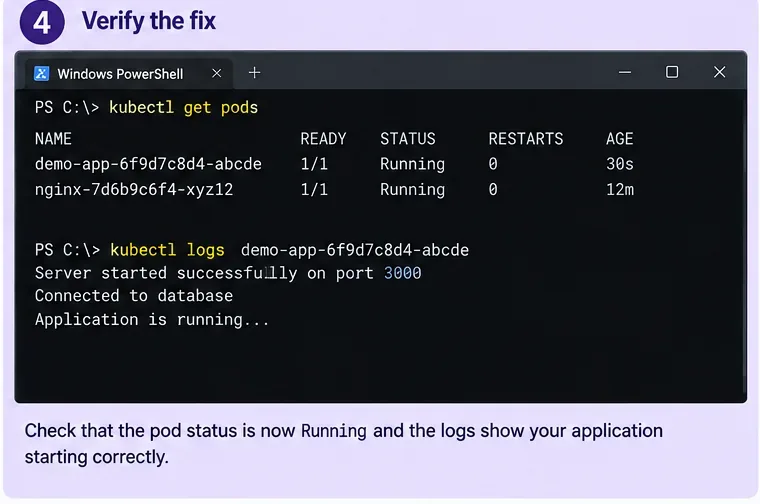
AI-generoitu varmistusesimerkki. Todellinen korjaus tulisi vahvistaa omasta Pod-tilasta, uudelleenkäynnistyslaskurista, tutkista, lokeista ja sovelluskäyttäytymisestä.
Korjauksen soveltamisen jälkeen seuraa työmäärää äläkä tarkista sitä vain kerran:
kubectl get pods -n <namespace> -w
Deploymentille:
kubectl rollout status deployment/<name> -n <namespace>
Lue sitten uudet lokit:
kubectl logs <new-pod-name> -n <namespace>
Vahva onnistumisen merkki ei ole yksinkertaisesti STATUS=Running. Varmista kaikki nämä soveltuvin osin:
READY saavuttaa odotetun arvon, kuten 1/1.
Uudelleenkäynnistyslaskuri pysyy muuttumattomana, kun seuraat normaalia käynnistymistä ja liikennettä.
Uusia BackOff-, tutkaepäonnistumis- tai OOM-tapahtumia ei ilmesty.
Sovelluslokit näyttävät onnistuneen alustuksen.
Service tai paikallinen pääsyreitti todella tavoittaa sovelluksen.
Jos sovellus epäonnistuu edelleen, tarkista onko Minikube itsessään terve
Suorita:
minikube status
kubectl get pods -A
Minikuben status-komento raportoi paikallisen klusterin tilan, mukaan lukien isäntä, kubelet, API-palvelin ja kubeconfig-tila. Katso virallinen minikube status -viite.
Jos kontrollitaso tai ydinjärjestelmän Podit ovat epäterveitä, kerää klusteridiagnostiikka:
minikube logs --problems
minikube logs
Minikuben dokumentaatio on selkeä siitä, että minikube logs on paikallisen Kubernetes-klusterin debuggaamiseen, ei käyttäjän sovelluskoodiin. Käytä kubectl logs sovelluskontille ja minikube logs, kun klusteri tai solmu itsessään on epäilyttävä. Katso nykyinen minikube logs -viite ja Minikube vianetsintäohjeet.
Vaihda lähestymistapaa, kun: Kubernetesin ydinosa-aineet epäonnistuvat, API-palvelin ei ole saatavilla, Minikube status on epäterve tai monet epäliittyvät työmäärät epäonnistuvat yhtä aikaa. Siihen mennessä yhden Deploymentin muokkaaminen ei todennäköisesti ratkaise taustalla olevaa ongelmaa.
Pitääkö Minikube-klusteri poistaa ja luoda uudelleen?
Vasta kun olet erottanut sovellusongelman klusteriongelmasta. Paikallisen kehitysklusterin uudelleenluominen voi olla järkevää, kun klusteri on kertakäyttöinen, manifestisi ovat toistettavia ja Minikube itsessään on vioittunut tai väärin konfiguroitu. Se on huono ensireaktio sovellukseen, joka poistuu selkeällä pinon seurannalla.
Komennot kuten minikube delete poistavat paikallisen klusterin. Se voi myös poistaa paikallista Kubernetes-tilaa ja dataa, jonka odotit säilyttäväsi. Älä käytä poistoa diagnostisena pikakelauksena, kun persistent volume, paikallinen tietokanta tai manuaalisesti luotu resurssi sisältää ainoan kopion jostain tärkeästä.
Laadukynnys klusterin uudelleenluontiin siirtymiselle: olet vahvistanut, että epäonnistumista ei selitä työmäärän komento, konfiguraatio, riippuvuus, tutkat tai resurssirajat; Minikuben kunto on epänormaali; ja paikallinen tila on joko varmuuskopioitu tai turvallisesti toistettavissa.
Tiivis päätöspuu
Havainto
Seuraava toimenpide
Älä tee vielä
Sovelluksen pinon seuranta --previous-lokeissa
Korjaa virheen osoittama sovellus/konfiguraatio
Poista Minikube-klusteri
Reason: OOMKilled
Tarkista konttirajat ja solmun/Minikuben muisti
Oleta kaikkien exit 137 -tapauksien olevan identtisiä
Korjaa päätepiste, portti, ajoitus tai startup-tutkan suunnittelu
Poista kaikki terveystarkastukset pysyvästi
Readiness-tutka epäonnistuu, mutta kontti jatkaa toimintaansa
Korjaa readiness tai riippuvuuden saatavuus
Diagnosoi se uudelleenkäynnistyksen syyksi ilman muita todisteita
ConfigMap/Secret muuttui, mutta vanha env-arvo säilyy
Korvaa/käynnistä Pod uudelleen uuden konfiguraation validoinnin jälkeen
Oleta prosessin ympäristömuuttujien latautuvan uudelleen lennossa
Minikube status/ydin Podit epäterveitä
Käytä Minikube-diagnostiikkaa ja tutki klusteriresursseja
Jatka yhden sovellusDeploymentin muokkaamista loputtomiin
Mitä tämä työnkulku ei voi taata
Paikallinen CrashLoopBackOff voi paljastaa sovellusvirheen, riippuvuusvirheen, tutkavirheen, resurssirajan, arkkitehtuurin epäsovinnaisuuden, puuttuvan tiedoston, käyttöoikeusongelman tai monia muita käynnistysvirheitä. Mikään kiinteä komentosekvenssi ei voi tunnistaa jokaista syytä lukematta todellista lopetussyytä, Events-tapahtumia ja lokeja.
Lisäksi Minikubessa toimiva korjaus ei automaattisesti todista tuotantovalmiutta. Tuotantoklusterit voivat käyttää eri storage classseja, tietoturvakäytäntöjä, ingress-ohjaimia, solmuarkkitehtuureja, verkkokäytäntöjä, resurssikiintiöitä, salausjärjestelmiä tai ulkoisia palveluita. Minikube on arvokas konttitason vian toistamiseen ja ymmärtämiseen, mutta ympäristökohtainen käyttäytyminen on silti testattava siellä, missä sovellus todella tulee toimimaan.
Lopullinen tarkistuslista
Tunnista tarkka epäonnistuva kontti ja avaruus.
Lue Last State, lopetussyy, exit code, uudelleenkäynnistyslaskuri ja Events.
Käytä kubectl logs --previous nopeasti uudelleenkäynnistyville konteille.
Muuta todisteet yhdeksi spesifiksi juurisyyhypoteesiksi.
Korjaa konfiguraatio, riippuvuuksien osoittaminen, tutkat tai resurssit näiden todisteiden perusteella.
Käynnistä uudelleen tai julkaise uudet Podit, kun ympäristöön perustuvat ConfigMap- tai Secret-arvot muuttuvat.
Varmista Ready-tila ja vahvista, että uudelleenkäynnistyslaskuri lakkaa kasvamasta.
Käytä minikube status ja minikube logs vain, kun klusterin kunto on myös epäilyttävä.
Luo Minikube uudelleen vain, kun klusteri itsessään on todennäköinen ongelma ja kertakäyttöinen tila on suojattu.
Luotettavin tapa korjata CrashLoopBackOff on käsitellä sitä tutkittavana signaalina, ei diagnoosina. Terveessä vianetsintäprosessissa jokainen komento kaventaa syytä: Pod-tila kertoo, mikä käynnistyy uudelleen, edelliset lokit kertovat, miksi viimeinen suoritus epäonnistui, manifesti ja Events näyttävät, mitä Kubernetes pyysi konttia tekemään, ja Minikube-diagnostiikka kertoo, onko paikallinen klusteri itse osallisena. Kun nämä kerrokset ovat yhtä mieltä, korjaus on yleensä paljon pienempi – ja paljon helpompi varmistaa – kuin kaiken poistaminen ja uudelleenrakentaminen.