Αρχική
» ΒΑΣΙΚΕΣ ΓΝΩΣΕΙΣ
»
Πώς να διορθώσετε το CrashLoopBackOff του Kubernetes στο τοπικό Minikube
Πώς να διορθώσετε το CrashLoopBackOff του Kubernetes στο τοπικό Minikube
Ο στόχος δεν είναι απλώς να εξαφανιστεί το CrashLoopBackOff για μερικά δευτερόλεπτα. Μια καλή διόρθωση αφήνει το container να εκτελείται, κρατά το Pod σε κατάσταση Ready όταν πρέπει να λαμβάνει κίνηση, σταματά την αύξηση του αριθμού επανεκκινήσεων και παράγει logs που δείχνουν μια φυσιολογική εκκίνηση της εφαρμογής. Στο τοπικό Minikube, θα πρέπει επίσης να επιβεβαιώσετε ότι το ίδιο το cluster του Minikube είναι υγιές πριν το ξαναδημιουργήσετε.
Η τρέχουσα τεκμηρίωση του Kubernetes περιγράφει το CrashLoopBackOff ως μια συνθήκη backoff που εμφανίζεται όταν ένα container ξεκινά επανειλημμένα, αποτυγχάνει και επανεκκινείται. Το Kubernetes καθυστερεί προοδευτικά τις επιπλέον επανεκκινήσεις για να αποφύγει έναν στενό βρόχο αποτυχίας. Η ετικέτα είναι επομένως ένα σύμπτωμα επαναλαμβανόμενης αποτυχίας του container, και όχι η αιτία ρίζα από μόνη της. Δείτε την τεκμηρίωση του κύκλου ζωής των Pod του Kubernetes.
Αυτός ο οδηγός χρησιμοποιεί τέσσερις διαγνωστικές φάσεις. Ακολουθήστε τις με τη σειρά και σταματήστε όταν έχετε εντοπίσει και διορθώσει την πραγματική αιτία. Το Minikube προορίζεται για τοπική μάθηση και ανάπτυξη, οπότε η ίδια διάγνωση σε επίπεδο εφαρμογής μεταφέρεται σε άλλα clusters Kubernetes, ενώ τα βήματα ανάκτησης ειδικά για το Minikube δεν ισχύουν απαραίτητα για το production. Δείτε την τρέχουσα τεκμηρίωση εκκίνησης του Minikube.
Πώς μοιάζει μια επιτυχημένη διόρθωση;
Χρησιμοποιήστε παρατηρήσιμα σημάδια αντί για μια μοναδική πράσινη γραμμή κατάστασης:
Το επηρεαζόμενο container παραμένει σε κατάσταση εκτέλεσης αρκετά μεγάλο χρονικό διάστημα για να ολοκληρώσει την κανονική εκκίνηση.
Το Pod γίνεται Ready αν αναμένεται να εξυπηρετεί κίνηση.
Ο αριθμός επανεκκινήσεων σταματά να αυξάνεται κατά τη διάρκεια της παρατήρησής σας.
Τα kubectl logs δείχνουν μια φυσιολογική πορεία εκκίνησης αντί για την επανάληψη του ίδιου θανατηφόρου σφάλματος.
Οι probes liveness και startup, αν έχουν διαμορφωθεί, σταματούν να αποτυγχάνουν.
Η εφαρμογή μπορεί να φτάσει στις υπηρεσίες ή τις εξαρτήσεις που πραγματικά χρειάζεται.
Η εντολή minikube status δείχνει ένα υγιές τοπικό cluster όταν η υγεία του cluster ήταν υπό αμφισβήτηση.
Μην απαιτείτε ο μετρητής επανεκκινήσεων ενός υπάρχοντος Pod να επιστρέψει στο μηδέν. Το Kubernetes καταγράφει πόσες φορές έχει επανεκκινήσει το container σε αυτό το Pod. μια επιτυχημένη επισκευή μπορεί να αφήσει έναν μη μηδενικό ιστορικό αριθμό. Αυτό που έχει σημασία είναι ότι ο αριθμός σταματά να αυξάνεται. Αν μια κυκλοφορία Deployment δημιουργήσει ένα νέο Pod, αυτό το νέο Pod ξεκινά κανονικά με τον δικό του φρέσκο αριθμό επανεκκινήσεων.
Φάση 1: Αποδείξτε ποιο container καταρρέει
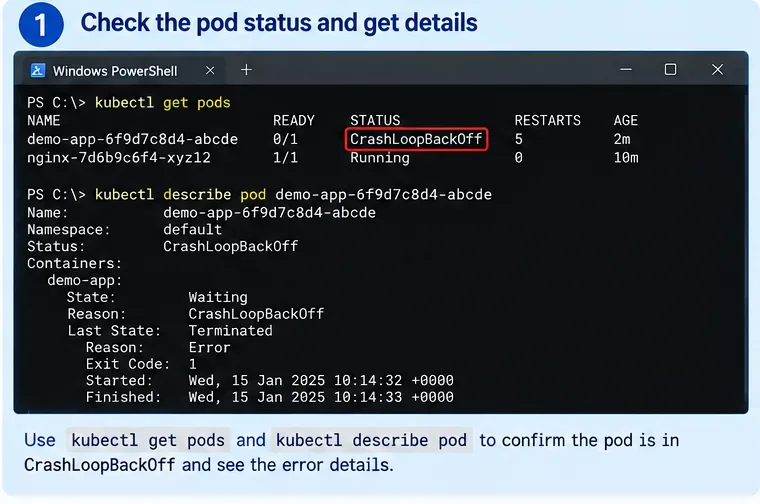
Εικονογράφηση AI τερματικού αποσφαλμάτωσης Kubernetes. Τα ονόματα, οι ημερομηνίες και η έξοδος είναι παραδείγματα, όχι στιγμιότυπο οθόνης από ένα πραγματικό cluster Minikube.
Ξεκινήστε με τη λίστα των Pod:
kubectl get pods -A
Αν γνωρίζετε ήδη το namespace, περιορίστε την εντολή:
kubectl get pods -n my-namespace
Στη συνέχεια, περιγράψτε το επηρεαζόμενο Pod:
kubectl describe pod <pod-name> -n <namespace>
Κοιτάξτε τέσσερα πεδία στην ενότητα του container:
State — Το container μπορεί επί του παρόντος να είναι σε κατάσταση Waiting με λόγο CrashLoopBackOff.
Last State — Συχνά Terminated, το οποίο σας λέει τι συνέβη στην προηγούμενη εκτέλεση.
Reason and Exit Code — Χρήσιμες ενδείξεις όπως Error ή OOMKilled.
Restart Count και Events — Αποδείξεις ότι η αποτυχία επαναλαμβάνεται και αν εμπλέκονται probes ή ενέργειες του kubelet.
Μια λεπτή αλλά χρήσιμη διάκριση: η συνολική φάση του Pod μπορεί ακόμα να είναι Running ενώ ένα από τα containers του περιμένει σε κατάσταση CrashLoopBackOff. Η στήλη STATUS που εκτυπώνεται από το kubectl get pods είναι μια βολική περίληψη αναγνώσιμη από τον άνθρωπο, όχι μια πλήρης διάγνωση της κατάστασης του κύκλου ζωής του Pod.
Έλεγχος ποιότητας: στο τέλος αυτής της φάσης, θα πρέπει να γνωρίζετε το ακριβές Pod, το namespace και το container που επανεκκινείται. Αν το Pod έχει πολλαπλά containers, εντοπίστε ποιο αποτυγχάνει πριν διαβάσετε τα logs.
Αν η αποτυχία δεν είναι πραγματικά CrashLoopBackOff
Μην προσπαθείτε να χωρέσετε κάθε πρόβλημα εκκίνησης σε αυτόν τον οδηγό. Τα ImagePullBackOff, ErrImagePull, Pending και ContainerCreating δείχνουν σε διαφορετικά στάδια αποτυχίας. Για παράδειγμα, ένα πρόβλημα λήψης εικόνας συμβαίνει πριν ξεκινήσει η διαδικασία της εφαρμογής σας, οπότε τα logs της εφαρμογής μπορεί να μην υπάρχουν ακόμα.
Αλλάξτε προσέγγιση όταν: η ενότητα Events δείχνει σε λήψη εικόνας, προσάρτηση όγκου, δρομολόγηση ή σφάλματα εισδοχής αντί για ένα container που ξεκινά και εξέρχεται.
Φάση 2: Διαβάστε τα τρέχοντα και τα προηγούμενα logs του αποτυχημένου container
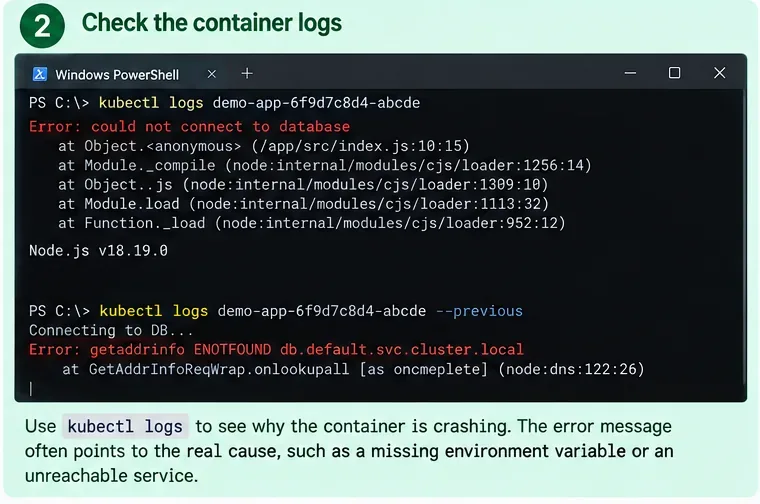
Εικονογράφηση AI τρεχόντων και προηγούμενων logs container. Τα μηνύματα σφάλματος είναι παραδείγματα που χρησιμοποιούνται για την επίδειξη της ροής εργασίας διάγνωσης.
Για ένα Pod με μονό container, ξεκινήστε με:
kubectl logs <pod-name> -n <namespace>
Όταν το container επανεκκινείται γρήγορα, η πιο χρήσιμη εντολή είναι συχνά:
kubectl logs <pod-name> -n <namespace> --previous
Το Kubernetes τεκμηριώνει το --previous ως την επιλογή που εκτυπώνει logs από την προηγούμενη περίπτωση του container στο Pod. Αν το Pod περιέχει περισσότερα από ένα container, καθορίστε αυτό που αποτυγχάνει:
Κατατάξτε το πρώτο ουσιαστικό θανατηφόρο σφάλμα αντί να εστιάσετε στην τελική γραμμή “process exited”. Τα τυπικά μοτίβα περιλαμβάνουν:
Απόδειξη
Πιθανή κατεύθυνση
Τι να ελέγξετε στη συνέχεια
Stack trace συν exit code 1
Σφάλμα εφαρμογής ή διαμόρφωσης εκκίνησης
Ελέγξτε εντολή, ορίσματα, περιβάλλον, αρχεία και διευθύνσεις εξαρτήσεων
Reason: OOMKilled
Το container ξεπέρασε το όριο μνήμης του ή σκοτώθηκε λόγω πίεσης μνήμης
Επιθεωρήστε όρια, χρήση μνήμης εφαρμογής και χωρητικότητα Minikube/κόμβου
Αποτυχίες liveness ή startup probe στα Events
Ο έλεγχος υγείας αποτυγχάνει πριν ή μετά την εκκίνηση
Δοκιμάστε τη διαδρομή probe, τη θύρα, τον χρόνο και τη διάρκεια εκκίνησης
Σφάλμα DNS ή σύνδεσης σε άλλη υπηρεσία
Λάθος όνομα υπηρεσίας, namespace, θύρα ή ετοιμότητα εξάρτησης
Επιθεωρήστε αντικείμενα Service και DNS εντός cluster
Λείπον αρχείο, κλειδί ή μεταβλητή περιβάλλοντος
Ασυμφωνία ConfigMap, Secret, προσάρτησης ή manifest
Συγκρίνετε το Deployment με τα αναφερόμενα αντικείμενα
Έλεγχος ποιότητας: θα πρέπει να μπορείτε να διατυπώσετε μια ψευδοποιήσιμη υπόθεση όπως “η εφαρμογή εξέρχεται επειδή το DATABASE_HOST δείχνει σε μια μη υπάρχουσα Service”, και όχι απλώς “το Kubernetes είναι χαλασμένο”.
Μην θεωρείτε το exit code 137 μόνο ως απόδειξη OOM
Ένα exit code 137 εμφανίζεται συχνά όταν μια διαδικασία λαμβάνει SIGKILL, αλλά το ισχυρότερο σήμα ειδικό για το Kubernetes είναι το Last State: Terminated με Reason: OOMKilled. Η τεκμηρίωση διαχείρισης πόρων του Kubernetes δείχνει αυτόν τον συνδυασμό όταν ένα container ξεπερνά το όριο μνήμης του. Δείτε την τεκμηρίωση διαχείρισης πόρων του Kubernetes.
Χρήσιμη ενέργεια: βασίστε τη διάγνωση στον λόγο τερματισμού και στα γύρω Events, όχι στον αριθμό 137 από μόνος του.
Φάση 3: Διορθώστε την αιτία ρίζα, όχι τον χρονοδιακόπτη backoff
Εικονογράφηση AI YAML που δείχνει ένα παράδειγμα διόρθωσης διαμόρφωσης. Οι τιμές των πεδίων είναι ενδεικτικές και πρέπει να προσαρμοστούν στο πραγματικό workload.
Μόλις γνωρίζετε γιατί εξέρχεται το container, αλλάξτε το μικρότερο πράγμα που αντιμετωπίζει αυτή την αιτία. Η επανειλημμένη επανεκκίνηση του Pod δεν επισκευάζει μια κακή εντολή, μια λείπουσα διαμόρφωση, έναν αποτυγχάνοντα έλεγχο υγείας ή ανεπαρκή μνήμη.
Περίπτωση Α: Η εφαρμογή προσπαθεί να φτάσει σε άλλη υπηρεσία στο localhost
Μέσα σε ένα κανονικό Pod του Kubernetes, τα containers σε αυτό το ίδιο Pod μοιράζονται ένα δίκτυο namespace και μπορούν να επικοινωνούν μεταξύ τους μέσω localhost. Μια βάση δεδομένων που εκτελείται σε διαφορετικό Pod δεν προσπελαύνεται μέσω του localhost της εφαρμογής σας. Το Kubernetes δημιουργεί ονόματα DNS για Services ώστε τα workloads να μπορούν να τα ανακαλύψουν με όνομα υπηρεσίας. Δείτε τις έννοιες δικτύωσης του Kubernetes και το DNS για Services και Pods.
Αν η Service σας ονομάζεται postgres στο ίδιο namespace, η εφαρμογή σας μπορεί να μπορεί να χρησιμοποιήσει:
DATABASE_HOST=postgres
Σε διαφορετικά namespaces, χρησιμοποιήστε ένα όνομα με καθορισμένο namespace όπως postgres.data ή το πλήρως καθορισμένο όνομα υπηρεσίας κατάλληλο για τον τομέα του cluster σας.
Επαληθεύστε τη Service πριν επεξεργαστείτε την εφαρμογή:
kubectl get svc -A
kubectl get endpointslices -n <namespace>
Αλλάξτε προσέγγιση όταν: η Service υπάρχει αλλά δεν έχει χρήσιμα endpoints backend. Σε αυτή την περίπτωση, η διόρθωση του hostname του client δεν είναι αρκετή. διαγνώστε το server Deployment ή τον selector της Service.
Περίπτωση Β: Οι τιμές ConfigMap ή Secret είναι λανθασμένες
Επιθεωρήστε τις αναφορές στο manifest του workload:
kubectl get deployment <name> -n <namespace> -o yaml
kubectl get configmap -n <namespace>
kubectl get secret -n <namespace>
Το Kubernetes υποστηρίζει μεταβλητές περιβάλλοντος από env, ConfigMaps και Secrets. Μια χρήσιμη λεπτομέρεια είναι ότι οι τιμές ConfigMap που καταναλώνονται ως μεταβλητές περιβάλλοντος δεν ενημερώνονται σε μια ήδη εκτελούμενη διαδικασία όταν αλλάζει το ConfigMap. Το Pod πρέπει να αντικατασταθεί. Το ίδιο ισχύει για τις τιμές Secret που καταναλώνονται ως μεταβλητές περιβάλλοντος. Δείτε την τεκμηρίωση ConfigMap του Kubernetes και την τεκμηρίωση έγχυσης Secret του Kubernetes.
Για ένα Deployment, μετά τη διόρθωση της διαμόρφωσης, μια επανεκκίνηση κυκλοφορίας είναι ένας τρόπος δημιουργίας νέων Pods:
Έλεγχος ποιότητας: επαληθεύστε ότι το νέο Pod χρησιμοποιεί πραγματικά την επιθυμητή τιμή. Μην υποθέτετε ότι η επεξεργασία ενός ConfigMap αλλάζει άμεσα μια μεταβλητή περιβάλλοντος μέσα σε ένα υπάρχον container.
Περίπτωση Γ: Ένα liveness ή startup probe σκοτώνει μια αργή εφαρμογή
Το Kubernetes ορίζει τρεις τύπους probes με διαφορετικούς σκοπούς:
Startup probe: Καθορίζει αν η εκκίνηση της εφαρμογής έχει ολοκληρωθεί. Ενώ είναι ενεργό, τα probes liveness και readiness περιμένουν.
Liveness probe: Καθορίζει πότε το Kubernetes πρέπει να επανεκκινήσει ένα κολλημένο ή μη υγιές container.
Readiness probe: Καθορίζει αν ένα Pod πρέπει να λαμβάνει κίνηση μέσω Services.
Μια κοινή παρεξήγηση είναι ότι μια αποτυχημένη readiness probe προκαλεί επανεκκίνηση. Δεν το κάνει. Μια αποτυχία readiness καθιστά το Pod μη έτοιμο. Επαναλαμβανόμενες αποτυχίες liveness ή startup probe μπορούν να προκαλέσουν επανεκκινήσεις container. Δείτε τις έννοιες probes του Kubernetes και τον επίσημο οδηγό διαμόρφωσης probes.
Αν η εφαρμογή χρειάζεται δικαιολογημένα μια μεγάλη εκκίνηση, εξετάστε ένα startup probe με αρκετό χρόνο failureThreshold × periodSeconds για να καλύψει την ρεαλιστική εκκίνηση. Μην απενεργοποιείτε απλώς όλα τα probes για να φαίνεται η κατάσταση πράσινη. Αυτό αφαιρεί χρήσιμη προστασία υγείας.
Έλεγχος ποιότητας: το probe πρέπει να ελέγχει μια συνθήκη που αντικατοπτρίζει τον σκοπό του, και η εφαρμογή πρέπει να επιβιώνει της φυσιολογικής εκκίνησης χωρίς να σκοτώνεται πρόωρα.
Περίπτωση Δ: Το container είναι OOMKilled
Πρώτα συγκρίνετε το όριο μνήμης του container με τις πραγματικές ανάγκες εκκίνησης. Ένα μικρό παράδειγμα:
Αν εμφανίζεται Reason: OOMKilled και η εφαρμογή δικαιολογημένα απαιτεί περισσότερα από το διαμορφωμένο όριο, αυξήστε το όριο προσεκτικά ή μειώστε τη χρήση μνήμης της εφαρμογής. Αν το ίδιο το Minikube λιμοκοντεί για μνήμη, η αύξηση μόνο του ορίου του container μπορεί απλώς να μετακινήσει το πρόβλημα στον κόμβο.
Η τρέχουσα τεκμηρίωση του Minikube λέει ότι η τυπική τοπική εγκατάσταση αναμένει τουλάχιστον 2 CPUs, 2 GB ελεύθερης μνήμης και 20 GB ελεύθερου χώρου δίσκου. Το Minikube υποστηρίζει επίσης την αλλαγή της διαμορφωμένης μνήμης του cluster, η οποία απαιτεί επανεκκίνηση. Δείτε τις τρέχουσες απαιτήσεις εκκίνησης του Minikube.
Αλλάξτε προσέγγιση όταν: πολλά μη συσχετισμένα Pods αποτυγχάνουν ή εκδιώκονται, ή το ίδιο το Minikube είναι μη υγιές. Αυτό δείχνει πέρα από το όριο μνήμης ενός Deployment.
Φάση 4: Επαληθεύστε τη σταθερότητα και αποφασίστε αν το πρόβλημα είναι σε επίπεδο cluster
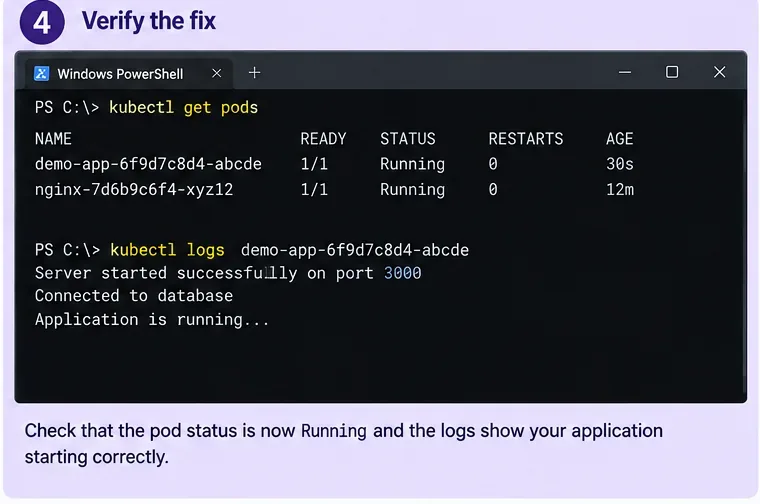
Παράδειγμα επαλήθευσης με εικονογράφηση AI. Μια πραγματική διόρθωση πρέπει να επιβεβαιώνεται από την κατάσταση του Pod σας, τον αριθμό επανεκκινήσεων, τα probes, τα logs και τη συμπεριφορά της εφαρμογής.
Μετά την εφαρμογή της διόρθωσης, παρακολουθήστε το workload αντί να το ελέγξετε μία φορά:
kubectl get pods -n <namespace> -w
Για ένα Deployment:
kubectl rollout status deployment/<name> -n <namespace>
Στη συνέχεια, διαβάστε τα νέα logs:
kubectl logs <new-pod-name> -n <namespace>
Ένα ισχυρό σήμα επιτυχίας δεν είναι απλώς STATUS=Running. Επιβεβαιώστε όλα τα παρακάτω όπου ισχύουν:
Το READY φτάνει την αναμενόμενη τιμή, όπως 1/1.
Ο αριθμός επανεκκινήσεων παραμένει αμετάβλητος ενώ παρατηρείτε φυσιολογική εκκίνηση και κίνηση.
Δεν εμφανίζονται νέα συμβάντα BackOff, αποτυχίας probe ή OOM.
Τα logs της εφαρμογής δείχνουν επιτυχημένη αρχικοποίηση.
Η Service ή η τοπική διαδρομή πρόσβασης φτάνει πραγματικά την εφαρμογή.
Αν η εφαρμογή εξακολουθεί να αποτυγχάνει, ελέγξτε αν το ίδιο το Minikube είναι υγιές
Εκτελέστε:
minikube status
kubectl get pods -A
Η εντολή status του Minikube αναφέρει την κατάσταση του τοπικού cluster, συμπεριλαμβανομένης της κατάστασης του host, του kubelet, του API server και του kubeconfig. Δείτε την επίσημη αναφορά minikube status.
Αν ο control plane ή τα Pods βασικού συστήματος είναι μη υγιή, συλλέξτε διαγνωστικά cluster:
minikube logs --problems
minikube logs
Η τεκμηρίωση του Minikube είναι ρητή ότι το minikube logs προορίζεται για την αποσφαλμάτωση του τοπικού cluster Kubernetes, όχι του κώδικα της εφαρμογής του χρήστη. Χρησιμοποιήστε kubectl logs για το container της εφαρμογής και minikube logs όταν ο ίδιος ο cluster ή ο κόμβος είναι ύποπτος. Δείτε την τρέχουσα αναφορά minikube logs και τις οδηγίες αποσφαλμάτωσης του Minikube.
Αλλάξτε προσέγγιση όταν: βασικές συνιστώσες του Kubernetes αποτυγχάνουν, το API server είναι μη διαθέσιμο, η κατάσταση του Minikube είναι μη υγιής ή πολλά μη συσχετισμένα workloads αποτυγχάνουν ταυτόχρονα. Σε αυτό το σημείο, η συνέχιση της επεξεργασίας ενός Deployment είναι απίθανο να λύσει το υποκείμενο πρόβλημα.
Πρέπει να διαγράψετε και να ξαναδημιουργήσετε το cluster Minikube;
Μόνο αφού έχετε διαχωρίσει ένα πρόβλημα εφαρμογής από ένα πρόβλημα cluster. Η ξαναδημιουργία ενός τοπικού cluster ανάπτυξης μπορεί να είναι λογική όταν το cluster είναι απόρριπτο, τα manifests σας είναι αναπαραγώγιμα και το ίδιο το Minikube είναι κατεστραμμένο ή κακοδιαμορφωμένο. Είναι μια κακή πρώτη αντίδραση σε μια εφαρμογή που εξέρχεται με ένα σαφές stack trace.
Εντολές όπως το minikube delete αφαιρούν το τοπικό cluster. Αυτό μπορεί επίσης να αφαιρέσει τοπική κατάσταση και δεδομένα Kubernetes που περιμένατε να κρατήσετε. Μην χρησιμοποιείτε τη διαγραφή ως συντόμευση διάγνωσης όταν ένας μόνιμος όγκος, μια τοπική βάση δεδομένων ή ένα χειροκίνητα δημιουργημένο πόρο περιέχει το μόνο αντίγραφο κάτι σημαντικού.
Κατώφλι ποιότητας για μετάβαση σε ξαναδημιουργία cluster: έχετε επιβεβαιώσει ότι η αποτυχία δεν εξηγείται από την εντολή, τη διαμόρφωση, την εξάρτηση, τα probes ή τα όρια πόρων του workload. η υγεία του Minikube είναι μη φυσιολογική. και η τοπική κατάσταση είτε έχει αντίγραφο ασφαλείας είτε είναι ασφαλώς αναπαραγώγιμη.
Ένα συμπαγές δέντρο αποφάσεων
Εύρημα
Επόμενη ενέργεια
Μην κάνετε ακόμα
Stack trace εφαρμογής στα logs --previous
Διορθώστε την εφαρμογή/διαμόρφωση που υποδεικνύεται από το σφάλμα
Διαγράψτε το cluster Minikube
Reason: OOMKilled
Ελέγξτε τα όρια του container και τη μνήμη του κόμβου/Minikube
Υποθέστε ότι όλες οι περιπτώσεις exit 137 είναι ίδιες
Διορθώστε το endpoint, τη θύρα, τον χρόνο ή τον σχεδιασμό του startup probe
Απενεργοποιήστε κάθε έλεγχο υγείας μόνιμα
Η readiness probe αποτυγχάνει αλλά το container συνεχίζει να εκτελείται
Διορθώστε την ετοιμότητα ή τη διαθεσιμότητα εξάρτησης
Διαγνώστε το ως αιτία επανεκκίνησης χωρίς άλλες αποδείξεις
Το ConfigMap/Secret άλλαξε αλλά η παλιά τιμή env παραμένει
Αντικαταστήστε/επανεκκινήστε το Pod μετά την επικύρωση της νέας διαμόρφωσης
Περιμένετε οι μεταβλητές περιβάλλοντος διαδικασίας να κάνουν hot-reload
Η κατάσταση Minikube/τα Pods βασικού συστήματος είναι μη υγιή
Χρησιμοποιήστε διαγνωστικά Minikube και επιθεωρήστε τους πόρους του cluster
Συνεχίστε να επεξεργάζεστε ένα app Deployment επ' αόριστον
Τι δεν μπορεί να εγγυηθεί αυτή η ροή εργασίας
Ένα τοπικό CrashLoopBackOff μπορεί να αποκαλύψει ένα σφάλμα εφαρμογής, μια αποτυχία εξάρτησης, ένα λάθος probe, ένα όριο πόρων, μια ασυμφωνία αρχιτεκτονικής, ένα λείπον αρχείο, ένα πρόβλημα δικαιωμάτων ή πολλές άλλες αποτυχίες εκκίνησης. Καμία σταθερή ακολουθία εντολών δεν μπορεί να εντοπίσει κάθε αιτία χωρίς να διαβάσει τον πραγματικό λόγο τερματισμού, τα Events και τα logs.
Επίσης, μια διόρθωση που λειτουργεί στο Minikube δεν αποδεικνύει αυτόματα την ετοιμότητα για production. Τα clusters production μπορεί να χρησιμοποιούν διαφορετικές κλάσεις αποθήκευσης, πολιτικές ασφαλείας, controllers ingress, αρχιτεκτονικές κόμβων, πολιτικές δικτύου, ποσοστώσεις πόρων, συστήματα μυστικών ή εξωτερικές υπηρεσίες. Το Minikube είναι πολύτιμο για την αναπαραγωγή και την κατανόηση της αποτυχίας σε επίπεδο container, αλλά η συμπεριφορά ειδική για το περιβάλλον πρέπει ακόμα να δοκιμάζεται εκεί όπου η εφαρμογή θα εκτελεστεί πραγματικά.
Τελική λίστα ελέγχου
Εντοπίστε το ακριβές αποτυχημένο container και namespace.
Διαβάστε το Last State, τον λόγο τερματισμού, το exit code, τον αριθμό επανεκκινήσεων και τα Events.
Χρησιμοποιήστε kubectl logs --previous για containers που επανεκκινούνται γρήγορα.
Μετατρέψτε τις αποδείξεις σε μία συγκεκριμένη υπόθεση αιτίας ρίζας.
Διορθώστε τη διαμόρφωση, τη διεύθυνση εξάρτησης, τα probes ή τους πόρους με βάση αυτές τις αποδείξεις.
Επανεκκινήστε ή κυκλοφορήστε νέα Pods όταν αλλάζουν τιμές ConfigMap ή Secret βασισμένες σε περιβάλλον.
Επαληθεύστε την κατάσταση Ready και επιβεβαιώστε ότι ο αριθμός επανεκκινήσεων σταματά να αυξάνεται.
Χρησιμοποιήστε minikube status και minikube logs μόνο όταν η υγεία του cluster είναι επίσης ύποπτη.
Ξαναδημιουργήστε το Minikube μόνο όταν ο ίδιος ο cluster είναι η πιθανή αιτία του προβλήματος και η απόρριπτη κατάσταση είναι προστατευμένη.
Ο πιο αξιόπιστος τρόπος για να διορθώσετε το CrashLoopBackOff είναι να το αντιμετωπίσετε ως σήμα για έρευνα, και όχι ως τη διάγνωση. Σε μια υγιή διαδικασία αποσφαλμάτωσης, κάθε εντολή περιορίζει την αιτία: η κατάσταση του Pod σας λέει τι επανεκκινείται, τα προηγούμενα logs σας λένε γιατί η τελευταία εκτέλεση απέτυχε, το manifest και τα Events δείχνουν τι ζήτησε το Kubernetes από το container να κάνει, και τα διαγνωστικά του Minikube σας λένε αν ο ίδιος ο τοπικός cluster εμπλέκεται. Μόλις αυτά τα επίπεδα συμφωνήσουν, η διόρθωση είναι συνήθως πολύ μικρότερη—και πολύ πιο εύκολη για επαλήθευση—από το να διαγράψετε και να ξαναχτίσετε τα πάντα.